
Xử lý số liệu SPSS gồm một chuỗi bước làm sạch dữ liệu theo đúng trình tự, từ chuẩn bị tập dữ liệu và kiểm tra biến tới xử lý giá trị ngoài khoảng, giá trị ngoại lai và giá trị thiếu, trước khi chạy bất kỳ thống kê nào. Bài viết này sẽ hướng dẫn bạn làm sạch bộ số liệu khảo sát cho khoá luận hay luận văn theo từng bước, biết cách phát hiện từng loại lỗi trong SPSS, chọn cách xử lý có thể giải trình trước giảng viên hướng dẫn và hội đồng, rồi chuyển sang bước thống kê mô tả.
Tác giả: Ban Biên tập MAAS
Cập nhật lần cuối: 2026-09-21
Chuyên mục: research-methods
Xử lý số liệu SPSS là gì, gồm những bước nào?
Trả lời thẳng: Xử lý số liệu SPSS là bước chuẩn bị dữ liệu trước phân tích, đi từ kiểm tra định dạng cột đến việc gọi tên đúng bốn nhóm việc cần làm, đó là dọn lỗi cấu trúc, dọn giá trị ngoài khoảng, dọn ngoại lai và dọn giá trị thiếu. Không kiểm định nào trong SPSS nên chạy trước khi bốn nhóm việc này hoàn tất.
Weber (n.d.), trong hướng dẫn của Baylor University Libraries, mô tả làm sạch dữ liệu là quá trình chuẩn bị dữ liệu cho phân tích. Quá trình đó gồm kiểm tra dữ liệu nằm đúng cột và đúng trường, loại những ca không đầy đủ, phát hiện và xoá dữ liệu trùng hoặc cột không cần, sửa lỗi định dạng và chính tả, xử lý dữ liệu thiếu, gán nhãn chữ cho những biến được mã hoá bằng số, tái mã hoá biến, và nếu cần thì xoá thông tin nhận dạng cá nhân khỏi tập dữ liệu. EZ SPSS Tutorials (2023) gom các kỹ thuật làm sạch dữ liệu phổ biến trên SPSS thành bốn nhóm, gồm lỗi cấu trúc, giá trị ngoài khoảng, giá trị ngoại lai và giá trị thiếu, và cách chia này là khung cho phần còn lại của bài. Sau khi dữ liệu đã sạch, phân tích nhân tố khám phá EFA là một trong các phân tích bạn có thể chạy tiếp. Với hai biến định lượng, tương quan Pearson là một bước phân tích khác trên dữ liệu đã làm sạch.
Lấy một tập dữ liệu khảo sát 200 sinh viên làm ví dụ. Trong đó có thể có vài ca ghi tuổi là "0" do lỗi nhập liệu, vài ô trống ở câu hỏi thu nhập gia đình, và một biến giới tính mã hoá bằng số 1 và 2 nhưng chưa gán nhãn Nam, Nữ. Ba vấn đề này thuộc ba nhóm khác nhau trong bốn nhóm trên, và mỗi nhóm cần một cách xử lý riêng, nên không thể dùng chung một quy tắc cho cả ba.
Trước khi làm sạch, cần chuẩn bị gì trong SPSS?
Trả lời thẳng: Ba việc cần làm trước khi bắt tay vào làm sạch là giữ lại một bản dữ liệu chưa động tới, gắn cho mỗi ca một mã số riêng, và viết ra những gì mình sắp sửa để sau này còn nhớ. Thêm một việc dễ bỏ sót là dò lại mức đo (Measure) SPSS tự gán cho từng biến, vì phần mềm đoán không phải lúc nào cũng đúng.
EZ SPSS Tutorials (2023) khuyên làm ba bước chuẩn bị trước khi làm sạch dữ liệu trong SPSS. Bước đầu là sao lưu tập dữ liệu gốc. Bước thứ hai là bảo đảm mỗi ca có một mã định danh duy nhất, để có thể khôi phục thứ tự ban đầu sau khi sắp xếp. Bước thứ ba là ghi lại toàn bộ quá trình làm sạch, và phần ghi chép này rất có ích khi viết chương phương pháp, vì hội đồng có thể hỏi bạn đã loại bao nhiêu phiếu và vì sao.
Weber (n.d.) lưu ý thêm rằng khi nhập một tập dữ liệu vào SPSS, phần mềm tự đoán mức đo cho từng biến và đôi khi đoán sai, nên người dùng cần tự kiểm tra rồi sửa mức đo trong Variable View khi phát hiện chỗ chưa đúng. Chẳng hạn, nếu bạn nhập một biến vùng miền mã hoá bằng số (1 là Bắc, 2 là Trung, 3 là Nam) nhưng SPSS tự gán mức đo Scale thay vì Nominal, những phép tính trung bình vô nghĩa vẫn chạy được mà không báo lỗi nào. Sửa mức đo về Nominal trong Variable View trước khi phân tích sẽ tránh được lỗi này. Bài các loại thang đo trong SPSS giải thích vì sao ba lựa chọn Measure của SPSS tương ứng với bốn loại thang đo lý thuyết, cùng cách chọn đúng cho từng biến.
Giá trị ngoài khoảng và giá trị ngoại lai trong SPSS khác nhau thế nào, xử lý ra sao?
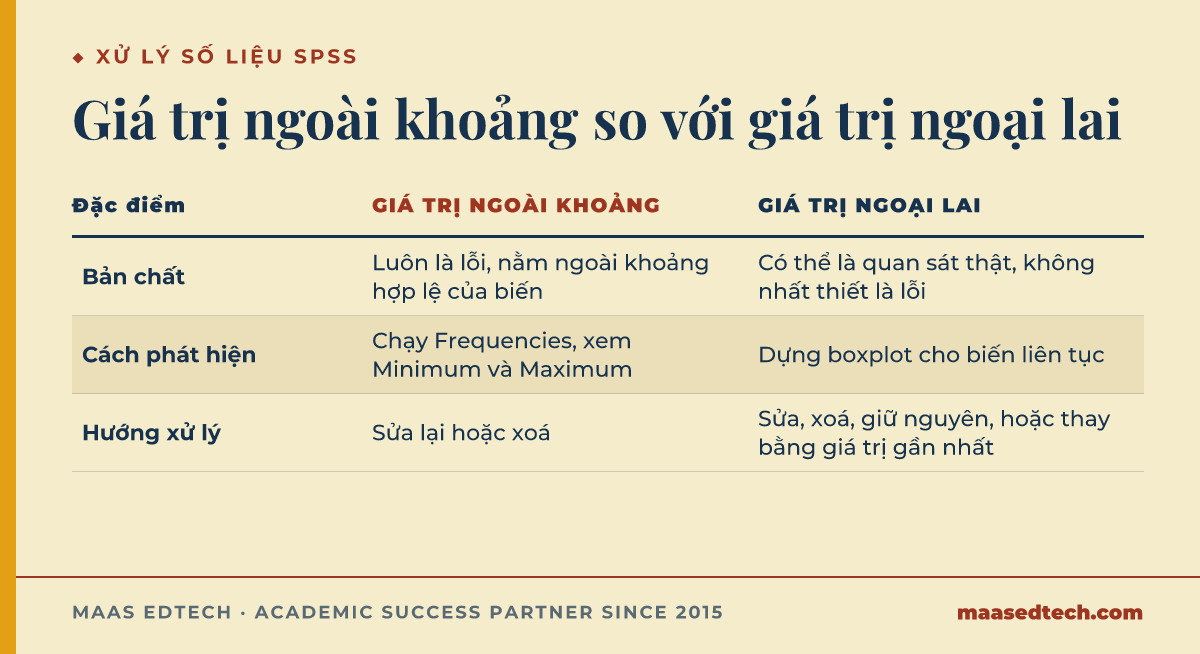
Trả lời thẳng: Hai loại này không giống nhau, dù hay bị gộp chung. Ghi 150 tuổi là lỗi chắc chắn, gọi là giá trị ngoài khoảng, chỉ có hai đường đi là sửa lại hoặc xoá. Còn một mức chi tiêu bất thường cao có thể là thật, gọi là ngoại lai, và với ngoại lai người viết còn hai lựa chọn nữa ngoài sửa với xoá, đó là giữ nguyên hoặc thay bằng một giá trị lân cận.
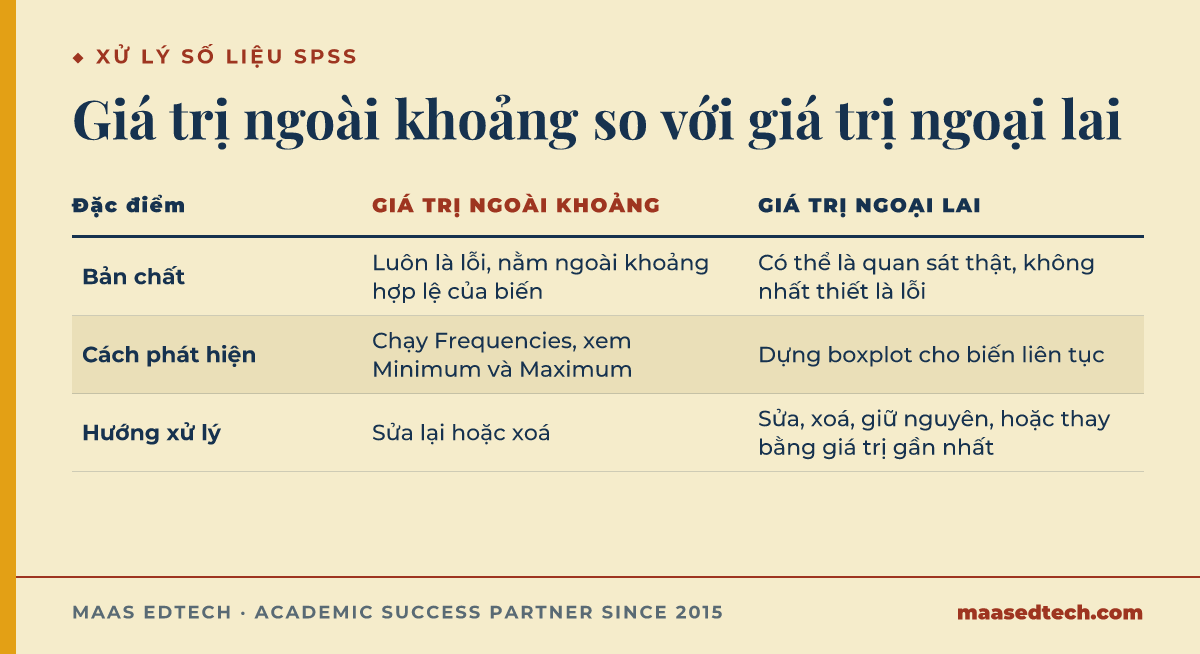
EZ SPSS Tutorials (2023) định nghĩa giá trị ngoài khoảng (out-of-range) là giá trị nằm ngoài khoảng hợp lệ của biến. Cách phát hiện là chạy Frequencies rồi xem hai chỉ số Minimum và Maximum. Cách xử lý là sửa lại nếu tra được giá trị đúng qua phiếu gốc, và xoá nếu không tra được. Nguồn này cũng dặn rằng bước sắp xếp biến để dò lỗi chỉ nên làm sau khi đã gắn mã định danh cho từng ca, vì SPSS không hoàn tác được một lần sắp xếp.
Ngoại lai (outlier) thì khác ở chỗ nó không nhất thiết là lỗi nhập liệu. Theo EZ SPSS Tutorials (2023), cách phát hiện phổ biến là dựng boxplot cho biến liên tục, và có bốn hướng xử lý, gồm sửa nếu xác định được giá trị đúng, xoá nếu đó là lỗi mà không xác định được giá trị đúng, giữ nguyên nếu đó là quan sát hợp lệ, hoặc thay bằng giá trị gần nhất không phải ngoại lai. Stephen (2016) phân biệt thêm ngoại lai đơn biến, tức giá trị cực đoan trên một biến, với ngoại lai đa biến, tức một ca có tổ hợp giá trị bất thường trên nhiều biến cùng lúc, loại thường được phân tích bằng khoảng cách Mahalanobis.
Hai ví dụ giúp thấy rõ ranh giới. Một biến điểm thi ghi giá trị 15 trên thang điểm 10 là giá trị ngoài khoảng, chắc chắn là lỗi nhập liệu và cần sửa hoặc xoá. Nhưng một sinh viên có mức chi tiêu tháng cao gấp năm lần trung vị của nhóm có thể là ngoại lai hợp lệ, không phải lỗi nhập, nên giữ hay bỏ ca đó còn phụ thuộc vào việc giá trị ấy có làm lệch giả định của kiểm định sắp chạy hay không. EZ SPSS Tutorials (2023) lưu ý rằng nếu loại bỏ hoặc thay thế một ngoại lai không phải do lỗi nhập liệu, người viết cần giải trình quyết định đó khi báo cáo kết quả nghiên cứu, và hội đồng có thể hỏi đúng điều này ở buổi bảo vệ.
Giá trị thiếu trong SPSS xử lý thế nào, khi nào nên xoá, khi nào nên điền?
Trả lời thẳng: Không có một câu trả lời chung cho mọi tình huống thiếu dữ liệu, quyết định phụ thuộc vào tỷ lệ ô trống và việc chúng có rơi ngẫu nhiên hay không. Ô trống chiếm phần nhỏ và rải ngẫu nhiên thì bỏ hẳn những ca đó là cách an toàn. Ô trống chiếm phần lớn hơn, hoặc rơi có quy luật vào một nhóm cụ thể, thì nên chuyển sang điền giá trị thay vì bỏ.
IBM (n.d.) ghi nhận rằng khi dữ liệu thiếu ít và thiếu hoàn toàn ngẫu nhiên, listwise deletion, tức loại bỏ toàn bộ ca có ô trống, là cách tương đối an toàn. Cùng tài liệu này mô tả hai nhóm thủ tục SPSS dùng cho dữ liệu thiếu. Nhóm thứ nhất là Missing Value Analysis, một công cụ mô tả gồm kiểm định Little's MCAR và các phương pháp điền đơn. Nhóm thứ hai là Multiple Imputation, thủ tục tạo nhiều bản dữ liệu được điền giá trị khác nhau rồi gộp các ước lượng lại, mặc định tạo 5 bản mỗi lần chạy. IBM (n.d.) cho biết hai thủ tục này chỉ có trong bản SPSS Statistics Premium Edition hoặc khi mua thêm tuỳ chọn Missing Values, chứ không có sẵn trên bản GradPack tiêu chuẩn, nên bạn nên kiểm tra bản SPSS mình đang dùng trước khi lên kế hoạch.
Stephen (2016) liệt kê hai hướng xử lý giá trị thiếu ngoài việc để nguyên, gồm xoá ca có giá trị thiếu, hoặc thay thế bằng Mean Substitution, Multiple Imputation hay thuật toán Expectation Maximization, đồng thời lưu ý rằng Mean Substitution bị phê bình nhiều vì làm sai lệch tương quan giữa các biến. Để tìm giá trị thiếu, EZ SPSS Tutorials (2023) hướng dẫn vào Analyze, Descriptive Statistics, Frequencies, và nhắc rằng SPSS đánh dấu ô trống ở biến số là "system missing" trong bảng Statistics nhưng không đánh dấu ô trống ở biến chuỗi theo cách đó, nên với biến chuỗi phải xem bảng tần suất mới thấy.
Giả sử một khảo sát 300 sinh viên có 8 ca bỏ trống câu hỏi thu nhập gia đình, tức dưới 3% tổng số ca. Nếu không có dấu hiệu cho thấy nhóm bỏ trống khác biệt có hệ thống so với nhóm trả lời, loại 8 ca đó khi chạy riêng biến thu nhập là lựa chọn hợp lý. Nhưng nếu một câu hỏi nhạy cảm hơn, chẳng hạn mức chi tiêu, bị bỏ trống tới 40 ca, xoá hết sẽ làm cỡ mẫu giảm đáng kể, và khi đó cân nhắc Multiple Imputation phù hợp hơn xoá.
| Loại vấn đề | Ví dụ | Cách phát hiện trong SPSS | Cách xử lý |
|---|---|---|---|
| Lỗi cấu trúc | Chính tả, viết hoa và viết thường không nhất quán ở biến định tính | Xem bảng tần suất (Frequencies) của biến định tính | Chuẩn hoá lại nhãn cho nhất quán |
| Giá trị ngoài khoảng | Tuổi ghi 150, điểm ghi 15 trên thang 10 | Frequencies, xem Minimum và Maximum | Sửa nếu xác định được giá trị đúng, xoá nếu không |
| Giá trị ngoại lai | Chi tiêu cao gấp nhiều lần trung vị nhóm | Dựng boxplot cho biến liên tục | Sửa, xoá, giữ nguyên hoặc thay thế, tuỳ nguồn gốc giá trị |
| Giá trị thiếu | Ô trống ở câu hỏi khảo sát | Analyze, Descriptive Statistics, Frequencies | Loại bỏ nếu thiếu ít và ngẫu nhiên, điền giá trị nếu thiếu nhiều |
Sau khi làm sạch, bước tiếp theo trong xử lý số liệu SPSS là gì?
Trả lời thẳng: Sau khi làm sạch xong bốn nhóm vấn đề trên, bước tiếp theo là chạy thống kê mô tả để xem đặc điểm chung của mẫu, trước khi chuyển sang các kiểm định giả thuyết như so sánh trung bình hay tương quan hồi quy. Thống kê mô tả cũng là bước để phát hiện thêm những bất thường mà bước làm sạch trước đó có thể đã bỏ sót.
Kent State University Libraries (n.d.-b) chia bộ hướng dẫn SPSS của mình thành bốn phần theo trình tự, trong đó phần khám phá dữ liệu bằng thống kê mô tả, bảng tần suất và đồ thị phân phối đứng trước phần phân tích dữ liệu bằng kiểm định giả thuyết. Kent State University Libraries (n.d.-a) cũng lưu ý rằng khi chạy thủ tục Explore, "you can't pick and choose which of these descriptive statistics to view" (Kent State University Libraries, n.d.-a), tức người dùng nhận trọn gói các chỉ số thống kê mô tả chứ không lọc riêng được từng chỉ số như khi dùng Descriptives. Georgia State University Library (n.d.) minh hoạ cú pháp lệnh Descriptives để chọn đúng các chỉ số mô tả cần xuất, một bước thường chạy ngay sau khi dữ liệu đã được làm sạch.
Thống kê mô tả vì thế còn đóng vai một lượt kiểm tra lại. Nếu chạy xong mà thấy độ lệch chuẩn của một biến lớn bất thường so với các biến khác trong cùng thang đo, đó có thể là dấu hiệu vẫn còn giá trị ngoài khoảng hoặc ngoại lai chưa xử lý hết, và bạn cần quay lại bước trước để kiểm tra. Toàn bộ cách chạy và đọc bảng thống kê mô tả, gồm mean, median, mode và bảng tần suất, được trình bày riêng ở bài cách chạy thống kê mô tả SPSS.
Câu hỏi thường gặp
Xử lý số liệu SPSS mất bao lâu?
Không có con số cố định, vì thời gian phụ thuộc vào độ lớn của tập dữ liệu và mức độ sạch của dữ liệu gốc. Một tập dữ liệu khảo sát trực tuyến có ràng buộc nhập liệu chặt thường mất ít thời gian làm sạch hơn một tập dữ liệu nhập tay từ phiếu giấy.
Có bắt buộc phải xoá toàn bộ giá trị thiếu trước khi chạy SPSS không?
Không. IBM (n.d.) và Stephen (2016) đều nhấn mạnh quyết định phụ thuộc vào tỷ lệ thiếu và việc thiếu có ngẫu nhiên hay không, chứ không phải một quy tắc cứng áp dụng cho mọi trường hợp.
Ngoại lai có luôn phải xoá khỏi dữ liệu SPSS không?
Không. Theo EZ SPSS Tutorials (2023), một ngoại lai có thể là quan sát hợp lệ, và trong trường hợp đó nên giữ nguyên, dù có thể cần cân nhắc chuyển sang kiểm định phi tham số nếu ngoại lai ảnh hưởng tới giả định của kiểm định.
Làm sao biết một giá trị là lỗi nhập liệu hay ngoại lai thật?
Giá trị ngoài khoảng luôn kiểm tra được qua khoảng giá trị hợp lệ đã biết trước, ví dụ tuổi không thể âm hoặc quá 120. Ngoại lai cần đối chiếu với phiếu gốc hoặc bối cảnh thu thập dữ liệu để xác định có phải lỗi hay không.
Nên làm sạch dữ liệu trên bản gốc hay bản sao?
Nên làm trên bản sao. EZ SPSS Tutorials (2023) khuyên sao lưu tập dữ liệu gốc trước khi bắt đầu, để có thể đối chiếu lại và khôi phục nếu một quyết định làm sạch sau này cần xem lại.
MAAS hỗ trợ gì cho người đang xử lý số liệu SPSS cho luận văn?
Với dịch vụ hỗ trợ xử lý số liệu luận văn, một chuyên gia MAAS đúng chuyên ngành thống nhất với bạn phương pháp phân tích trước, rồi chạy phân tích và giải thích cho bạn hiểu mỗi bước làm gì. Bạn nhận lại bộ dữ liệu sau khi làm sạch, tệp cú pháp và các bảng kết quả, đủ để tự lặp lại phân tích khi hội đồng hỏi. Chương trình bày và diễn giải kết quả vẫn do chính bạn viết, còn chuyên gia đọc và góp ý cho tới khi phần đó bám sát câu hỏi nghiên cứu.
Nên làm gì tiếp theo
Làm sạch số liệu là bước nền trước khi chạy bất kỳ thống kê nào, và một quyết định làm sạch sai, chẳng hạn xoá nhầm một ngoại lai hợp lệ hoặc giữ lại một giá trị ngoài khoảng, có thể làm lệch toàn bộ kết quả phía sau. Trước khi chạy kiểm định, hãy mang bảng ghi chép quá trình làm sạch tới giảng viên hướng dẫn để thầy cô xem các quyết định loại phiếu, xử lý ngoại lai và giá trị thiếu có hợp lý với đề tài không.
Sau khi làm sạch xong, bước kế tiếp là chạy thống kê mô tả, và bài cách chạy thống kê mô tả SPSS hướng dẫn cách chạy và đọc bảng Descriptives, Frequencies đầy đủ. Nếu bạn cần hiểu rõ hơn cách phân loại biến độc lập và biến phụ thuộc trước khi tái mã hoá, xem biến độc lập và biến phụ thuộc trong SPSS khác nhau thế nào. Để hiểu ba mức đo trên giao diện SPSS tương ứng với bốn thang đo lý thuyết, xem các loại thang đo trong SPSS. Nếu bạn chưa nắm tổng quan về phần mềm này, bài SPSS là gì là điểm bắt đầu phù hợp trước khi đi vào từng bước xử lý số liệu.
Nếu cần một chuyên gia đúng chuyên ngành đi cùng phần số liệu của khoá luận, luận văn hay luận án, bạn có thể xem cách làm việc của dịch vụ hỗ trợ xử lý số liệu luận văn, hoặc liên hệ MAAS để hẹn buổi tư vấn miễn phí 20 phút. MAAS giữ kín dữ liệu và đề tài của bạn.
References
- EZ SPSS Tutorials. (2023). How to clean data in SPSS. Retrieved September 21, 2026, from https://ezspss.com/how-to-clean-data-in-spss/
- Georgia State University Library. (n.d.). SPSS: Descriptive statistics. Retrieved September 21, 2026, from https://research.library.gsu.edu/SPSSHelp/descriptive
- IBM. (n.d.). IBM SPSS Missing Values 28 [PDF]. Retrieved September 21, 2026, from https://www.ibm.com/docs/en/SSLVMB_28.0.0/pdf/IBM_SPSS_Missing_Values.pdf
- Kent State University Libraries. (n.d.-a). Descriptive stats for one numeric variable (Explore). Retrieved September 21, 2026, from https://libguides.library.kent.edu/SPSS/Explore
- Kent State University Libraries. (n.d.-b). SPSS tutorials. Retrieved September 21, 2026, from https://libguides.library.kent.edu/SPSS/home
- Stephen, D. (2016). Data screening using SPSS for beginner: Outliers, missing values and normality. Institute of Borneo Studies Workshop Series, Universiti Malaysia Sarawak. Internet Archive. https://web.archive.org/web/20260610003927/https://ir.unimas.my/id/eprint/12266/
- Weber, M. (n.d.). Data cleaning: SPSS statistical software. Baylor University Libraries. Retrieved September 21, 2026, from https://libguides.baylor.edu/c.php?g=1351162&p=9972297