
◆ Phương pháp nghiên cứu
Phân tích nhân tố khám phá EFA là gì, khi nào dùng trong luận văn?
Phân tích nhân tố khám phá (EFA) là kỹ thuật thống kê rút gọn nhiều biến quan sát thành một số ít nhân tố tiềm ẩn giải thích tương quan giữa chúng, thường cần dùng khi thang đo là mới hoặc chưa có cấu trúc nhân tố nào được xác nhận trước đó cho bối cảnh đang khảo sát. Hai điều kiện cần kiểm tra trước khi chạy là hệ số KMO và kiểm định Bartlett, còn số nhân tố giữ lại cần nhiều hơn một quy tắc, không chỉ mặc định eigenvalue lớn hơn 1 của SPSS.
◆ Câu hỏi 1 / 9 · EFA và PCA
Phân tích nhân tố khám phá EFA là gì và khác gì với phân tích thành phần chính PCA?
Trả lời thẳng: EFA là phương pháp thống kê đa biến tìm ra một số ít nhân tố chung, chưa quan sát được trực tiếp, giải thích tương quan giữa một tập hợp lớn hơn các biến đo lường được. PCA và EFA thường nằm chung một hộp thoại trong SPSS nên hay bị lẫn với nhau, dù hai kỹ thuật giải quyết hai bài toán khác nhau về khái niệm.
Bằng chứng: Watkins (2018) trích lại định nghĩa của Brown (2015) rằng một nhân tố là biến không quan sát được, ảnh hưởng tới nhiều hơn một biến đo lường và giải thích tương quan giữa các biến đó. CASRAI Editorial Board (n.d.-a) phân biệt PCA đặt giá trị 1,00 trên đường chéo ma trận tương quan, tạo ra thành phần là tổ hợp trọng số của các biến, không giả định biến tiềm ẩn hay sai số đo lường. Còn EFA đặt ước lượng communality trên đường chéo, mô hình hoá mỗi biến là hàm của nhân tố chung cộng một phần riêng hấp thụ sai số. Hệ quả là hệ số tải PCA thường lớn hơn hệ số tải common-factor một cách hệ thống, chênh lệch tăng khi communality thấp và số biến ít, đúng tình huống một thang đo mới, ngắn, thường gặp ở luận văn thạc sĩ.
Ví dụ: Một luận văn ghi "chạy phân tích nhân tố bằng Principal Components" rồi gọi kết quả là EFA cần làm rõ lại trong phần phương pháp, vì Principal Components là PCA, một kỹ thuật giảm chiều dữ liệu, khác bản chất khái niệm với EFA.
◆ Câu hỏi 2 / 9 · EFA và CFA
Vì sao EFA khác phân tích nhân tố khẳng định CFA, và chạy CFA trên cùng dữ liệu đã EFA có phải là xác nhận thật sự không?
Trả lời thẳng: Trong EFA, mọi biến tự do tải lên mọi nhân tố, và cấu trúc nhân tố là kết quả đầu ra của phân tích. Trong CFA, mẫu hình biến nào tải lên nhân tố nào được chỉ định trước như một giả thuyết, phần lớn hệ số tải chéo bị cố định bằng 0, rồi mô hình được kiểm định với dữ liệu thật.
Bằng chứng: CASRAI Editorial Board (n.d.-a) chỉ ra CFA có thể sai theo cách EFA không thể, cụ thể là CFA có thể bị bác bỏ khi mô hình không khớp dữ liệu, trong khi EFA không đặt ra một giả thuyết cấu trúc cụ thể để bác bỏ theo cách đó. Cùng nguồn này nhấn mạnh cấu trúc gọi là "xác nhận" chính là cấu trúc đã ước lượng từ chính dữ liệu đó, nên một phép xác nhận thật sự cần một mẫu độc lập hoặc một phần dữ liệu được tách riêng trước khi phân tích.
Ví dụ: Chạy EFA rồi chạy tiếp CFA trên chính dữ liệu đó và gọi là "bằng chứng xác nhận cấu trúc thang đo" là sai lầm thường gặp. Muốn xác nhận thật sự, cần một mẫu thứ hai, hoặc chia sẵn mẫu ban đầu thành hai phần, một cho EFA, phần còn lại cho CFA. Nếu bạn chạy CFA bằng AMOS, bài AMOS là gì cho bạn biết phần mềm này khác SPSS ở điểm nào.
◆ Câu hỏi 3 / 9 · Điều kiện trước khi chạy
Trước khi chạy EFA cần kiểm tra những điều kiện gì?
Trả lời thẳng: Hai điều kiện cần kiểm tra là hệ số KMO (Kaiser-Meyer-Olkin) và kiểm định Bartlett's test of sphericity. Cả hai nhắm tới cùng một câu hỏi, là các biến có đủ tương quan để việc trích xuất nhân tố có ý nghĩa hay không, nhưng mỗi kiểm định trả lời theo một cách riêng.
Bằng chứng: Watkins (2018) nêu điều kiện cần là các biến phải có tương quan với nhau, không phải một ma trận đơn vị, và một số lượng đáng kể hệ số tương quan nên vượt ±0,30. Kiểm định Bartlett kiểm định giả thuyết H0 rằng ma trận tương quan là ma trận đơn vị, nghĩa là không có phương sai chung để trích xuất, với công thức χ² = −[(n−1) − (2p+5)/6] × ln|R|, trong đó n là cỡ mẫu, p là số biến, |R| là định thức ma trận tương quan (CASRAI Editorial Board, n.d.-b). Hạn chế của kiểm định này là với cỡ mẫu lớn, nó gần như luôn có ý nghĩa thống kê dù chỉ lệch rất nhỏ so với ngẫu nhiên, nên một kết quả có ý nghĩa cần đọc kèm KMO thay vì tự nó đã đủ làm căn cứ chạy EFA (Watkins, 2018). CASRAI Editorial Board (n.d.-b) diễn giải theo hướng thực hành: Bartlett không ý nghĩa là thông tin đáng tin để dừng lại, còn có ý nghĩa thì không cung cấp thêm nhiều thông tin, vì gần như luôn xảy ra với mẫu thực tế.
Ví dụ: Nếu Bartlett cho p < 0,001 với cỡ mẫu 300, đừng vội coi đây là bằng chứng mạnh rằng dữ liệu phù hợp để chạy EFA, vì với cỡ mẫu lớn gần như mọi bộ dữ liệu đều có ý nghĩa ở kiểm định này. Bước tiếp theo bắt buộc là đọc chỉ số KMO.
◆ Câu hỏi 4 / 9 · Chỉ số KMO
Chỉ số KMO bao nhiêu là đạt, và vì sao KMO tổng thể đạt vẫn có thể che giấu một biến yếu?
Trả lời thẳng: KMO so sánh độ lớn của các hệ số tương quan với độ lớn của các hệ số tương quan riêng phần, qua đó phản ánh mức tương quan giữa các biến là do phương sai chia sẻ chung, thay vì phương sai chia sẻ giữa từng cặp biến. Giá trị nằm trong khoảng 0 đến 1, tính được cho toàn ma trận lẫn cho từng biến riêng, gọi là Measure of Sampling Adequacy (MSA).
Phân tích nhân tố khám phá EFA, cách kết hợp kiểm định Bartlett và chỉ số KMO theo CASRAI Editorial Board (n.d.-b)
Mỗi hàng đặt một cặp kết quả của hai kiểm định cạnh hướng xử lý mà bài trích.
Kết quả của hai kiểm định
Hướng xử lý
Bartlett không có ý nghĩa
Dừng lại, không chạy EFA trên tập biến đó.
Bartlett có ý nghĩa và KMO từ 0,60 trở lên
Tiến hành trích xuất nhân tố.
Bartlett có ý nghĩa nhưng KMO dưới 0,60
Tương quan có thật nhưng quá yếu, và tăng cỡ mẫu không tự sửa được vấn đề này.
Lưu hình này
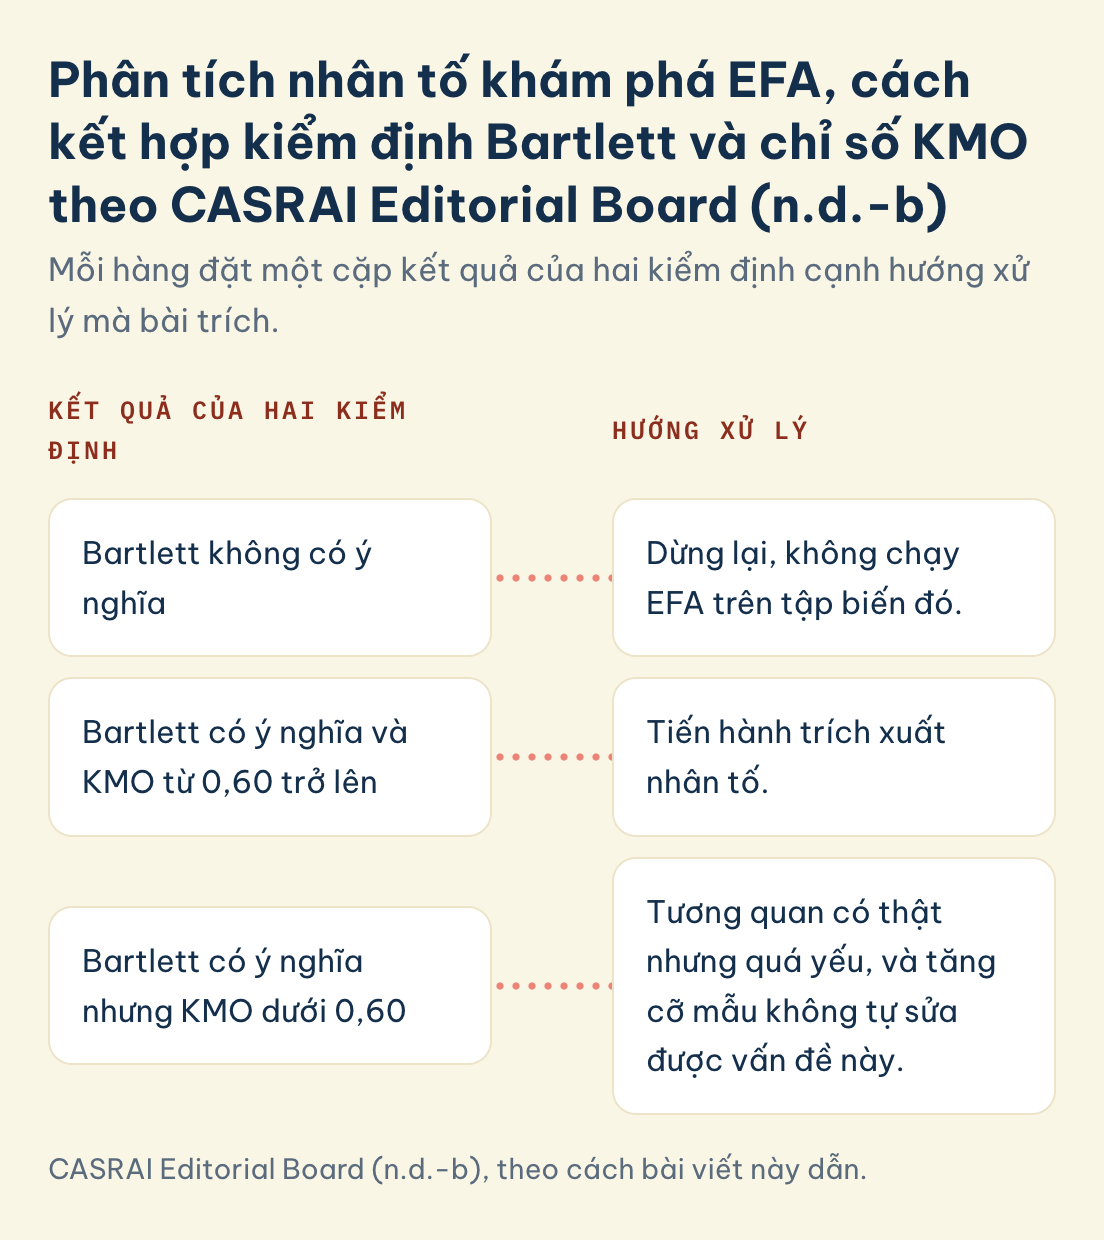
Bằng chứng: Kaiser (1974), dẫn qua Watkins (2018), đưa ra bảng ngưỡng diễn giải KMO ở bảng dưới. Ngưỡng tổng thể khuyến nghị rộng rãi là từ 0,70 trở lên, dưới 0,50 là không chấp nhận được (Watkins, 2018), còn CASRAI Editorial Board (n.d.-b) dùng ngưỡng sàn thận trọng hơn là 0,60, cho thấy đây là quy ước chứ không phải luật cố định. Một biến có MSA dưới 0,50 là ứng viên cần loại, xử lý bằng cách loại biến MSA thấp nhất, tính lại KMO và Bartlett trên tập rút gọn, lặp lại nếu còn biến dưới ngưỡng, chỉ loại một biến mỗi lần (CASRAI Editorial Board, n.d.-b). Kết hợp hai kiểm định để quyết định hướng xử lý là cách CASRAI Editorial Board (n.d.-b) khuyến nghị. Nếu Bartlett không ý nghĩa thì dừng lại, không chạy EFA trên tập biến đó. Nếu Bartlett có ý nghĩa và KMO từ 0,60 trở lên thì tiến hành trích xuất. Nếu Bartlett có ý nghĩa nhưng KMO dưới 0,60 thì tương quan có thật nhưng quá yếu, và tăng cỡ mẫu không tự sửa được vấn đề này.
Ví dụ: Một KMO tổng thể chấp nhận được vẫn có thể che giấu một biến đơn lẻ đang chủ yếu gây nhiễu. Bảng hỏi 20 mục có KMO tổng thể 0,74, mức "khá". Nếu một mục có MSA riêng chỉ 0,38, mục này vẫn nên bị loại trước khi trích xuất, dù KMO tổng thể trông ổn.
| Khoảng giá trị KMO | Diễn giải theo Kaiser (1974) |
|---|---|
| 0,90 đến 1,00 | Tuyệt vời (marvellous) |
| 0,80 đến 0,89 | Đáng khen (meritorious) |
| 0,70 đến 0,79 | Khá (middling) |
| 0,60 đến 0,69 | Tầm thường (mediocre) |
| 0,50 đến 0,59 | Kém (miserable) |
| Dưới 0,50 | Không chấp nhận được (unacceptable) |
◆ Câu hỏi 5 / 9 · KMO và Bartlett trong SPSS
KMO là gì, và cách bật, cách đọc kiểm định KMO và Bartlett trong SPSS như thế nào?
Trả lời thẳng: KMO là thước đo cho biết các hệ số tương quan giữa các biến có đủ lớn so với tương quan riêng phần để phân tích nhân tố có ích hay không, và SPSS đưa nó vào cùng một lựa chọn với kiểm định Bartlett. IBM (n.d.) mô tả cách bật là vào Analyze, Dimension Reduction, Factor, bấm Descriptives rồi chọn KMO and Bartlett's test of sphericity.
Bằng chứng: IBM (n.d.) liệt kê trong nhóm Correlation Matrix của hộp thoại Descriptives các lựa chọn gồm hệ số tương quan, mức ý nghĩa, định thức, KMO và Bartlett, ma trận nghịch đảo, ma trận tái tạo và anti-image, nên muốn có bảng KMO và Bartlett thì bạn phải chọn đúng ô này. IBM (n.d.) cho biết ma trận tương quan anti-image chứa phủ định của các hệ số tương quan riêng phần, và MSA của từng biến nằm trên đường chéo của ma trận đó. IBM (2021) nêu rằng Bartlett kiểm định giả thuyết ma trận tương quan là ma trận đơn vị, Sig. nhỏ hơn 0,05 cho thấy phân tích nhân tố có thể hữu ích với dữ liệu, còn KMO nhỏ hơn 0,50 thì kết quả phân tích nhân tố có lẽ không hữu ích lắm. Field (2005) viết đường dẫn là Analyze, Data Reduction, Factor, khác chữ Dimension Reduction ở tài liệu IBM, nên nếu menu trên máy bạn không giống thì hãy tìm theo chữ Factor.
Ví dụ: Watkins (2018) liệt kê "Appropriateness of data for EFA (Bartlett and KMO statistics)" trong số các mục cần có khi báo cáo một phân tích nhân tố khám phá. Bài báo của Watkins (2018) đưa ví dụ báo cáo với 20 biến là χ²(190) = 2.648, p < 0,001 và KMO bằng 0,80, trong đó bậc tự do 190 chính là 20 × 19 chia 2. Trong luận văn, bạn có thể viết theo cùng thứ tự đó, nêu giá trị χ², bậc tự do, p và KMO tổng thể, rồi ghi riêng những biến có MSA thấp đã bị loại.
Các việc cần làm với bảng KMO và Bartlett trong SPSS được tóm lại ở bảng sau, mỗi việc kèm nguồn.
| Việc cần làm | Ở đâu trong SPSS | Đọc gì, theo nguồn nào |
|---|---|---|
| Bật bảng KMO và Bartlett | Analyze, Dimension Reduction, Factor, Descriptives, ô KMO and Bartlett's test of sphericity | IBM (n.d.) mô tả đây là lựa chọn nằm trong nhóm Correlation Matrix |
| Đọc kiểm định Bartlett | Dòng Sig. trong bảng KMO and Bartlett's Test | Sig. nhỏ hơn 0,05 cho thấy phân tích nhân tố có thể hữu ích (IBM, 2021) |
| Đọc KMO tổng thể | Dòng Kaiser-Meyer-Olkin Measure of Sampling Adequacy | Dưới 0,50 thì kết quả có lẽ không hữu ích (IBM, 2021) |
| Đọc MSA từng biến | Đường chéo ma trận Anti-image Correlation, bật bằng ô Anti-image | MSA của từng biến nằm trên đường chéo (IBM, n.d.) |
Về câu hỏi KMO bao nhiêu là đạt, các nguồn đã đọc đặt ba mức khác nhau với ba vai trò khác nhau.
| Mức KMO | Vai trò | Nguồn |
|---|---|---|
| 0,50 | Sàn tối thiểu, dưới mức này kết quả có lẽ không hữu ích | IBM (2021) |
| 0,60 | Sàn thận trọng theo quy ước | CASRAI Editorial Board (n.d.-b) |
| 0,70 trở lên | Mức mong muốn cho KMO tổng thể | Watkins (2018) |
◆ Câu hỏi 6 / 9 · Cỡ mẫu
Cỡ mẫu bao nhiêu là đủ để chạy EFA, và vì sao quy tắc 5:1 hay 10:1 không phải lúc nào cũng đúng?
Trả lời thẳng: Không có một quy tắc cỡ mẫu cố định nào, dù là N=300 hay tỷ lệ 10 quan sát mỗi biến, đúng phổ quát cho mọi trường hợp EFA. Cỡ mẫu cần thiết phụ thuộc communality của các biến và số chỉ báo định nghĩa mỗi nhân tố, không phải một hằng số cố định với số biến.
Bằng chứng: MacCallum và cộng sự (1999), dẫn qua CASRAI Editorial Board (n.d.-a), cho thấy khi communality cao (0,60 đến 0,70) và mỗi nhân tố có nhiều biến đại diện, mẫu dưới 200 có thể đủ để khôi phục đúng cấu trúc. Ngược lại, khi communality thấp (0,30 đến 0,40) và mỗi nhân tố chỉ có ba biến, vài trăm mẫu vẫn có thể chưa đủ. Cách làm trung thực là báo cáo communality quan sát được cùng mức overdetermination của nhân tố, thay vì đưa ra một tỷ lệ cố định. Quy tắc tỷ lệ 5:1 hoặc 10:1 kèm sàn 100 hoặc 200 mẫu là khuyến nghị ban đầu mà Watkins (2018) nhắc lại từ nghiên cứu năm 2010 của Hair và cộng sự, không phải kết luận đã kiểm chứng thực nghiệm phổ quát, và MacCallum và cộng sự (1999) trực tiếp bác bỏ tính phổ quát của tỷ lệ cố định.
Ví dụ: Đề cương chỉ ghi "cỡ mẫu 200, gấp 10 lần số biến" mà không nói gì về communality dự kiến có thể bị hội đồng yêu cầu bổ sung căn cứ, chẳng hạn nêu rõ mỗi nhân tố dự kiến có bao nhiêu mục hỏi.
◆ Câu hỏi 7 / 9 · Eigenvalue lớn hơn 1
Quy tắc eigenvalue lớn hơn 1 dùng để làm gì, và vì sao nhiều nhà phương pháp luận không khuyến nghị dùng nó một mình?
Trả lời thẳng: Quy tắc Kaiser, hay eigenvalue lớn hơn 1, giữ lại mọi nhân tố có giá trị riêng lớn hơn 1,00 và là mặc định của SPSS. Đây là tiêu chí dễ áp dụng nhất, nhưng văn liệu phương pháp luận phê phán khá mạnh vì nó có xu hướng trích xuất quá nhiều nhân tố, đặc biệt với thang đo dài.
Bằng chứng: CASRAI Editorial Board (n.d.-a) cho biết quy tắc này bắt nguồn từ một đề xuất của Kaiser vào năm 1960, dựa trên kết quả của Guttman công bố năm 1954 rằng eigenvalue lớn hơn 1 là một cận dưới cho số thành phần trong ma trận tương quan tổng thể. Số eigenvalue vượt 1 có xu hướng tăng theo số lượng biến, khiến quy tắc dễ over-extract, tức trích thừa nhân tố. Cùng nguồn này khuyến nghị phương pháp thay thế mạnh hơn là phân tích song song, do Horn đề xuất năm 1965, làm tiêu chí chính, đối chiếu thêm kiểm định MAP của Velicer và scree plot, rồi kiểm tra khả năng diễn giải của các giải pháp trước khi chốt số nhân tố.
Ví dụ: SPSS xuất bảng Total Variance Explained với 6 nhân tố eigenvalue lớn hơn 1 chưa phải bằng chứng 6 là số đúng. Đối chiếu thêm scree plot và parallel analysis nếu có điều kiện, trước khi chốt số nhân tố cuối cùng. Bài SPSS thực hiện được những nhóm kiểm định thống kê nào liệt kê phân tích nhân tố là một trong các nhóm kiểm định SPSS thực hiện được, thường đi kèm kiểm định độ tin cậy thang đo.
◆ Câu hỏi 8 / 9 · Hệ số tải nhân tố
Hệ số tải nhân tố bao nhiêu là đạt, và xử lý biến tải chéo như thế nào?
Trả lời thẳng: Không có một con số hệ số tải duy nhất đúng cho mọi nghiên cứu. Các tài liệu đưa ra vài dải ngưỡng khác nhau, và quan trọng là nêu rõ ngưỡng mình chọn trước khi nhìn vào bảng kết quả, không phải sau khi đã thấy số liệu rồi mới chọn cho vừa ý.
Bằng chứng: Williams, Onsman và Brown (2010) đưa ra ba mức, dẫn lại từ nghiên cứu năm 1995 của Hair và cộng sự: ±0,30 tối thiểu, ±0,40 quan trọng, ±0,50 có ý nghĩa thực tiễn. CASRAI Editorial Board (n.d.-a) đưa dải khác, 0,32 là sàn để diễn giải, 0,40 là mức tối thiểu, 0,50 trở lên là mạnh, và nhấn mạnh đây là quy ước chứ không phải kiểm định thống kê. Về biến tải chéo, CASRAI Editorial Board (n.d.-a) đưa ra một quy tắc quyết định, loại một biến khi hai hệ số tải cao nhất của nó cách nhau chỉ khoảng 0,10 đến 0,15, vì mức chênh lệch đó chưa đủ để nói biến thuộc rõ về một nhân tố nào. Các tài liệu khác có thể đưa ra mức chênh lệch khác, nên điều quan trọng là công bố ngưỡng mình chọn trước khi đọc bảng kết quả, giống cách chọn ngưỡng hệ số tải ở trên. Một biến có communality dưới 0,20 đến 0,30 là ứng viên để loại, nhưng nên loại từng biến một rồi chạy lại, vì mỗi lần loại sẽ làm thay đổi giải pháp còn lại (CASRAI Editorial Board, n.d.-a).
Ví dụ: Một biến tải 0,45 lên nhân tố 1 và 0,40 lên nhân tố 2, chênh lệch chỉ 0,05, nhỏ hơn cả mức 0,10 mà CASRAI xem là ranh giới dưới, nên biến này là ứng viên rõ ràng để loại trước khi đặt tên nhân tố.
◆ Câu hỏi 9 / 9 · Đọc bảng kết quả
Đọc bảng kết quả EFA trong SPSS như thế nào cho một luận văn?
Trả lời thẳng: Đường dẫn chạy EFA trong SPSS là Analyze, Dimension Reduction, Factor. Trình tự đọc kết quả nên đi theo đúng thứ tự các điều kiện đã trình bày ở trên, từ kiểm tra dữ liệu có phù hợp hay không, đến trích xuất, xoay nhân tố, rồi mới đọc hệ số tải và đặt tên nhân tố, thay vì nhảy thẳng vào bảng hệ số tải.
Bằng chứng: CASRAI Editorial Board (n.d.-a) chỉ ra đường dẫn Analyze, Dimension Reduction, Factor, và lưu ý phương pháp trích xuất mặc định trong hộp thoại này là Principal Components, tức PCA chứ không phải EFA. Kiểm tra độ tin cậy nội tại của một thang đo và kiểm tra cấu trúc nhân tố của thang đo đó là hai bước bổ sung cho nhau trước khi đưa biến tổng hợp vào các mô hình phân tích sâu hơn. Tavakol và Dennick (2011) giải thích mối liên hệ giữa hai bước này, vì khi phân tích nhân tố cho thấy các mục hỏi của một thang đo thực chất thuộc nhiều nhân tố, giả định nền của alpha "bị vi phạm và alpha đánh giá thấp độ tin cậy của bài kiểm tra" (Tavakol & Dennick, 2011, tr. 54).
Ví dụ: Trình tự đọc kết quả hợp lý là nêu KMO và Bartlett trước để chứng minh dữ liệu phù hợp, tiếp theo nêu số nhân tố giữ lại và căn cứ chọn số đó, rồi trình bày bảng hệ số tải đã xoay kèm ngưỡng đã chọn, cuối cùng đặt tên từng nhân tố dựa trên nội dung các mục hỏi tải cao nhất. Việc rút gọn một tập mục hỏi ban đầu xuống còn vài nhân tố chính là mục tiêu chung của một quy trình EFA đầy đủ như vậy. Bài Thang đo SERVQUAL 22 mục hoạt động thế nào trên thực tế mô tả cách thang đo SERVQUAL gộp mười thành phần ban đầu thành năm thành phần chất lượng dịch vụ trong phiên bản 1988, dùng bảng hỏi 22 cặp phát biểu. Nhiều luận văn dùng SERVQUAL cho dữ liệu riêng của mình nên kiểm định lại cấu trúc nhân tố đó bằng EFA, thay vì mặc định năm thành phần gốc giữ nguyên trong mọi bối cảnh. Bài Cách trình bày và mã hoá thang đo Likert 5 mức độ cũng nhắc Cronbach's alpha và phân tích nhân tố là hai cách kiểm tra một thang đo tổng hợp có đủ tin cậy để dùng trong phân tích tiếp theo hay không. Sau khi cấu trúc nhân tố đã hình thành, bước kế tiếp thường là kiểm định nó bằng phân tích nhân tố khẳng định CFA trên một mẫu độc lập.
Câu hỏi thường gặp
EFA và PCA có phải là một không?
Không. PCA phân tích tổng phương sai và tạo thành phần là tổ hợp trọng số của các biến, không giả định biến tiềm ẩn hay sai số đo lường. EFA phân tích phương sai chung, mô hình hoá mỗi biến như một hàm của nhân tố chung cộng sai số riêng, và đây mới là kỹ thuật đúng nghĩa để tìm cấu trúc tiềm ẩn.
KMO dưới 0,5 thì phải làm gì?
Kiểm tra chỉ số MSA của từng biến, loại biến có MSA thấp nhất, rồi tính lại KMO và Bartlett trên tập rút gọn. Đây là một hướng xử lý chuẩn, không phải chỉ tăng cỡ mẫu, vì cỡ mẫu lớn hơn không tự sửa được tình trạng một biến đóng góp chủ yếu là nhiễu.
Eigenvalue nhỏ hơn 1 có được giữ lại không?
Theo quy tắc Kaiser gốc thì không, nhưng bản thân quy tắc này bị phê phán vì dễ trích xuất thừa nhân tố. Nên đối chiếu thêm phân tích song song hoặc scree plot trước khi quyết định số nhân tố cuối cùng.
Hệ số tải nhân tố bao nhiêu thì bị coi là biến rác cần loại?
Không có một con số duy nhất cho mọi nghiên cứu. 0,3 là sàn tối thiểu theo một số tài liệu, 0,5 trở lên được CASRAI Editorial Board xem là mức mạnh, và quan trọng nhất là nêu rõ ngưỡng mình chọn trước khi đọc bảng kết quả.
EFA chạy xong có cần làm CFA nữa không?
Nên làm nếu có mẫu độc lập hoặc thu thập được dữ liệu mới, vì chạy CFA trên cùng dữ liệu đã dùng cho EFA không phải là một phép xác nhận thật sự đối với cấu trúc vừa tìm ra.
KMO là gì?
KMO là chỉ số cho biết các biến có đủ tương quan chung để việc rút nhân tố đáng làm, và Watkins (2018) cho biết chỉ số này chạy từ 0 đến 1, tính được cho toàn ma trận cũng như cho từng biến.
KMO bao nhiêu là đạt trong luận văn?
KMO bao nhiêu là đạt còn tuỳ nguồn bạn chọn, vì IBM (2021) nói dưới 0,50 thì kết quả phân tích nhân tố có lẽ không hữu ích, CASRAI Editorial Board (n.d.-b) dùng 0,60 làm sàn thận trọng, còn Watkins (2018) mong muốn KMO tổng thể từ 0,70 trở lên. Bạn nên nêu mức đã chọn cùng nguồn của nó trong phần phương pháp.
Cỡ mẫu tối thiểu bao nhiêu để chạy EFA cho luận văn thạc sĩ?
Lượng mẫu cần đến tuỳ vào mức communality quan sát được và số mục hỏi đại diện cho mỗi nhân tố, không có một mức chung cho mọi đề tài. Watkins (2018) nhắc lại tỷ lệ 5:1 hoặc 10:1 như khuyến nghị ban đầu, nhưng nên xem đây là điểm xuất phát, không phải quy tắc cố định.
Nên làm gì tiếp theo
Câu hội đồng hay hỏi ở phần EFA là vì sao bạn giữ đúng số nhân tố đó và vì sao loại biến này mà giữ biến kia, nên bước kiểm tra MSA từng biến và tiêu chí giữ nhân tố cần có lý do rõ ràng từ trước. Chuyên gia của MAAS cùng bạn thống nhất tiêu chí giữ nhân tố và ngưỡng hệ số tải, chạy EFA trên chính dữ liệu của bạn từ bước KMO và Bartlett tới bảng hệ số tải đã xoay, giải thích từng thao tác và bàn giao cú pháp lệnh để bạn tự chạy lại. Phần đặt tên và diễn giải nhân tố trong luận văn do bạn viết, chuyên gia góp ý. Cách làm việc và báo giá nằm ở trang dịch vụ hỗ trợ xử lý số liệu luận văn, còn nếu muốn gửi bảng hỏi để hỏi trước thì bạn có thể đặt buổi tư vấn miễn phí 20 phút.
References
- Brown, T. A. (2015). Confirmatory factor analysis for applied research (2nd ed.). Guilford Press.
- CASRAI Editorial Board. (n.d.-a). Exploratory factor analysis: Extraction, rotation, and how many factors to retain. CASRAI. https://casrai.org/guides/exploratory-factor-analysis
- CASRAI Editorial Board. (n.d.-b). KMO and Bartlett's test: Is your data factorable? CASRAI. https://casrai.org/guides/kmo-and-bartletts-test
- Field, A. (2005). Factor analysis using SPSS [Handout]. University of Sussex. https://users.sussex.ac.uk/~andyf/factor.pdf
- IBM. (n.d.). Factor analysis descriptives. IBM SPSS Statistics 30.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/30.0.0?topic=analysis-factor-descriptives
- IBM. (2021). KMO and Bartlett's test. IBM SPSS Statistics 28.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/28.0.0?topic=detection-kmo-bartletts-test
- Kaiser, H. F. (1974). An index of factorial simplicity. Psychometrika, 39(1), 31-36. https://doi.org/10.1007/BF02291575
- MacCallum, R. C., Widaman, K. F., Zhang, S., & Hong, S. (1999). Sample size in factor analysis. Psychological Methods, 4(1), 84-99. https://doi.org/10.1037/1082-989X.4.1.84
- Tavakol, M., & Dennick, R. (2011). Making sense of Cronbach's alpha. International Journal of Medical Education, 2, 53-55. https://doi.org/10.5116/ijme.4dfb.8dfd
- Watkins, M. W. (2018). Exploratory factor analysis: A guide to best practice. Journal of Black Psychology, 44(3), 219-246. https://doi.org/10.1177/0095798418771807
- Williams, B., Onsman, A., & Brown, T. (2010). Exploratory factor analysis: A five-step guide for novices. Australasian Journal of Paramedicine, 8(3), 1-13. https://doi.org/10.33151/ajp.8.3.93
Buổi tư vấn miễn phí 20 phút là một cuộc trao đổi về việc bạn đang ở đâu với bài của mình.
Đặt lịch tư vấn miễn phí ▸