
Thang đo Likert 5 mức độ là một dạng câu hỏi khảo sát có 5 phương án trả lời xếp theo thứ tự tăng dần, từ rất không đồng ý đến rất đồng ý. Nhà tâm lý học xã hội Rensis Likert đề xuất thang đo này năm 1932 để lượng hoá thái độ, ý kiến hoặc mức độ đồng thuận của người trả lời.
Cập nhật lần cuối: 2026-09-13
Chuyên mục: research-methods
Thang đo Likert là gì và ra đời khi nào?
Trả lời thẳng: Thang đo Likert ra đời năm 1932, khi Rensis Likert công bố luận án "A Technique for the Measurement of Attitudes" trên Archives of Psychology. Trước đó, phương pháp phổ biến là thang Thurstone, dùng giám khảo phân loại phát biểu để dàn đều các bậc thái độ. Likert đề xuất cộng điểm theo 5 mức, đạt độ tin cậy gần bằng phương pháp Sigma của ông, vẫn tương quan với Thurstone dù dùng ít câu hỏi hơn.
Bằng chứng: Likert (1932) trình bày phương pháp ngay trong luận án tại Đại học Columbia, thực hiện dưới sự hướng dẫn của Gardner Murphy, người khởi xướng một dự án năm 1929 về đo lường thái độ xã hội, trong đó có thái độ về quan hệ chủng tộc. SAGE Publications (2010) ghi nhận rằng Likert từng ca ngợi phương pháp cộng điểm có trọng số phức tạp hơn của chính ông, gọi là phương pháp Sigma, nhưng phát hiện cách cộng điểm đơn giản đạt độ tin cậy split-half và test-retest gần tương đương phương pháp Sigma đó. Cùng nguồn này ghi nhận điểm số theo cách cộng đơn giản vẫn tương quan chặt với thang Thurstone dù chỉ dùng khoảng một nửa số câu hỏi. Chính Likert (1932) mô tả quy trình của Thurstone là nỗ lực dàn đều khoảng cách giữa các bậc thái độ bằng các phương pháp tâm vật lý (psychophysics), coi cách dùng giám khảo là chỗ nghiên cứu của ông rời hẳn khỏi Thurstone, và nhận xét quy trình đó cực kỳ tốn công. Dữ liệu của luận án đến từ bảng hỏi Survey of Opinions, phát cho sinh viên đại học, phần lớn là nam, ở chín trường trải từ Illinois tới Connecticut. Tổng số người tham gia hơn 2.000, nhưng phần phân tích sâu chỉ dùng 650 người chọn ngẫu nhiên từ bảy nhóm. Với phần lớn các nhóm, lần đo đầu diễn ra cuối mùa thu năm 1929, mất trung bình khoảng 40 phút, và lần đo lại cách đó 30 ngày (Likert, 1932, tr. 14).
Ví dụ: Nếu bạn đọc một đề cương luận văn chỉ ghi "sử dụng thang đo Likert" mà không nói rõ vì sao chọn 5 mức thay vì một phương pháp đo thái độ khác, đó là chỗ đáng bổ sung một câu giải thích ngắn, dựa trên chính lý do lịch sử này: thang Likert được chọn vì đơn giản hơn, tốn ít thời gian khảo sát hơn, mà vẫn giữ được độ tin cậy cần thiết.
Thang đo Likert 5 mức độ có những dạng nào?
Trả lời thẳng: Bộ nhãn 5 mức gốc do Likert đề xuất là Rất phản đối, Phản đối, Chưa quyết định, Tán thành, Rất tán thành. Về sau, dạng "mức độ đồng ý" phổ biến hơn: Rất không đồng ý, Không đồng ý, Trung lập, Đồng ý, Rất đồng ý. Quy tắc mã hoá gốc là gán giá trị từ 1 đến 5, với 3 luôn là "trung lập", còn hai đầu thang gán 1 và 5 theo chiều thái độ.
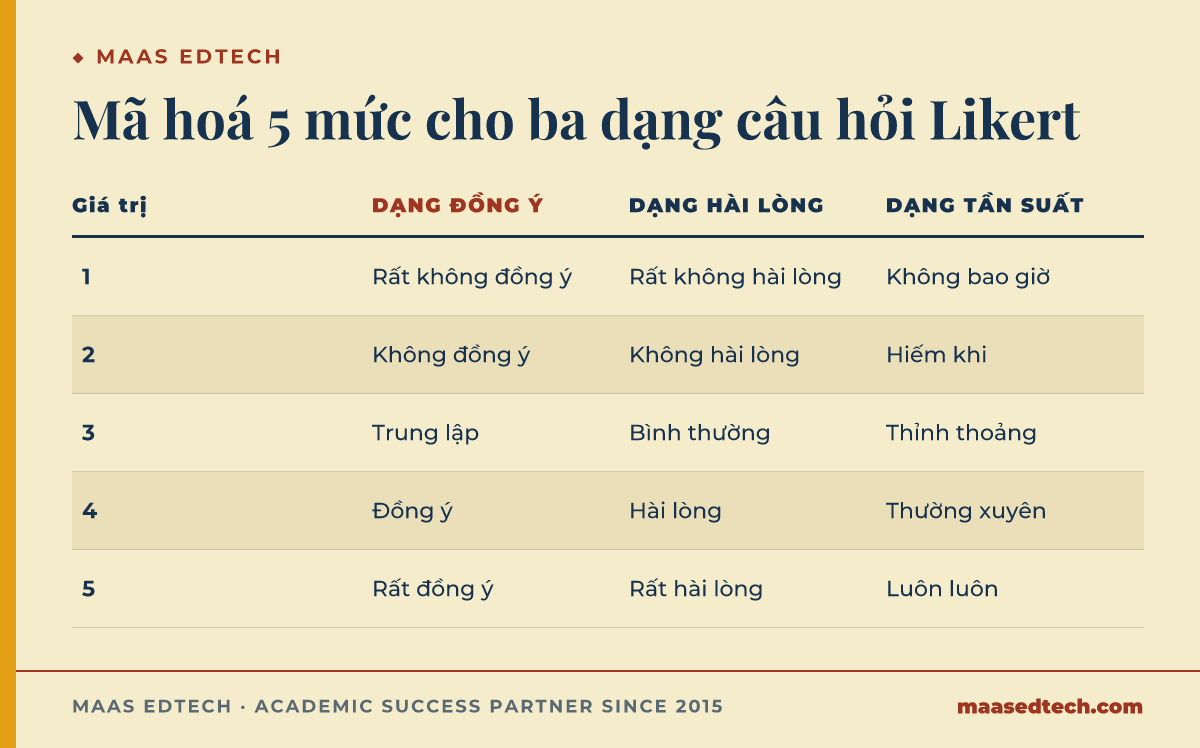
Bằng chứng: Wikipedia (n.d.), dẫn lại nội dung luận án gốc của Likert (1932), mô tả cấu trúc 5 mức "đồng ý/không đồng ý" là dạng phổ biến nhất hiện nay, đồng thời ghi nhận biến thể mở rộng thêm hai mức để tạo thang 7 mức. Likert (1932), trong phần phụ lục của chính luận án đó (trang 44-53), nêu rõ quy tắc gán số 1 đến 5 và vị trí cố định của mức trung lập.
Ví dụ: Một bảng dưới đây cho thấy cách áp dụng cùng một logic mã hoá cho bốn dạng câu hỏi khảo sát phổ biến, không chỉ riêng dạng "đồng ý/không đồng ý".
| Giá trị mã hoá | Dạng đồng ý | Dạng hài lòng | Dạng tần suất | Dạng quan trọng |
|---|---|---|---|---|
| 1 | Rất không đồng ý | Rất không hài lòng | Không bao giờ | Hoàn toàn không quan trọng |
| 2 | Không đồng ý | Không hài lòng | Hiếm khi | Ít quan trọng |
| 3 | Trung lập | Bình thường | Thỉnh thoảng | Trung bình |
| 4 | Đồng ý | Hài lòng | Thường xuyên | Quan trọng |
| 5 | Rất đồng ý | Rất hài lòng | Luôn luôn | Rất quan trọng |
Một câu hỏi Likert và một thang đo Likert có phải là một không?
Trả lời thẳng: Không. Một "Likert item" (mục hỏi Likert) là một câu phát biểu đơn lẻ, bản thân nó là dữ liệu thứ bậc (ordinal). Một "Likert scale" (thang đo Likert đúng nghĩa) là điểm số tổng hợp, thường là tổng hoặc trung bình, của nhiều mục hỏi cùng đo một khái niệm. Việc gọi một câu hỏi đơn lẻ là "thang đo Likert" là một nhầm lẫn phổ biến trong văn liệu (Wikipedia, n.d.).
Bằng chứng: Boone và Boone (2012) phân biệt rõ "Likert-type item" (từng mục riêng, phân tích bằng median hoặc mode) với "Likert scale" (điểm tổng hợp từ nhiều mục đã kiểm tra độ tin cậy, có thể phân tích bằng mean và độ lệch chuẩn). Theo Boone và Boone, một thang đo tổng hợp có thể hình thành từ bốn mục hỏi trở lên, và chính Likert chỉ phân tích điểm tổng hợp của cả bộ câu hỏi chứ không phân tích từng câu riêng lẻ. Hai tác giả dẫn lại Clason và Dormody, những người đã mô tả sự khác biệt giữa mục hỏi dạng Likert và thang đo Likert từ năm 1994. Wikipedia (n.d.) cũng nêu Likert (1932) tự phân biệt "thang đo" hình thành từ tập hợp phản hồi cho một bộ mục hỏi, thường từ tám mục trở lên, khác với định dạng chấm điểm cho từng mục riêng lẻ. Cùng trang này ghi nhận mốc thường dùng để cộng điểm nhiều mục rồi xử lý như dữ liệu khoảng là tối thiểu bốn mục và tốt nhất là tám mục. Ngưỡng số mục hỏi tối thiểu vì vậy khác nhau tuỳ tài liệu, nhưng nguyên tắc cốt lõi vẫn giống nhau, một thang đo tổng hợp cần nhiều hơn một mục hỏi đo cùng khái niệm.
Ví dụ: Nếu bảng hỏi của bạn chỉ có một câu "Tôi hài lòng với dịch vụ này" với 5 mức trả lời, đó là một Likert item, không phải Likert scale. Muốn có một Likert scale đo khái niệm "sự hài lòng", bạn cần nhiều câu hỏi cùng đo khía cạnh này rồi cộng hoặc lấy trung bình điểm của chúng, sau khi đã kiểm tra độ tin cậy nội tại của bộ câu hỏi đó.
Vì sao thang đo Likert 5 mức độ gây tranh cãi trong xử lý thống kê?
Trả lời thẳng: Dữ liệu Likert nên xử lý như ordinal hay như gần-interval là một tranh cãi kéo dài trong văn liệu giáo dục y khoa (Sullivan & Artino, 2013). Phía ủng hộ ordinal cho rằng khoảng cách tâm lý giữa các mức trả lời không chắc đều nhau. Phía còn lại cho rằng thang đo tổng hợp phân phối liên tục hơn, nên kiểm định tham số vẫn đủ tin cậy.
Bằng chứng: Sullivan và Artino (2013), trong bài đăng trên Journal of Graduate Medical Education, gọi đây là "the controversy" (tr. 542) và tổng kết cả hai luồng lập luận. Phía ủng hộ kiểm định tham số cho rằng kiểm định tham số dùng được nếu cỡ mẫu đủ, ít nhất 5 tới 10 quan sát mỗi nhóm, và dữ liệu phân phối chuẩn hoặc gần chuẩn. Hai tác giả dẫn tổng quan năm 2010 của Geoff Norman trên Advances in Health Sciences Education, người dùng cả dữ liệu thật lẫn dữ liệu mô phỏng để cho thấy kiểm định tham số thường vững hơn kiểm định phi tham số, kể cả khi giả định phân phối chuẩn bị vi phạm tới mức cực đoan. Họ kết luận rằng "parametric tests can be used to analyze Likert scale responses" (Sullivan & Artino, 2013, tr. 542), đồng thời khuyến nghị trình bày phân phối tần suất bên cạnh giá trị trung bình, vì trung bình chỉ có ý nghĩa rõ ràng khi dữ liệu gần phân phối chuẩn. Cùng bài viết này cảnh báo không nên báo cáo giá trị trung bình với quá nhiều chữ số thập phân, vì dữ liệu gốc là các số nguyên rời rạc từ một thang hữu hạn, và số thập phân dài không phản ánh thêm thông tin thực. Riêng sự phân biệt cách xử lý theo median hoặc mode cho từng mục hỏi và mean cùng độ lệch chuẩn cho một thang đo tổng hợp là khuyến nghị của Boone và Boone (2012), không phải của Sullivan và Artino.
Ví dụ: Một cách hiểu nhầm là cho rằng chọn "Measure = Scale" trong SPSS nghĩa là dữ liệu Likert đã được công nhận là interval. Đây là hiểu nhầm: "Scale" trong SPSS chỉ là một quy ước đặt tên thuộc tính biến (Nominal, Ordinal, Scale), không phải một tuyên bố học thuật về bản chất đo lường của thang Likert, vốn vẫn là chủ đề tranh luận như đã trình bày ở trên.
Thang đo Likert 5 mức độ khác thang đo Likert 7 mức độ ở điểm nào?
Trả lời thẳng: Likert bản gốc dùng thang 5 mức. Về sau, nhiều nhà nghiên cứu mở rộng thêm một cặp phương án ở hai bên vị trí trung lập, chẳng hạn "hơi đồng ý" và "hơi không đồng ý", để tạo thang 7 mức. Cả hai dạng đều phổ biến, và số mức phù hợp còn tuỳ mục tiêu và đối tượng khảo sát của từng đề tài.
Bằng chứng: Wikipedia (n.d.) mô tả mục Likert 7 mức là mục 5 mức được bổ sung hai phương án nằm sát điểm giữa, ví dụ "slightly agree" và "slightly disagree". Cùng nguồn này ghi nhận số mức trả lời của một mục Likert thường nằm trong khoảng 2 tới 10, trong đó 3, 5 và 7 mức hay gặp nhất. Nguồn này không xếp hạng dạng nào tốt hơn. Boone và Boone (2012) cũng cho thấy số mức trong thực tế công bố rất đa dạng, khi đếm được ít nhất 12 bài trên Journal of Extension năm 2011 dùng một dạng trả lời Likert, trong đó có cả thang 4, 5, 6 và 7 mức, cùng ít nhất 21 bài năm 2010. Vì vậy chọn 5 hay 7 mức là một quyết định thiết kế mà bạn cần tự giải thích trong phần phương pháp.
Ví dụ: Một khảo sát đo mức độ hài lòng của sinh viên với một môn học có thể dùng thang 5 mức nếu mục tiêu là khảo sát nhanh, đại trà. Nếu đề tài luận văn cần phân biệt tinh tế hơn giữa các mức thái độ, chẳng hạn nghiên cứu tâm lý học về động lực học tập, thang 7 mức có thể phù hợp hơn, miễn là bảng hỏi vẫn dễ hiểu với đối tượng khảo sát.
Có bắt buộc phải có phương án trung lập ở giữa thang không?
Trả lời thẳng: Không bắt buộc. Có biến thể thang chẵn điểm, chẳng hạn 4 hoặc 6 mức, bỏ hẳn phương án trung lập, gọi là thang "buộc chọn" (forced-choice). Dạng này dùng khi nhà nghiên cứu muốn ép người trả lời nghiêng về một phía thay vì né tránh ở giữa, thường vì mức trung lập có thể là lựa chọn dễ dãi khi người trả lời chưa chắc chắn.
Bằng chứng: Wikipedia (n.d.) ghi nhận có lúc người nghiên cứu dùng số phương án chẵn, bỏ hẳn mức "không đồng ý cũng không phản đối", và gọi cách này là "forced choice". Nguồn này giải thích rằng mức trung lập dễ trở thành lựa chọn an toàn khi người trả lời chưa chắc chắn, nên chưa hẳn phản ánh một thái độ trung lập thật. Cùng nguồn này dẫn một nghiên cứu năm 1987 cho thấy khác biệt không đáng kể giữa việc ghi nhãn mức giữa là "chưa quyết định" (undecided) hay "trung lập" (neutral) trong một mục 5 mức.
Ví dụ: Nếu đề bài của bạn khảo sát một chủ đề nhạy cảm, chẳng hạn thái độ với một chính sách gây tranh cãi, một thang chẵn điểm có thể giúp thu được câu trả lời rõ ràng hơn thay vì để người trả lời dồn về mức giữa. Với hầu hết khảo sát học thuật thông thường, giữ nguyên mức trung lập theo thiết kế gốc của Likert vẫn là lựa chọn phổ biến và dễ giải thích trong phần phương pháp.
Mục hỏi đảo chiều trong thang đo Likert được mã hoá thế nào?
Trả lời thẳng: Mục hỏi đảo chiều là phát biểu viết ngược hướng với phần lớn các câu còn lại trong cùng một thang đo, ví dụ "Tôi thấy môn học này tẻ nhạt" đặt cạnh "Tôi thấy môn học này thú vị". Trước khi cộng điểm, cần đổi chiều mã hoá các mục này, 1 thành 5, 2 thành 4, còn 3 giữ nguyên, để điểm cao ở mọi mục mang cùng một nghĩa (Likert, 1932).
Bằng chứng: Likert (1932), trong phụ lục hướng dẫn dựng thang đo, khuyên viết khoảng một nửa số phát biểu sao cho đầu thái độ đang đo nằm ở phía "Strongly approve", nửa còn lại nằm ở phía "Strongly disapprove", rồi rải hai loại này ngẫu nhiên trong bảng hỏi để tránh xu hướng trả lời rập khuôn. Thang Internationalism trong luận án làm đúng như vậy, mục 16 gán 5 điểm cho "Strongly disapprove" còn mục 17 ngay sau đó gán 5 điểm cho "Strongly approve" (Likert, 1932, tr. 17). Cũng trong phụ lục, Likert đề nghị tính hệ số tương quan giữa từng phát biểu với tổng điểm cả bộ, vì hệ số âm cho thấy phát biểu đó đã bị gán điểm ngược chiều, còn hệ số bằng 0 hoặc rất thấp cho thấy phát biểu không phân biệt được người có thái độ khác nhau. Wikipedia (n.d.) gọi cách cân bằng này là balanced keying và ghi nhận nó hạn chế được acquiescence bias, tức xu hướng đồng ý với mọi câu, nhưng khó xử lý hơn với xu hướng né hai đầu thang.
Ví dụ: Trong một bảng hỏi 6 mục đo sự hài lòng với môn học, giả sử mục 4 là "Nhiều buổi học của môn này lãng phí thời gian của tôi". Người chọn Rất đồng ý ở mục này phải được mã hoá 1 điểm chứ không phải 5 điểm. Nếu quên đổi chiều, hệ số tương quan giữa mục 4 và tổng điểm thường sẽ âm, đúng dấu hiệu Likert đã mô tả, và Cronbach's alpha của cả bộ thường giảm theo, nên đây là chỗ nên kiểm tra đầu tiên khi alpha thấp bất thường.
Cách trình bày và mã hoá thang đo Likert 5 mức độ trong bài nghiên cứu
Trả lời thẳng: Khi viết phần phương pháp, cần nêu rõ số mức đã chọn, lý do chọn 5 mức, bộ nhãn cụ thể, và quy tắc mã hoá áp dụng cho toàn bộ bảng hỏi. Nếu bảng hỏi dùng nhiều mục hỏi đo một khái niệm, cần nói rõ đây là một Likert scale tổng hợp, không phải từng Likert item tách rời, và nêu chỉ số độ tin cậy đã kiểm, thường là Cronbach's alpha.
Bằng chứng: Boone và Boone (2012) khuyến nghị dùng median hoặc mode khi chỉ báo cáo từng mục hỏi riêng lẻ, và dùng mean cùng độ lệch chuẩn khi đã có một thang đo tổng hợp từ nhiều mục hỏi đã kiểm tra độ tin cậy. Bảng gợi ý của hai tác giả đi tiếp tới phần kiểm định, với dữ liệu từng mục thì dùng hệ số Kendall tau B hoặc C và kiểm định chi bình phương, còn với điểm thang đo tổng hợp thì dùng hệ số tương quan Pearson, t-test, ANOVA và hồi quy (Boone & Boone, 2012). Để có bằng chứng rằng các mục trong một thang đo tổng hợp tương quan đủ chặt và cùng đo một biến tiềm ẩn, Sullivan và Artino (2013) gợi ý dùng Cronbach's alpha, hệ số Kappa hoặc phân tích nhân tố. Một ngưỡng thường gặp trong thực hành để coi thang đo tổng hợp đó đủ tin cậy là hệ số Cronbach's alpha từ 0,70 trở lên. Phần kiểm định độ tin cậy này được xử lý chi tiết hơn ở bài SPSS thực hiện được những nhóm kiểm định thống kê nào, vì đây là bước chạy trên phần mềm sau khi đã hiểu đúng bản chất thang đo.
Ví dụ: Một đề cương chỉ ghi "khảo sát dùng thang đo Likert 5 mức độ, xử lý số liệu bằng SPSS" chưa cho hội đồng thấy bạn hiểu rõ mình đang đo gì. Viết cụ thể hơn, chẳng hạn "khảo sát dùng thang Likert 5 mức độ đo mức độ đồng ý, gồm 6 mục hỏi cho khái niệm sự hài lòng, mã hoá 1 đến 5 với 3 là trung lập, kiểm tra độ tin cậy bằng Cronbach's alpha trước khi phân tích", giúp phần phương pháp của bạn có căn cứ rõ ràng, đúng như phần công cụ đo lường mà một đề cương chuẩn cần trình bày. Xem đề cương luận văn thạc sĩ gồm những phần nào để biết phần công cụ đo lường cần viết chi tiết tới mức nào.
Câu hỏi thường gặp
Thang đo Likert là gì?
Thang đo Likert là một dạng câu hỏi khảo sát có các phương án trả lời xếp theo thứ tự, do Rensis Likert đề xuất năm 1932 để lượng hoá thái độ hoặc ý kiến của người trả lời, phổ biến nhất ở dạng 5 mức hoặc 7 mức.
Thang đo Likert 5 mức độ khác gì thang đo Likert 7 mức độ?
Thang 5 mức độ là dạng gốc do Likert đề xuất năm 1932. Thang 7 mức độ có thêm hai phương án nằm sát mức "trung lập", ví dụ "hơi đồng ý". Việc chọn số mức là quyết định thiết kế tuỳ đề tài, không phải quy tắc cố định cho mọi khảo sát.
Một câu hỏi Likert có được gọi là "thang đo Likert" không?
Không hoàn toàn chính xác. Một câu hỏi đơn lẻ là "Likert item", dữ liệu thứ bậc. "Likert scale" đúng nghĩa là điểm tổng hợp từ nhiều mục hỏi cùng đo một khái niệm, sau khi đã kiểm tra độ tin cậy nội tại.
Dữ liệu Likert có được tính giá trị trung bình không?
Với từng mục hỏi riêng lẻ, nhiều nhà phương pháp luận khuyến nghị dùng median hoặc mode thay vì mean. Với một thang đo tổng hợp từ nhiều mục hỏi đã kiểm tra độ tin cậy, mean và độ lệch chuẩn được nhiều nhà nghiên cứu chấp nhận sử dụng.
Có bắt buộc phải có phương án trung lập ở giữa thang không?
Không bắt buộc. Có biến thể thang chẵn điểm bỏ hẳn phương án trung lập, gọi là thang buộc chọn, dùng khi nhà nghiên cứu muốn tránh người trả lời né tránh ở mức giữa.
MAAS hỗ trợ gì khi tôi dùng thang đo Likert trong khảo sát của mình?
Chọn sai số mức hoặc mã hoá sai chiều là lỗi khó phát hiện tới khi chạy phân tích. Chuyên gia của MAAS rà lại lựa chọn này cùng bạn trước khi bạn phát bảng hỏi, sau đó ngồi cùng bạn khi kiểm tra độ tin cậy và đọc kết quả trên chính dữ liệu bạn thu thập. Buổi tư vấn đầu tiên 15 phút, không tính phí, xem dịch vụ hướng dẫn chạy SPSS và Python hoặc đặt lịch tại đây.
References
- Boone, H. N., & Boone, D. A. (2012). Analyzing Likert data. Journal of Extension, 50(2), Article 48. https://doi.org/10.34068/joe.50.02.48
- Likert, R. (1932). A technique for the measurement of attitudes. Archives of Psychology, 22(140), 1-55.
- SAGE Publications. (2010). Likert scaling. In Encyclopedia of research design. Retrieved September 13, 2026, from https://sk.sagepub.com/ency/edvol/download/researchdesign/chpt/likert-scaling.pdf
- Sullivan, G. M., & Artino, A. R. (2013). Analyzing and interpreting data from Likert-type scales. Journal of Graduate Medical Education, 5(4), 541-542. https://doi.org/10.4300/JGME-5-4-18
- Wikipedia. (n.d.). Likert scale. Retrieved September 13, 2026, from https://en.wikipedia.org/wiki/Likert_scale
Tools & resources
- Likert, R. (1932). The method of constructing an attitude scale (trích phụ lục, tr. 44-53, của A technique for the measurement of attitudes). Bản PDF lưu tại Simon Fraser University. https://www.sfu.ca/~palys/Likert-1933-TheMethodOfConstructingAnAttitudeScale.pdf