
◆ Phương pháp nghiên cứu
Các loại thang đo trong SPSS gồm những gì và chọn thế nào?
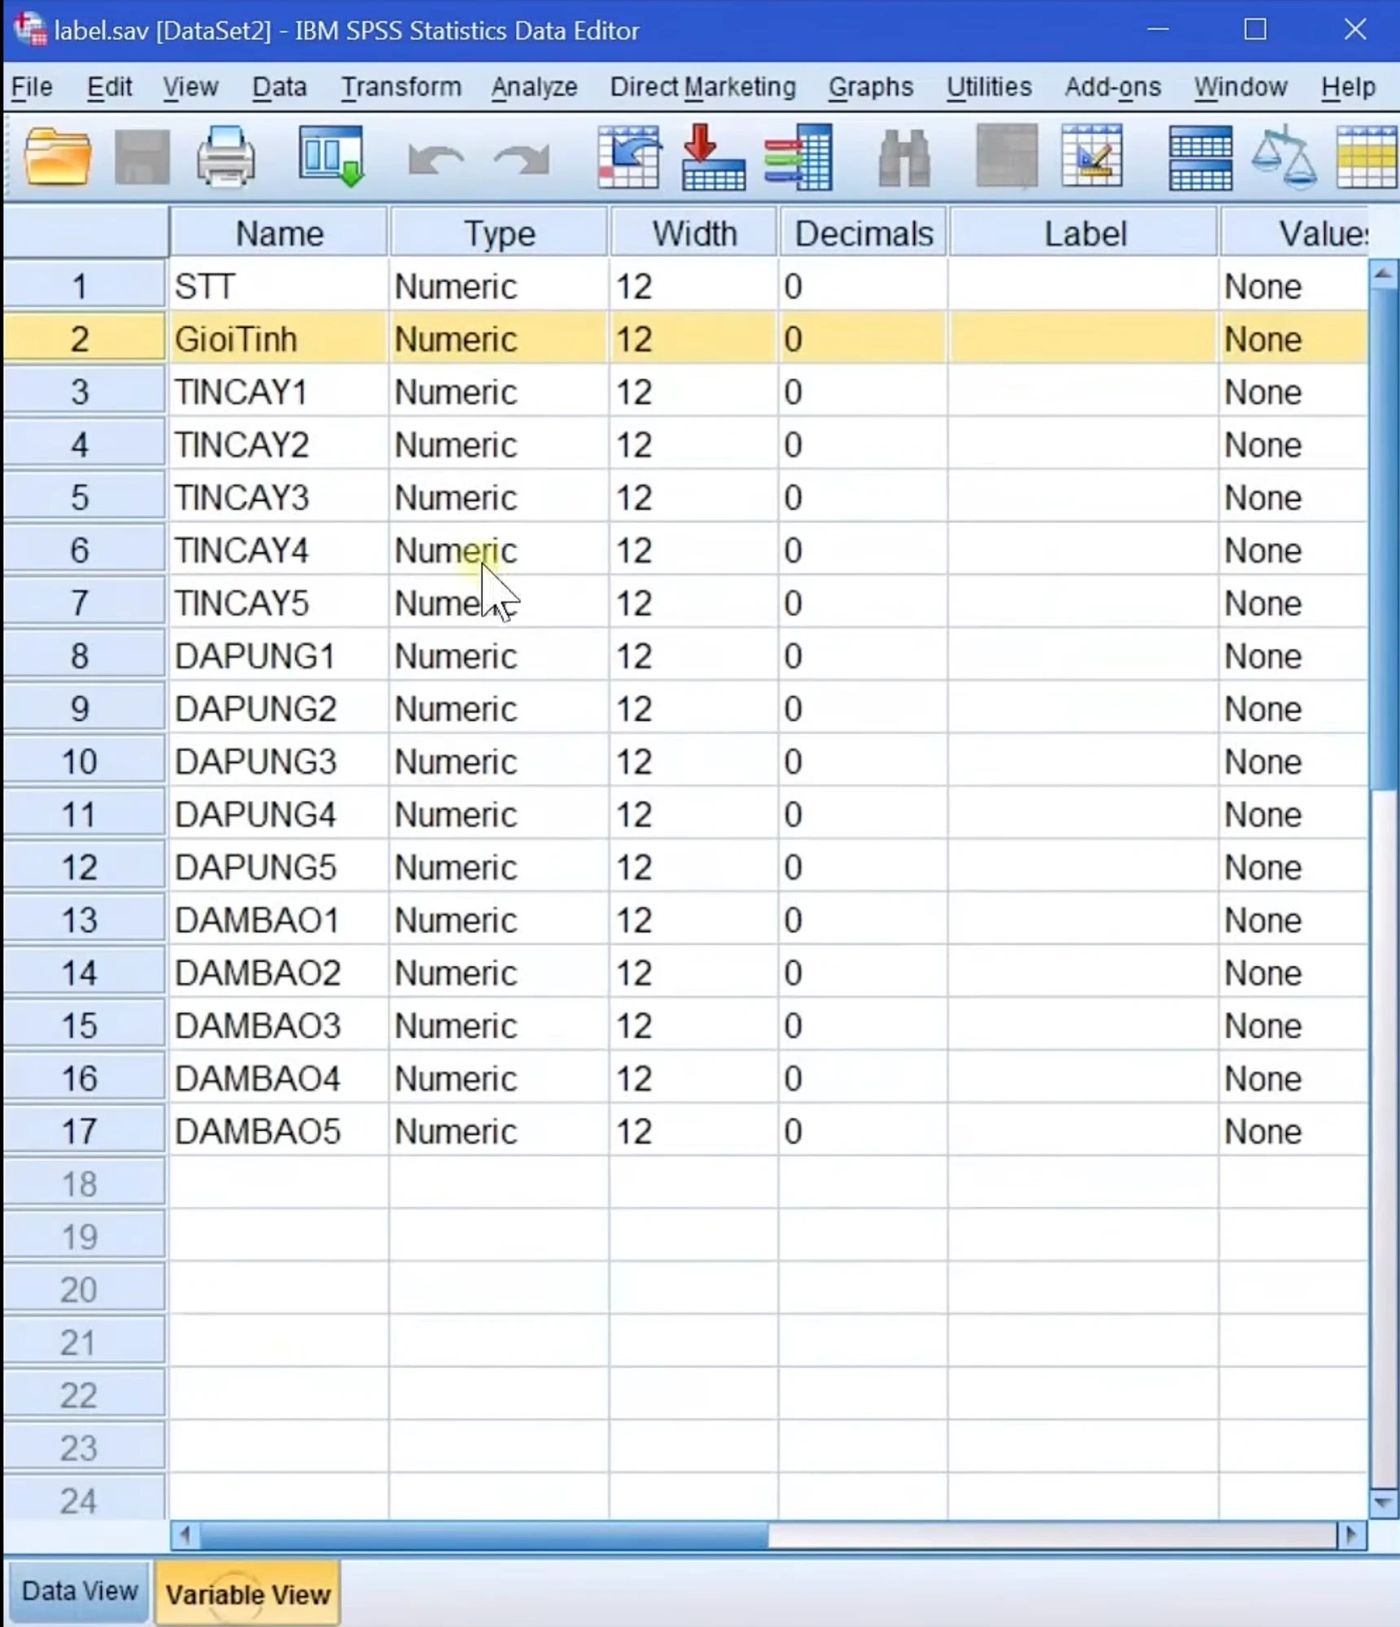
Trả lời thẳng: Các loại thang đo trong SPSS gồm ba mức ở cột Measure là Nominal, Ordinal và Scale, trong khi giáo trình dạy bốn thang đo nominal, ordinal, interval và ratio. SPSS gộp interval với ratio thành Scale, và tự gán mức đo mặc định cho biến mới, nên bạn cần rà lại từng biến trước khi chạy phân tích.
Các loại thang đo trong SPSS gồm những gì, và khác bốn thang đo trong giáo trình ra sao?
Trả lời thẳng: Các loại thang đo trong SPSS ở cột Measure của Variable View chỉ có Nominal, Ordinal và Scale. Scale là tên SPSS đặt cho cả thang đo khoảng lẫn thang đo tỷ lệ, nên một biến tuổi hay thu nhập đều được khai báo chung một mục dù chương phương pháp gọi chúng bằng hai tên khác nhau.
Khung bốn thang đo bắt nguồn từ nhà tâm lý học vật lý Stevens. Theo Williams (2021), Stevens (1946, tr. 677) định nghĩa đo lường là "the assignment of numerals to objects or events according to rules". Tài liệu của IBM (n.d.-a) mô tả ba mức trong phần mềm như sau: Nominal dành cho các phạm trù không có thứ hạng nội tại như vùng miền hay mã bưu chính, Ordinal dành cho các phạm trù có thứ hạng như mức hài lòng, còn Scale dành cho các giá trị có đơn vị đo mang nghĩa để so sánh khoảng cách, chẳng hạn tuổi tính theo năm. Bạn có thể đọc thêm về nền tảng lý thuyết ở trang Level of measurement và về người đề xuất khung này ở trang Stanley Smith Stevens. Nếu bạn mới làm quen với phần mềm, bài SPSS là gì và dùng để làm gì giải thích cách các cửa sổ Data View và Variable View liên hệ với nhau.
| Mức đo trong SPSS | Thang đo lý thuyết | Ví dụ theo IBM (n.d.-a) | Ghi chú khi viết chương phương pháp |
|---|---|---|---|
| Nominal | Nominal | Vùng miền, mã bưu chính, tôn giáo | Gọi là thang đo định danh |
| Ordinal | Ordinal | Mức hài lòng, điểm thái độ | Gọi là thang đo thứ bậc |
| Scale | Interval và ratio | Tuổi tính theo năm, thu nhập | Phải nêu rõ biến là khoảng hay tỷ lệ |
Nguồn: IBM (n.d.-a), đọc ngày 2026-10-31.
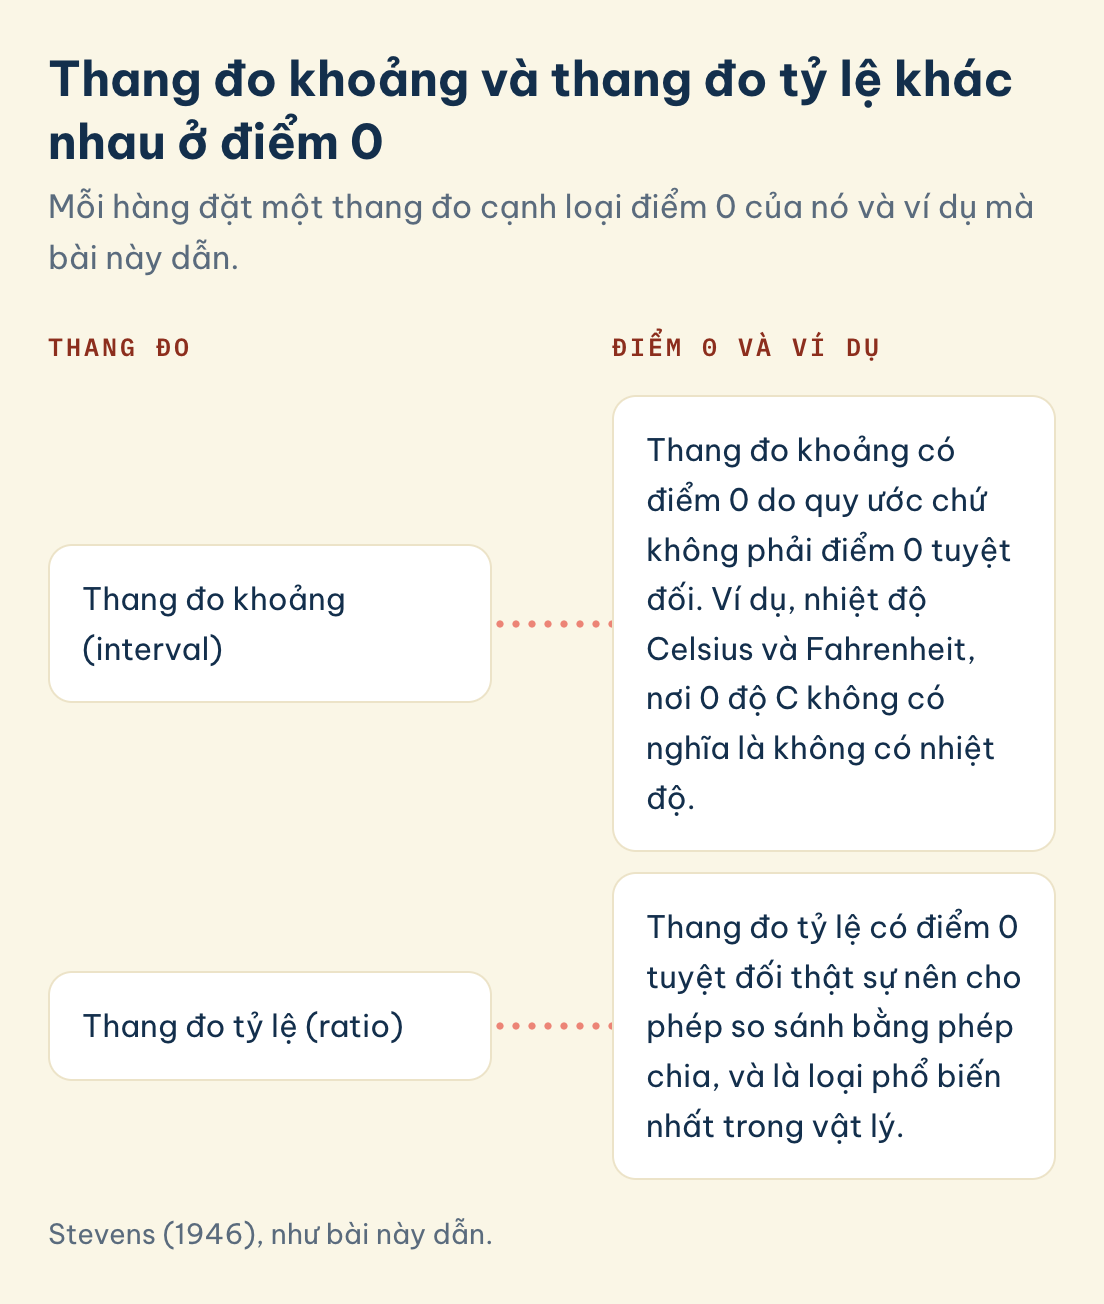
Sự khác nhau giữa hai thang đo gộp trong Scale nằm ở điểm 0. Stevens (1946) xếp nhiệt độ Celsius và Fahrenheit vào thang đo khoảng, vì 0 độ C là điểm do quy ước chứ không có nghĩa là không có nhiệt độ, còn thang đo tỷ lệ có điểm 0 tuyệt đối nên cho phép so sánh bằng phép chia.
Thang đo khoảng và thang đo tỷ lệ khác nhau ở điểm 0
Mỗi hàng đặt một thang đo cạnh loại điểm 0 của nó và ví dụ mà bài này dẫn.
Thang đo
Điểm 0 và ví dụ
Thang đo khoảng (interval)
Thang đo khoảng có điểm 0 do quy ước chứ không phải điểm 0 tuyệt đối. Ví dụ, nhiệt độ Celsius và Fahrenheit, nơi 0 độ C không có nghĩa là không có nhiệt độ.
Thang đo tỷ lệ (ratio)
Thang đo tỷ lệ có điểm 0 tuyệt đối thật sự nên cho phép so sánh bằng phép chia, và là loại phổ biến nhất trong vật lý.
Lưu hình này
SPSS tự gán mức đo mặc định cho biến mới theo quy tắc nào?
Trả lời thẳng: Với biến số tạo từ phép biến đổi, dữ liệu nhập từ nguồn ngoài hoặc tệp cũ, SPSS xét lần lượt một bảng điều kiện và áp mức đo của điều kiện đầu tiên khớp. Ngưỡng mặc định là 24 giá trị khác nhau: biến có từ 24 giá trị khác nhau trở lên được xếp là liên tục, ít hơn thì có thể bị xếp Nominal.
Quy tắc gán mức đo mặc định là chi tiết mà hầu hết bài hướng dẫn về các loại thang đo trong SPSS bỏ qua, và nó giải thích vì sao cùng một bộ dữ liệu lại cho ra những mức đo khác nhau giữa các máy. IBM (n.d.-a) liệt kê chín điều kiện, trong đó biến chứa ít nhất một giá trị không nguyên hoặc ít nhất một giá trị âm được xếp liên tục, biến không có giá trị hợp lệ nào nhỏ hơn 10.000 cũng được xếp liên tục, và biến mà mọi giá trị đều thiếu được xếp Nominal. Người dùng có thể đổi ngưỡng 24 trong hộp thoại Options. Định dạng cũng chi phối: IBM (n.d.-b) nêu rằng giá trị số nhỏ hơn 86.400 không hợp lệ với một biến mang định dạng ngày. Tài liệu hộp thoại Define Variable Properties của IBM (n.d.-b) còn lưu ý thêm rằng theo mặc định mọi biến số mới đều nhận mức Scale, nên nhiều biến thực chất là biến phân loại vẫn hiện ra như biến Scale lúc ban đầu. Cùng tài liệu ấy lưu ý rằng danh sách giá trị chỉ dựa trên số trường hợp đã quét, nên nếu bạn chỉ quét 100 trường hợp đầu của một tệp đã sắp xếp thì danh sách có thể ít giá trị hơn thực tế rất nhiều.
Hệ quả thực tế rất đơn giản: một biến khảo sát mã hoá 1 đến 5 chỉ có năm giá trị khác nhau, nhưng SPSS không đọc được ý nghĩa của các con số đó. Vì vậy phép gán tự động chỉ là gợi ý ban đầu, còn quyết định cuối cùng thuộc về người phân tích, người biết biến ấy đo cái gì. Sau bước này, bạn nên mở lại đồng thời các biến đếm và biến mã hoá, vì chính chúng hay bị xếp sai nhất.
Nominal khác Ordinal ở điểm nào, và khi nào nên chọn mức nào?
Trả lời thẳng: Chọn Nominal khi các giá trị chỉ là nhãn phân loại, chọn Ordinal khi các giá trị xếp được theo thứ tự nhưng khoảng cách giữa chúng không cố định. Khác biệt này quyết định bạn được mô tả biến bằng tần suất và mode, hay bằng cả trung vị và thứ hạng.
Một biến giới tính hay ngành học là Nominal, vì không có ngành nào "cao hơn" ngành nào, và con số 1, 2, 3 chỉ là mã. Một biến học lực gồm yếu, trung bình, khá và giỏi là Ordinal, vì thứ tự có nghĩa nhưng khoảng cách từ yếu đến trung bình chưa chắc bằng khoảng cách từ khá đến giỏi. Sullivan và Artino (2013), trong bài đăng ở tạp chí Journal of Graduate Medical Education, nhấn mạnh rằng phản hồi Likert là dữ liệu thứ bậc, vì khoảng cách giữa các phản hồi không đo được, và con số gán cho mỗi mức không chứng minh các mức cách đều nhau. Hai tác giả cũng khuyên không nên báo giá trị trung bình tới chữ số thập phân thứ 100, vì con số ấy không giúp người đọc hiểu thêm điều gì. Trang Ordinal data tóm tắt lại các phép thống kê thường dùng cho loại dữ liệu này.
Khi bạn viết chương phương pháp, hãy ghi mức đo ngay trong bảng mô tả biến để hội đồng thấy bạn biết biến nào được phép tính trung bình. Nếu cần tính độ phân tán sau đó, bài độ lệch chuẩn trong SPSS trình bày ba lệnh Descriptives, Frequencies và Explore, và bạn chỉ nên báo độ lệch chuẩn cho những biến đã khai Scale hợp lý.
Dữ liệu Likert nên khai báo là Ordinal hay Scale, và dùng kiểm định nào?
Trả lời thẳng: Từng câu Likert đơn lẻ nên khai báo Ordinal. Khai báo Ordinal không bắt bạn phải bỏ kiểm định tham số, vì các mô phỏng cho thấy t-test và kiểm định phi tham số thường có sức mạnh gần nhau trên dữ liệu năm mức, miễn bạn kiểm tra hình dạng phân phối.
de Winter và Dodou (2010) định nghĩa 14 phân phối dân số cho một câu Likert năm mức rồi so sánh t-test với Mann-Whitney-Wilcoxon (MWW) trên các cặp mẫu rút từ những phân phối đó. Kết quả là hai kiểm định có sức mạnh tương đương ở đa số cặp, và tỷ lệ sai lầm loại I của cả hai không bao giờ vượt mức danh nghĩa 5% quá 3 điểm phần trăm. MWW chiếm ưu thế khi một trong hai mẫu lệch hoặc nhọn, còn khác biệt rất mạnh giữa hai kiểm định xuất hiện khi một mẫu có phân phối đa đỉnh.
Lantz (2013) cho thấy người trả lời thường không cảm nhận các điểm của thang Likert cách đều nhau, và cách đặt nhãn lời quyết định chỗ nào bị kéo giãn. Trong phần mô phỏng so sánh trung bình giữa nhiều nhóm bằng ANOVA, Kruskal-Wallis, Brown-Forsythe và Welch, mỗi tổ hợp dùng 3 × 50.000 bộ số ngẫu nhiên, tức 150.000 bộ ở mức ý nghĩa 0,05, với thang bị bóp méo thành {0, 1,5, 2, 2,5, 4} để mô phỏng hiệu ứng đầu cuối thang và thành {0, 0,5, 2, 3,5, 4} để mô phỏng hiệu ứng giữa thang. Các cỡ mẫu thử gồm (5, 5, 5), (25, 25, 25), (5, 5, 25) và (5, 25, 25) mỗi nhóm. Kết luận của ông là phương pháp tốt nhất phụ thuộc cả dạng méo lẫn độ lệch phân phối. Trang Likert scale nêu lai lịch thang đo này, còn bài thang đo Likert 5 mức độ bàn kỹ cách mã hoá và diễn giải.
Các nghiên cứu báo cáo các loại thang đo trong SPSS và chọn kiểm định ra sao?
Trả lời thẳng: Bốn nghiên cứu khảo sát sinh viên với cỡ mẫu từ 132 đến 402 cho thấy cách phổ biến là chia biến liên tục thành nhóm rồi dùng t-test hoặc ANOVA, và báo thêm cỡ ảnh hưởng thay vì chỉ báo ý nghĩa thống kê. Không nghiên cứu nào bàn về lý thuyết thang đo, nên đây chỉ là ví dụ về cách báo cáo.
| Nghiên cứu | Mẫu và cách phân tích | Phát hiện có số | Áp dụng cho các loại thang đo trong SPSS |
|---|---|---|---|
| Hadi và Abdel-Razzaq (2024) | 132 sinh viên kế toán ở Ả Rập Xê Út, t-test và ANOVA một chiều | Không khác biệt về thái độ giữa nam và nữ, cũng không giữa ba nhóm tuổi | Tuổi là biến Scale, nhưng khi gộp thành ba nhóm thì phép so sánh coi nó là biến nhóm |
| Stewart (2024) | 157 sinh viên kế toán ở một trường công Mỹ, MANOVA và t-test | Vài khía cạnh khác biệt với cỡ ảnh hưởng vừa, tương quan giữa các thái độ ở mức vừa và dương | Báo cỡ ảnh hưởng cùng giá trị p để người đọc biết khác biệt lớn đến đâu |
| Baloglu (2017) | 402 sinh viên ở một trường công lập Thổ Nhĩ Kỳ, điểm trung bình từng thang đo | Trung bình 4,52, 3,71, 3,61 và 3,03, và mô hình giải thích 27%, 16% và 5% phương sai của ba kết quả | Điểm tổng nhiều câu thường xử lý như Scale, nên nêu lý do trong chương phương pháp |
| Bengesai và cộng sự (2022) | 299 sinh viên năm nhất tham gia một chương trình thí điểm ở Nam Phi | Độ tin cậy các thang đo nhiều câu từ 0,66 đến 0,74, tác giả coi là chấp nhận được | Trước khi cộng điểm các câu Likert, hãy tính và báo độ tin cậy |
Cột cuối là cách đọc của người viết, không phải kết luận của tác giả. Baloglu (2017) báo điểm trung bình từng thang đo, còn Bengesai và cộng sự (2022) báo độ tin cậy trước khi tổng hợp, nên cả hai chỉ coi điểm tổng như biến Scale sau khi đã nêu lý do.
Khai báo sai mức đo trong SPSS gây hậu quả gì, và có nên đổi qua lại?
Trả lời thẳng: Khai sai Measure không tự làm sai con số SPSS tính, nhưng nó có thể khiến bạn chọn nhầm biểu đồ hoặc kiểm định ngay từ đầu. Bạn hạ Scale xuống Ordinal hoặc Nominal được vì chỉ mất bớt thông tin, còn nâng Nominal lên Scale thì không có cơ sở đo lường, nên cách an toàn là khai báo đúng ngay lúc nhập dữ liệu.
Williams (2021) giải thích rằng quy tắc "phép phân tích nào hợp lệ với thang đo nào" của Stevens xuất phát từ mối quan tâm về lý thuyết đo lường, khác với các giả định thống kê thực tế của một phép phân tích, mà hiếm khi bao gồm giả định về mức đo. Ông kết luận rằng nhà nghiên cứu nên kiểm tra tính hợp lý của các giả định thống kê hơn là tự giới hạn trong danh sách phép phân tích mà Stevens cho là hợp lệ. Vì vậy mức đo là hướng dẫn thực hành chứ không phải luật cứng, nhưng bạn vẫn phải nêu lý do khi chọn kiểm định, chẳng hạn trong bài kiểm định t-test trong SPSS hay bài kiểm định phi tham số trong SPSS.
Về chiều đổi, một biến liên tục như chiều cao có thể gộp thành ba nhóm thấp, trung bình và cao để vẽ biểu đồ cột, và việc này hợp lệ vì chỉ mất bớt thông tin. Ngược lại, biến phương tiện đi học mã hoá 1, 2, 3 không trở nên có khoảng cách chỉ vì bạn đổi nhãn sang Scale. Cách an toàn là khai báo đúng ngay lúc nhập, rồi rà một lượt toàn bộ cột Measure trước khi mở bất kỳ hộp thoại phân tích nào.
Học các loại thang đo trong SPSS qua số liệu lớp học thật
Trả lời thẳng: Trong một lớp thống kê nhập môn, sinh viên lúc đầu ít lo lắng và tự tin hơn khi đọc đầu ra của SPSS so với R, với 39 sinh viên học SPSS và 43 sinh viên học R. Hai nghiên cứu khác cho thấy khảo sát thường được lặp lại nhiều lần hoặc dùng để xếp hạng tiêu chí, và mức đo của từng câu quyết định cách xếp hạng đó.
Cả ba nghiên cứu dưới đây đến từ lớp học và trường đại học thật, vì vậy chúng cho thấy cách người học và người nghiên cứu đối mặt với các loại thang đo trong SPSS ở quy mô thực tế, từ vài chục đến vài trăm người. Cột cuối vẫn là cách đọc của người viết.
| Nghiên cứu | Mẫu và bối cảnh | Phát hiện có số | Áp dụng cho các loại thang đo trong SPSS |
|---|---|---|---|
| Rode và Ringel (2019) | Hai lớp thống kê nhập môn, 43 sinh viên học đầu ra R và 39 sinh viên học đầu ra SPSS | Lúc đầu sinh viên lo lắng hơn và kém tự tin hơn khi xem đầu ra của R so với SPSS | Đầu ra của SPSS dễ đọc ban đầu, nhưng bạn vẫn phải tự kiểm tra cột Measure |
| Kumari (2019) | 180 giảng viên ở các trường đại học tư tại Haryana, phân tích bằng SPSS | Các tiêu chí được xếp thành nhóm được ưa chuộng nhiều nhất và ít nhất | Xếp hạng mức ưa chuộng là việc của biến Ordinal, nên chưa nên tính trung bình ngay |
| Fakhreldin và cộng sự (2021) | 240 sinh viên khảo sát ba lần, nhóm thí nghiệm so với nhóm đối chứng | Môn học liên văn hoá có tác động tích cực và có ý nghĩa thống kê lên chỉ số thông minh văn hoá | Khảo sát lặp ba lần cần khai cùng một mức đo ở cả ba lần |
Câu hỏi thường gặp
SPSS có tách riêng Interval và Ratio không?
Không. Cột Measure chỉ có Nominal, Ordinal và Scale, và Scale gồm cả hai loại. Bạn tự nêu rõ biến là khoảng hay tỷ lệ trong chương phương pháp.
Ngưỡng 24 giá trị khác nhau trong SPSS dùng để làm gì?
Đó là giá trị mặc định mà IBM dùng để quyết định biến số có đủ nhiều giá trị khác nhau để xếp liên tục. Bạn có thể đổi ngưỡng trong hộp thoại Options.
Một câu hỏi Likert nên khai Ordinal hay Scale?
Phần lớn tài liệu xếp từng câu đơn lẻ vào Ordinal. Điểm tổng của nhiều câu thường được xử lý gần với Scale, nhưng bạn cần nêu lý do trong bài.
Khai Ordinal thì có buộc dùng Mann-Whitney thay cho t-test không?
Không buộc. de Winter và Dodou (2010) thấy hai kiểm định có sức mạnh tương đương ở đa số cặp phân phối, nên điều quan trọng là bạn kiểm tra phân phối và giải thích lựa chọn.
Có nên đổi biến Nominal đã nhập thành Scale không?
Không nên. Các mã số của biến Nominal không mang khoảng cách hay tỷ lệ có nghĩa, nên trung bình tính ra không diễn giải được.
SPSS có tự đoán đúng mức đo cho biến của tôi không?
Không chắc. Quy tắc tự động chỉ dựa trên định dạng và số giá trị khác nhau, nên bạn vẫn phải tự rà lại từng biến.
Cần người kèm khi khai báo biến và chọn kiểm định cho luận văn?
Nếu bạn còn phân vân biến nào nên khai Nominal, Ordinal hay Scale, hãy mang bảng hỏi và danh sách biến tới hỏi giảng viên hướng dẫn trước. Khi cần thêm một người kèm riêng phần số liệu, dịch vụ Hỗ trợ xử lý số liệu luận văn của MAAS có chuyên gia đúng chuyên ngành cùng bạn làm sạch dữ liệu và chọn kiểm định, còn phần viết và diễn giải kết quả trong luận văn vẫn do bạn tự làm. Buổi làm việc thường bắt đầu bằng việc xem lại bảng mô tả biến của bạn, đối chiếu từng mức đo với cách biến được đo ngoài thực tế, rồi cùng giải thích vì sao mỗi kiểm định được chọn. Dịch vụ này là tư vấn và kèm cặp, không gắn mục tiêu điểm, và bạn là người chạy lại phân tích, đọc bảng kết quả và trả lời hội đồng về dữ liệu của chính mình.
Related guides
- Thang đo Likert 5 mức độ: cách mã hoá và diễn giải câu Likert sau khi đã khai báo mức đo
- Độ lệch chuẩn trong SPSS: các lệnh tính độ phân tán cho biến Scale
References
Baloglu, N. (2017). The Effects of Family Leadership Orientation on Social Entrepreneurship, Generativity and Academic Success of College Students. Educational Research and Reviews, 12(1), 36–44. https://doi.org/10.5897/err2016.3074
Bengesai, A. V., Paideya, V., Naidoo, P., & Mkhonza, S. (2022). Student Perceptions on Their Transition Experiences at a South African University Offering a First-Year Experience Programme. Journal of Student Affairs in Africa, 10(2), 111–127. https://doi.org/10.24085/jsaa.v10i2.4084
de Winter, J. C. F., & Dodou, D. (2010). Five-point Likert items: t test versus Mann-Whitney-Wilcoxon. Practical Assessment, Research, and Evaluation, 15(11). https://doi.org/10.7275/bj1p-ts64
Fakhreldin, H., Youssef, N., & Anis, M. (2021). Cross-Cultural Management Education: Core for Business Students in the 21st Century. Journal of Teaching in International Business, 32(2), 109–134. https://eric.ed.gov/?id=EJ1312824
Hadi, N. U., & Abdel-Razzaq, A. I. (2024). Promoting sustainable learning among accounting students: evidence from field experimental design. Higher Education, Skills and Work-Based Learning, 14(2), 479–491. https://doi.org/10.1108/HESWBL-03-2023-0058
IBM. (n.d.-a). Variable measurement level. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=view-variable-measurement-level
IBM. (n.d.-b). Defining value labels and other variable properties. IBM SPSS Statistics 30.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/30.0.0?topic=properties-defining-value-labels-other-variable
Kumari, N. (2019). Using SPSS to Find the Factors Affecting the Quality of Education in Private Universities in Haryana. Journal of Educational Technology, 15(4), 31–39. https://doi.org/10.26634/jet.15.4.15105
Lantz, B. (2013). Equidistance of Likert-type scales and validation of inferential methods using experiments and simulations. Electronic Journal of Business Research Methods, 11(1). https://academic-publishing.org/index.php/ejbrm/article/view/1299
Rode, J. B., & Ringel, M. M. (2019). Statistical Software Output in the Classroom: A Comparison of R and SPSS. Teaching of Psychology, 46(4), 319–327. https://doi.org/10.1177/0098628319872605
Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677-680. https://doi.org/10.1126/science.103.2684.677
Stewart, V. M. (2024). Transformative sustainability education in accounting: effects on male and female students’ attitudes toward sustainable development. International Journal of Sustainability in Higher Education, 25(3), 616–630. https://doi.org/10.1108/IJSHE-06-2023-0235
Sullivan, G. M., & Artino, A. R. (2013). Analyzing and interpreting data from Likert-type scales. Journal of Graduate Medical Education, 5(4), 541-542. https://doi.org/10.4300/JGME-5-4-18
Williams, M. N. (2021). Levels of measurement and statistical analyses. Meta-Psychology, 5. https://doi.org/10.15626/mp.2019.1916
Buổi tư vấn miễn phí 20 phút là một cuộc trao đổi về việc bạn đang ở đâu với bài của mình.
Đặt lịch tư vấn miễn phí ▸