
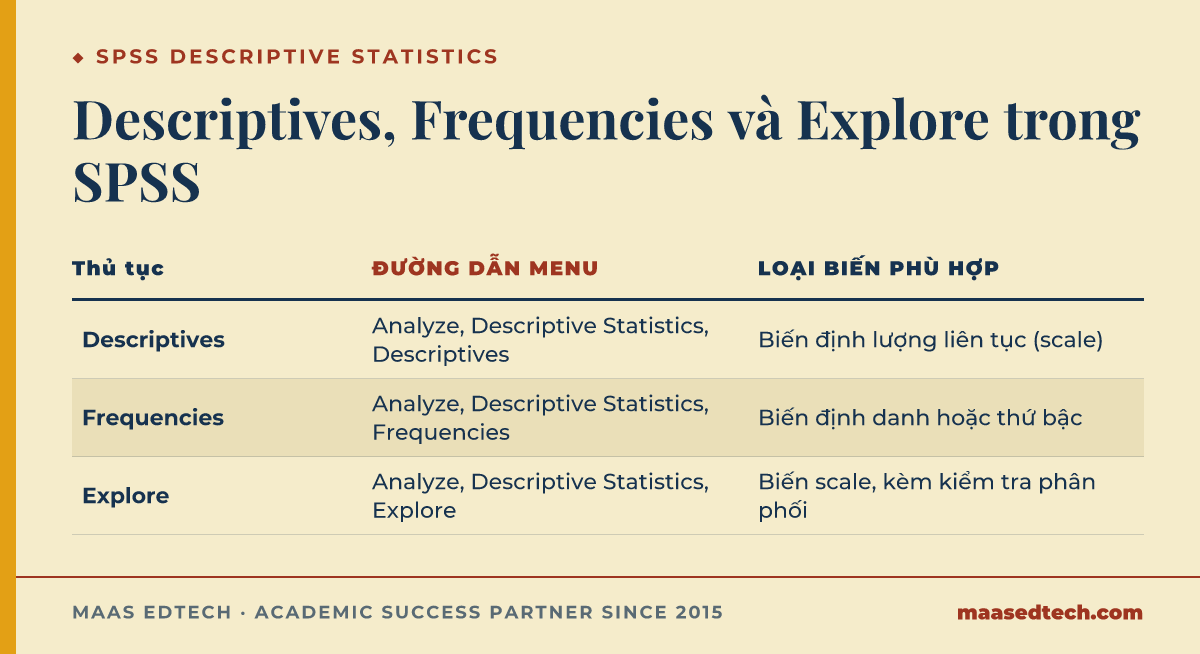
Bạn vừa nhập xong dữ liệu khảo sát vào SPSS, cần bảng số đầu tiên cho phần mô tả mẫu, nhưng chưa chắc bấm menu nào.
Cập nhật lần cuối: 2026-09-21
Chuyên mục: research-methods
Thống kê mô tả và thống kê tần số trong SPSS khác nhau ở đâu?
Trả lời thẳng: SPSS gom năm thủ tục vào cùng nhóm Descriptive Statistics, gồm Frequencies, Descriptives, Explore, Crosstabs và Ratio. Descriptives dùng cho biến định lượng liên tục để tính nhanh Mean, độ lệch chuẩn, giá trị nhỏ nhất và lớn nhất. Frequencies phù hợp nhất với biến định danh hoặc thứ bậc để đếm tần suất từng mức, và đây chính là thủ tục cho thứ mọi người gọi là "thống kê tần số".
Bằng chứng: Purdue University Statistical Consulting Service (2020) liệt kê năm thủ tục nằm chung trong menu Analyze, Descriptive Statistics, gồm Frequencies, Descriptives, Explore, Crosstabs và Ratio. Kent State University Libraries (n.d.-a) mô tả Descriptives dùng cho biến scale để tính nhanh các chỉ số tóm tắt, còn Baylor University Libraries (n.d.) viết nguyên văn rằng "Frequencies are suited to be run on Nominal and Ordinal data... and not Scale variables", tức Frequencies hợp với biến định danh và thứ bậc, không phải biến liên tục. UCLA Office of Advanced Research Computing (n.d.) xếp Crosstabs vào nhóm dùng khi cần đếm tần suất chéo giữa hai biến định danh hoặc thứ bậc, ví dụ đối chiếu hai nhóm đối tượng.
Ví dụ: Nếu đề tài của bạn khảo sát điểm hài lòng theo thang 1 đến 5 và tuổi của người trả lời, điểm hài lòng chạy Frequencies để đếm mỗi mức có bao nhiêu người chọn, còn tuổi chạy Descriptives để lấy Mean và độ lệch chuẩn. Độ lệch chuẩn trong SPSS đi sâu hơn vào cách ba thủ tục này khác nhau khi cùng xuất ra một chỉ số duy nhất.
Chạy thống kê mô tả và thống kê tần số trong SPSS theo đường dẫn menu nào?
Trả lời thẳng: Cả ba thủ tục đều nằm dưới Analyze, Descriptive Statistics trên thanh menu chính, sau đó chọn tên thủ tục tương ứng. Frequencies nằm ở đường dẫn Analyze, Descriptive Statistics, Frequencies. Descriptives nằm ở đường dẫn Analyze, Descriptive Statistics, Descriptives. Explore nằm ở đường dẫn Analyze, Descriptive Statistics, Explore. Trong hộp thoại Frequencies, nút Statistics mở bảng chọn chỉ số cụ thể, còn nút Charts cho biểu đồ.
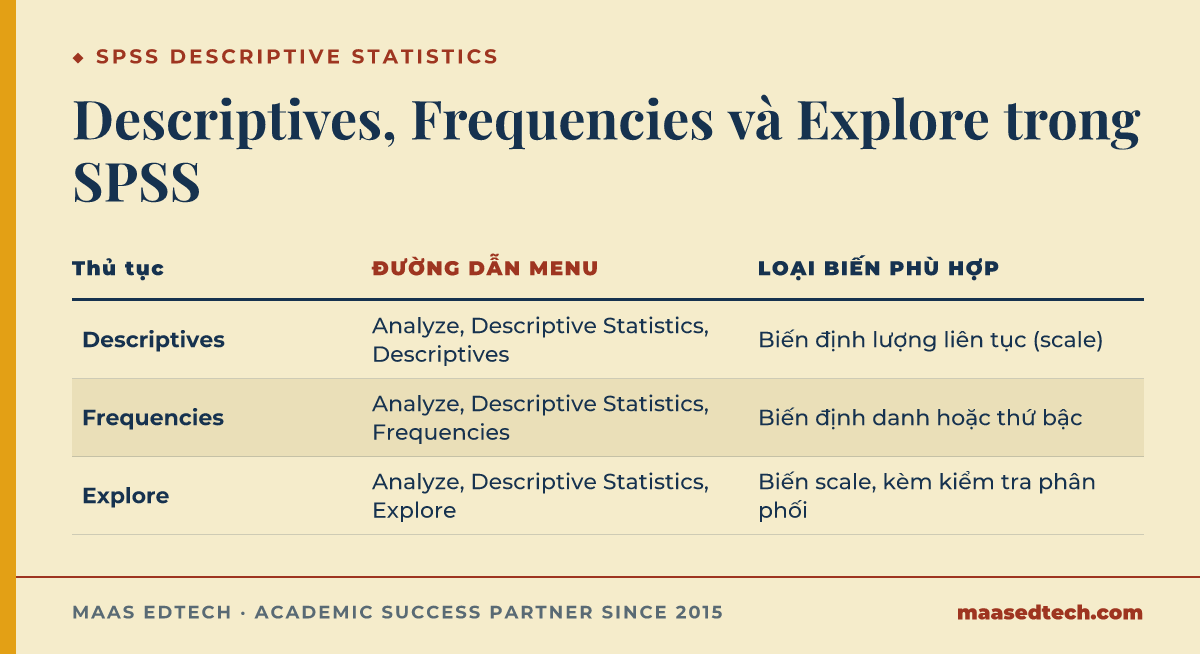
Bằng chứng: University of Wisconsin-Madison SSCC (n.d.) xác nhận bước đầu tiên để chạy Frequencies là vào Analyze, Descriptive Statistics, Frequencies. Texas Tech University Information Technology Training Services [ITTS] (n.d.) minh hoạ cụ thể việc tích chọn Quartiles, độ lệch chuẩn, giá trị nhỏ nhất, lớn nhất, Mean, Median, skewness và kurtosis ngay trong nút Statistics của hộp thoại Frequencies. Kent State University Libraries (n.d.-b) xác nhận đường dẫn riêng cho Explore là Analyze, Descriptive Statistics, Explore.
Ví dụ: Nếu bạn chỉ cần một bảng Mean và độ lệch chuẩn nhanh cho phần mô tả mẫu trong luận văn, Descriptives là lựa chọn ngắn gọn nhất, không cần mở thêm hộp thoại Statistics như khi dùng Frequencies.
Đọc bảng kết quả Frequencies trong SPSS thế nào cho đúng?
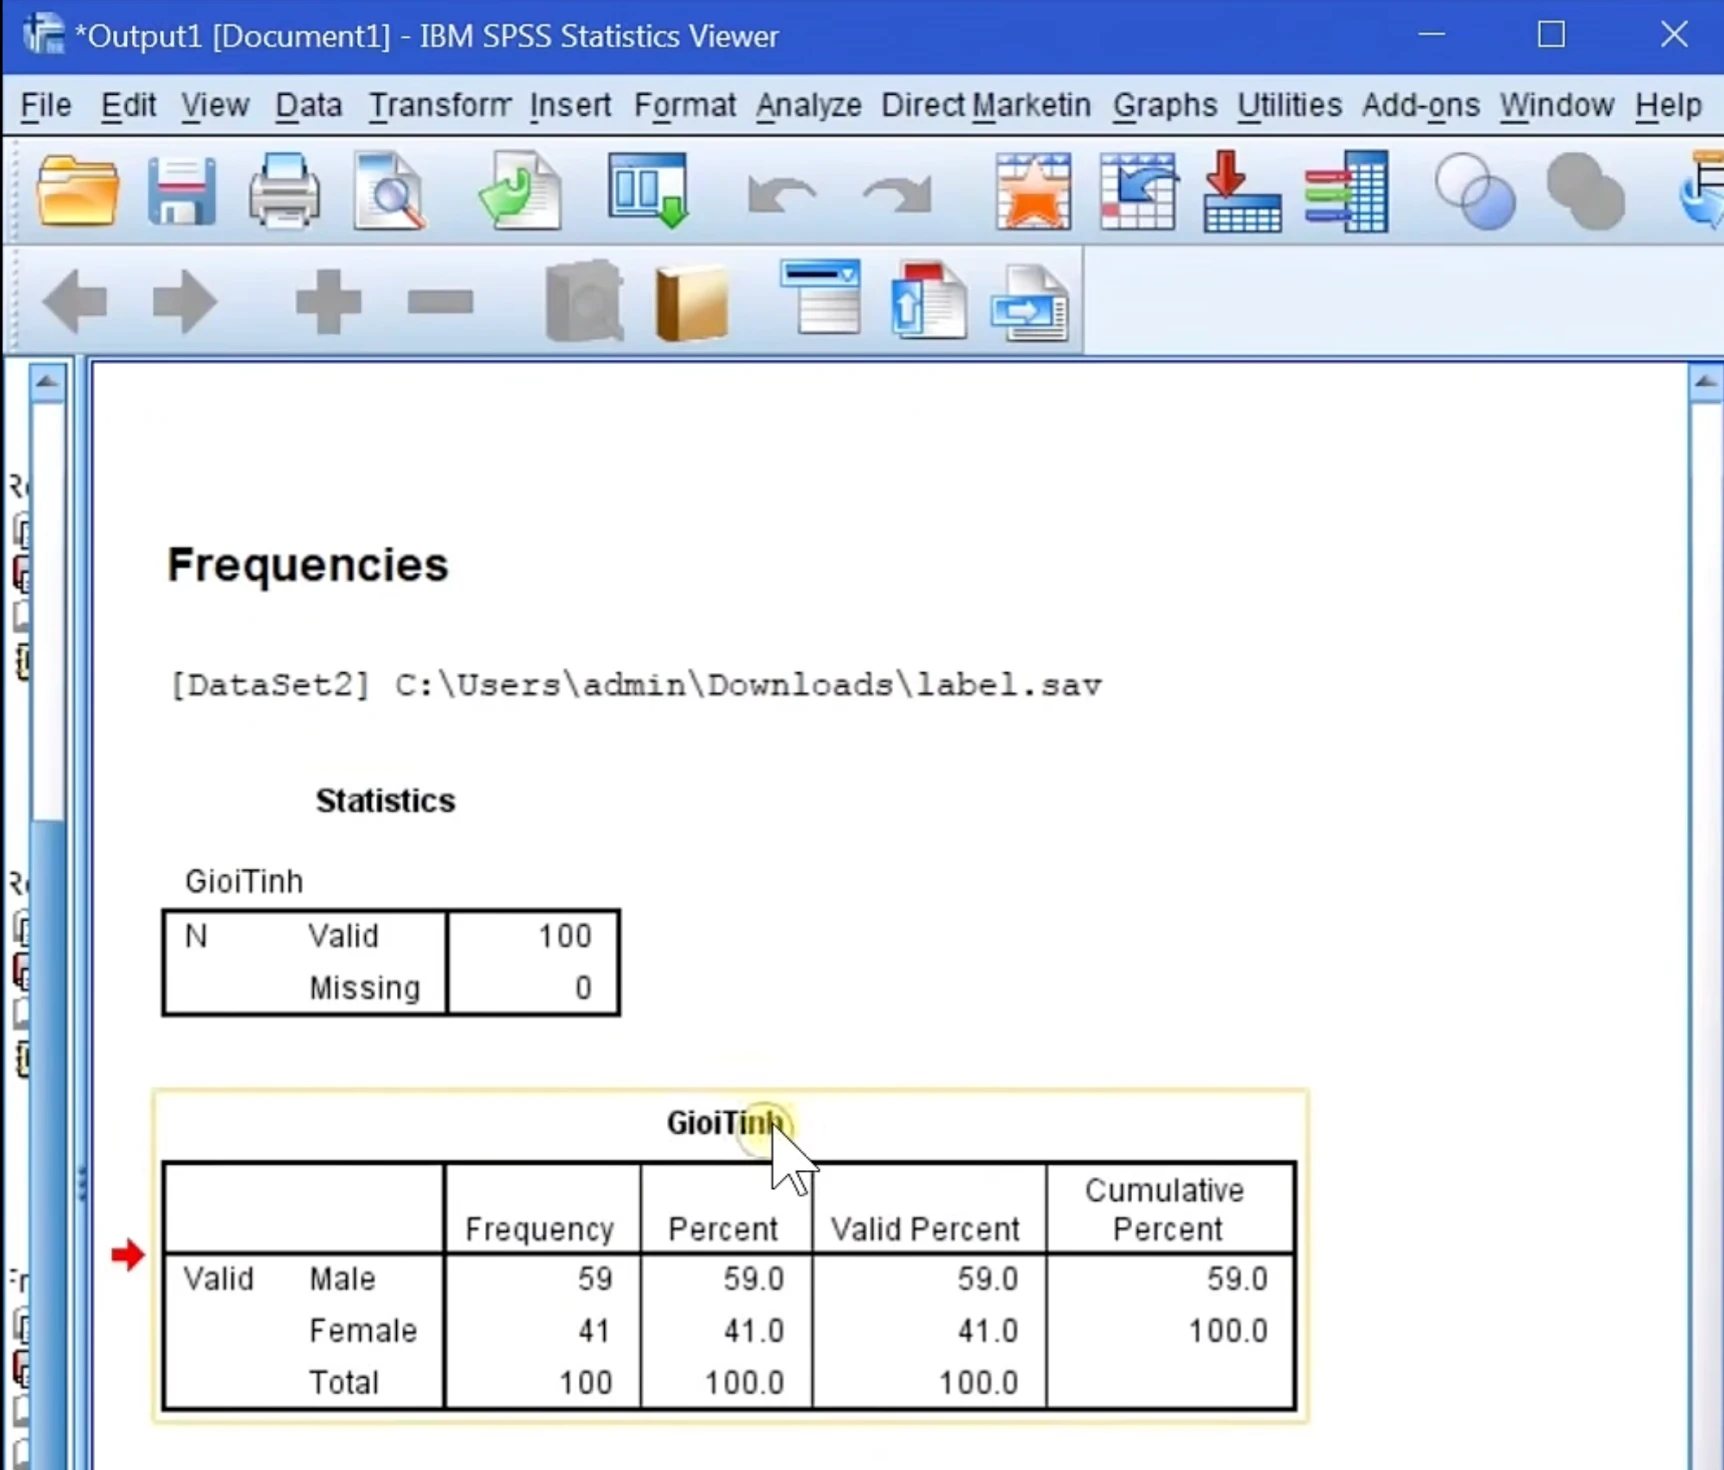
Trả lời thẳng: Bảng Frequencies gồm bốn cột. Frequency đếm số người rơi vào từng mức, kể cả dòng dữ liệu thiếu nếu có. Percent tính trên toàn bộ mẫu kể cả phần thiếu dữ liệu. Valid Percent chỉ tính trên phần dữ liệu hợp lệ, loại bỏ phần thiếu. Cumulative Percent cộng dồn Valid Percent theo thứ tự các mức.
Bằng chứng: Baylor University Libraries (n.d.) mô tả chi tiết bốn cột này trong mục hướng dẫn đọc bảng tần suất, nhấn mạnh Percent và Valid Percent chỉ khác nhau khi bộ dữ liệu có giá trị thiếu, vì Valid Percent loại bỏ phần thiếu còn Percent thì không. Cùng nguồn này cũng ghi nhận Frequencies tách một bảng riêng cho mỗi biến, trong khi Descriptives gộp tất cả biến được chọn vào một bảng duy nhất, mỗi hàng một biến.
| Cột | Ý nghĩa | Ví dụ với 100 người trả lời, 5 người bỏ trống |
|---|---|---|
| Frequency | Số người rơi vào mức đó | 40 người chọn "Hài lòng" |
| Percent | Tỉ lệ trên toàn bộ 100 người | 40,0% |
| Valid Percent | Tỉ lệ trên 95 người có trả lời | 42,1% |
| Cumulative Percent | Cộng dồn Valid Percent theo thứ tự các mức | Cộng dồn tới mức "Hài lòng" |
Nên chọn Descriptives hay Frequencies theo loại biến (thang đo) nào?
Trả lời thẳng: Lý thuyết đo lường có bốn thang đo là định danh, thứ bậc, khoảng và tỉ lệ, gộp thành categorical (định danh, thứ bậc) và scale (khoảng, tỉ lệ). SPSS đi theo cách gộp này nên cột Measure trong Variable View chỉ còn ba lựa chọn là Nominal, Ordinal và Scale. Dữ liệu categorical hợp với Frequencies để đếm, dữ liệu scale hợp với Descriptives để tính trung bình và độ lệch chuẩn.
Bằng chứng: Oxford Brookes University (n.d.) định nghĩa định danh là các nhóm không có thứ tự như giới tính hay ngành học, thứ bậc là có thứ tự nhưng khoảng cách giữa các mức không đều như xếp hạng mức độ hài lòng, khoảng là có khoảng cách đều nhưng không có điểm 0 tuyệt đối như nhiệt độ, và tỉ lệ là có điểm 0 tuyệt đối như tuổi hay thu nhập. Cùng nguồn này gộp định danh và thứ bậc thành categorical data, gộp khoảng và tỉ lệ thành scale data. Kent State University Libraries (n.d.-c), mục khai báo biến, xác nhận cột Measure trong Variable View chỉ cho chọn "the level of measurement for that variable: Scale, Ordinal, or Nominal", tức ba mức chứ không phải bốn.
Ví dụ: Ngành học của người trả lời là biến định danh nên chạy Frequencies. Điểm trung bình học kỳ là biến tỉ lệ nên chạy Descriptives. Các loại thang đo trong SPSS trình bày đầy đủ cách khai báo ba mức đo trên giao diện, tương ứng bốn thang đo lý thuyết này trong Variable View.
Chạy thống kê tần số cho biến định lượng (scale) có cần lưu ý gì không?
Trả lời thẳng: Có. Với biến scale có nhiều giá trị khác nhau, nên bỏ tick "Display frequency tables" trong hộp thoại Frequencies vì bảng sẽ quá dài mà không có ích, chỉ giữ lại các chỉ số tóm tắt qua nút Statistics. SPSS còn có một lối tắt khác gọi là one-click descriptives, tự sinh chỉ số theo đúng thang đo đã khai báo cho biến.
Bằng chứng: Texas Tech University ITTS (n.d.) khuyến nghị nguyên văn "it is a good idea to turn off the display of frequency tables for scale data because this type of data usually has many different values". Cùng nguồn này mô tả SPSS Statistics 28 mặc định tự sinh bảng tần suất cho mọi biến có từ 24 giá trị khác nhau trở xuống khi bấm chuột phải chọn "Descriptive Statistics" trong Data Editor, kèm chỉ số tự động theo thang đo: biến dạng chữ không tính chỉ số nào, biến số định danh hoặc chưa xác định thang đo cho ra khoảng biến thiên, giá trị nhỏ nhất, lớn nhất và mode, biến số thứ bậc thêm Mean và Median, còn biến số scale thêm cả độ lệch chuẩn.
Ví dụ: Nếu biến của bạn là điểm số từ 0 đến 100 với gần như mỗi người một điểm khác nhau, tick Frequencies mặc định sẽ in ra một bảng dài cả trăm dòng không đọc được, nên bước bỏ tick "Display frequency tables" là bước nên làm trước khi bấm OK.
Thống kê mô tả trong SPSS có báo được độ xiên (skewness) và độ nhọn (kurtosis) không?
Trả lời thẳng: Có, cả Frequencies (qua nút Statistics) và Explore đều xuất được skewness và kurtosis. Nhưng không có một ngưỡng "chính thức" duy nhất được giới thống kê đồng thuận để coi hai chỉ số này là bất thường, nên các con số ngưỡng lưu hành trong tài liệu phương pháp chỉ là quy ước tham khảo.
Bằng chứng: MRC Cognition and Brain Sciences Unit (n.d.) tại Cambridge dẫn lại thư của nhà thống kê Steve Simon gửi danh sách SPSSX-L, viết nguyên văn "There are no official rules about cut-off criteria to decide just how large skew or kurtosis values must be to indicate non-normality". Cùng nguồn này dẫn lại hai quy ước hay gặp, George và Mallery (2010) đề xuất khoảng -2 đến +2 cho cả skewness và kurtosis, còn Hair và cộng sự (2010) đề xuất -2 đến +2 cho skewness nhưng -7 đến +7 cho kurtosis, và ghi rõ cả hai chỉ là quy ước tham khảo phổ biến, không phải chuẩn thống nhất. Kim (2013, p. 52), một bài báo có bình duyệt trên Restorative Dentistry & Endodontics, đề xuất cách khác là chia skewness và kurtosis cho sai số chuẩn để ra Z, viết nguyên văn rằng với mẫu nhỏ dưới 50 quan sát thì Z "larger than 1.96, which corresponds with a alpha level 0.05" coi là lệch chuẩn đáng kể, còn với mẫu lớn hơn 300 nên nhìn trực tiếp giá trị và biểu đồ "without considering z-values". Cả hai nguồn đều khuyến nghị kết hợp biểu đồ hoặc kiểm định hình thức như Shapiro-Wilk thay vì chỉ dựa vào một con số.
Ví dụ: Nếu skewness của biến bạn đang xét là 1,8, đừng vội kết luận dữ liệu "không chuẩn" chỉ vì con số đó nằm gần một ngưỡng nào đó bạn đọc được trên mạng. Cách chắc hơn là nhìn thêm histogram hoặc chạy kèm một kiểm định hình thức, đúng như cách các nguồn phương pháp học khuyến nghị.
Nên làm gì tiếp theo
Khi bạn đã đọc được bảng Frequencies và Descriptives nhưng còn lúng túng ở bước chọn kiểm định tiếp theo hoặc diễn giải kết quả cho đúng với câu hỏi nghiên cứu, dịch vụ Dự án Dữ liệu & Lập trình của MAAS có chuyên gia giúp bạn chọn đúng kiểm định, chạy trên SPSS và kiểm lại cách bạn đang diễn giải, sao cho chính bạn nắm và bảo vệ được kết quả khi cần trình bày. Đặt buổi tư vấn miễn phí 15 phút qua support@maasedtech.com hoặc +84 979 422 393 (Zalo / WhatsApp).
Câu hỏi thường gặp
Cách chạy thống kê tần số trong SPSS khác cách chạy thống kê mô tả ở bước nào?
Hai thủ tục dùng chung menu Analyze, Descriptive Statistics nhưng tách nhau ở tên gọi cụ thể. Thống kê tần số chạy qua Frequencies, phù hợp với biến định danh và thứ bậc để đếm số người ở từng mức. Thống kê mô tả theo nghĩa hẹp thường chỉ Descriptives, phù hợp với biến scale để tính Mean và độ lệch chuẩn. Cả hai đều nằm trong nhóm thống kê mô tả theo nghĩa rộng, tức bước khám phá dữ liệu trước khi kiểm định giả thuyết.
SPSS có tự động chạy thống kê mô tả khi mở file dữ liệu không?
Không, bạn phải chủ động chạy qua menu Analyze. Một ngoại lệ là lối tắt one-click descriptives trong SPSS Statistics 28, bấm chuột phải chọn "Descriptive Statistics" ngay trong Data Editor để SPSS tự sinh vài chỉ số cơ bản theo đúng thang đo đã khai báo cho biến, nhưng đây vẫn là một thao tác chủ động, không tự chạy khi mở file.
Percent và Valid Percent trong bảng Frequencies khác nhau thế nào?
Mẫu số của hai cột này không giống nhau. Percent lấy toàn bộ số người tham gia làm mẫu số, kể cả người bỏ trống câu hỏi. Valid Percent chỉ đếm những người trả lời thật, coi người bỏ trống là không tồn tại trong phép tính. Vì vậy hai con số trùng khít khi khảo sát không ai bỏ trống, và tách xa nhau dần khi tỉ lệ bỏ trống càng cao.
Có bắt buộc phải chạy Explore để có skewness và kurtosis không?
Không bắt buộc. Nút Statistics trong hộp thoại Frequencies cũng xuất được skewness và kurtosis, không cần mở riêng thủ tục Explore. Explore chỉ khác ở chỗ xuất một bộ chỉ số cố định nhiều hơn, gồm cả trung vị và khoảng tứ phân vị, mà bạn không chọn lọc được từng chỉ số riêng như trong Descriptives hay Frequencies.
Descriptives, Frequencies và Explore khác nhau ở điểm nào khi cùng xuất một chỉ số?
Descriptives cho phép chọn lọc đúng chỉ số cần xem và gộp nhiều biến vào một bảng. Frequencies xuất riêng một bảng cho mỗi biến, kèm cột tần suất mà Descriptives không có. Explore xuất một bộ chỉ số cố định, không chọn lọc được, phù hợp khi cần kiểm tra phân phối kỹ trước khi chọn kiểm định tham số. Độ lệch chuẩn trong SPSS so sánh chi tiết hơn ba thủ tục này khi cùng cần lấy một chỉ số duy nhất.
Bảng Descriptives có xuất được tần suất từng mức của biến không?
Không trực tiếp. Descriptives được thiết kế để tính các chỉ số tóm tắt như Mean, độ lệch chuẩn, giá trị nhỏ nhất và lớn nhất cho biến scale, không tách theo từng mức giá trị. Muốn xem tần suất từng mức, kể cả với biến scale, phải chạy qua Frequencies rồi cân nhắc bỏ tick "Display frequency tables" nếu biến có quá nhiều giá trị khác nhau.
References
Baylor University Libraries. (n.d.). SPSS statistical software: Descriptive statistics. https://libguides.baylor.edu/c.php?g=1351162&p=9972302
George, D., & Mallery, P. (2010). SPSS for Windows step by step: A simple guide and reference, 17.0 update (10th ed.). Pearson. (Trích lại từ MRC Cognition and Brain Sciences Unit, n.d.)
Hair, J. F., Black, W. C., Babin, B. J., & Anderson, R. E. (2010). Multivariate data analysis (7th ed.). Pearson. (Trích lại từ MRC Cognition and Brain Sciences Unit, n.d.)
Kent State University Libraries. (n.d.-a). SPSS tutorials: Descriptives. https://libguides.library.kent.edu/SPSS/Descriptives
Kent State University Libraries. (n.d.-b). SPSS tutorials: Explore. https://libguides.library.kent.edu/SPSS/Explore
Kent State University Libraries. (n.d.-c). SPSS tutorials: Defining variables. https://libguides.library.kent.edu/SPSS/DefineVariables
Kim, H.-Y. (2013). Statistical notes for clinical researchers: Assessing normal distribution (2) using skewness and kurtosis. Restorative Dentistry & Endodontics, 38(1), 52-54. https://doi.org/10.5395/rde.2013.38.1.52
MRC Cognition and Brain Sciences Unit. (n.d.). FAQ/Simon: Testing normality including skewness and kurtosis. https://imaging.mrc-cbu.cam.ac.uk/statswiki/FAQ/Simon
Oxford Brookes University. (n.d.). Types of data. https://www.brookes.ac.uk/students/academic-development/maths-and-stats/statistics/types-of-data
Purdue University Statistical Consulting Service. (2020). SPSS tutorial. https://www.stat.purdue.edu/scs/docs/SPSS_tutorial.pdf
Texas Tech University Information Technology Training Services. (n.d.). SPSS – 1. https://www.depts.ttu.edu/itts/apps/handouts/SPSS-1.pdf
University of Wisconsin-Madison Social Science Computing Cooperative. (n.d.). SPSS for the classroom: Statistics and graphs. https://ssc.wisc.edu/sscc/pubs/spss/classintro/spss_students2.html