
Thống kê suy diễn trong SPSS dùng dữ liệu mẫu để ước lượng hoặc kiểm định giả thuyết về tổng thể, khác thống kê mô tả vốn chỉ tóm tắt mẫu đang có.
Cập nhật lần cuối: 2026-09-23
Chuyên mục: research-methods
Thống kê suy diễn trong SPSS là gì?
Trả lời thẳng: Thống kê suy diễn là nhóm phân tích dùng dữ liệu của một mẫu để rút ra kết luận về tổng thể mà mẫu đó đại diện, thông qua ước lượng tham số hoặc kiểm định giả thuyết. Khác với thống kê mô tả chỉ tóm tắt những gì đang có trong tay, thống kê suy diễn đi xa hơn để trả lời câu hỏi nghiên cứu về một nhóm rộng hơn mẫu khảo sát.
Bằng chứng: Statistics LibreTexts, Fort Hays State University (2020) định nghĩa một thống kê (statistic) là con số tính từ mẫu, dùng để ước lượng một tham số (parameter) của tổng thể, độ chính xác của ước lượng phụ thuộc vào mẫu có đại diện hay không, và chính nguồn này cho biết thống kê suy diễn xây dựng xung quanh giả định lấy mẫu ngẫu nhiên để có cơ sở tin rằng mẫu phản ánh đúng tổng thể. Social Sci LibreTexts, Monterey Peninsula College (2025) phân biệt hai nhánh theo một trục khác, thống kê mô tả không nhằm suy rộng ra ngoài dữ liệu đang có trong khi thống kê suy diễn suy rộng từ mẫu ra tổng thể. Kent State University Libraries (n.d.) đã chia SPSS thành hai nhóm thủ tục chính là thống kê mô tả để khám phá dữ liệu và thống kê suy diễn để kiểm định giả thuyết, và trong nhóm suy diễn lại chia tiếp thành các nhóm nhỏ hơn theo mục đích phân tích.
Ví dụ: Bạn khảo sát 300 sinh viên tại một trường về mức độ hài lòng với hình thức học online, rồi muốn nói điều đó đúng cho toàn bộ 10.000 sinh viên của trường, đó chính là lúc bạn cần thống kê suy diễn thay vì chỉ dừng ở thống kê mô tả. Trước khi chạy bất kỳ kiểm định suy diễn nào, bước Frequencies và Descriptives để xem đặc điểm chung của mẫu vẫn là bước bắt buộc, xem cách chạy thống kê mô tả trong SPSS nếu bạn chưa quen bước này.
SPSS chia thống kê suy diễn thành những nhóm kiểm định nào?
Trả lời thẳng: Hướng dẫn SPSS của Kent State University Libraries chia thống kê suy diễn thành ba nhóm chính theo mục đích phân tích, gồm kiểm định mối liên hệ giữa hai biến (định tính hoặc định lượng), so sánh trung bình giữa các nhóm, và mô hình dự đoán qua hồi quy. SPSS-tutorials.com mô tả chi tiết hơn với sáu nhóm nhỏ, chia theo số biến và kiểu so sánh cần thực hiện.
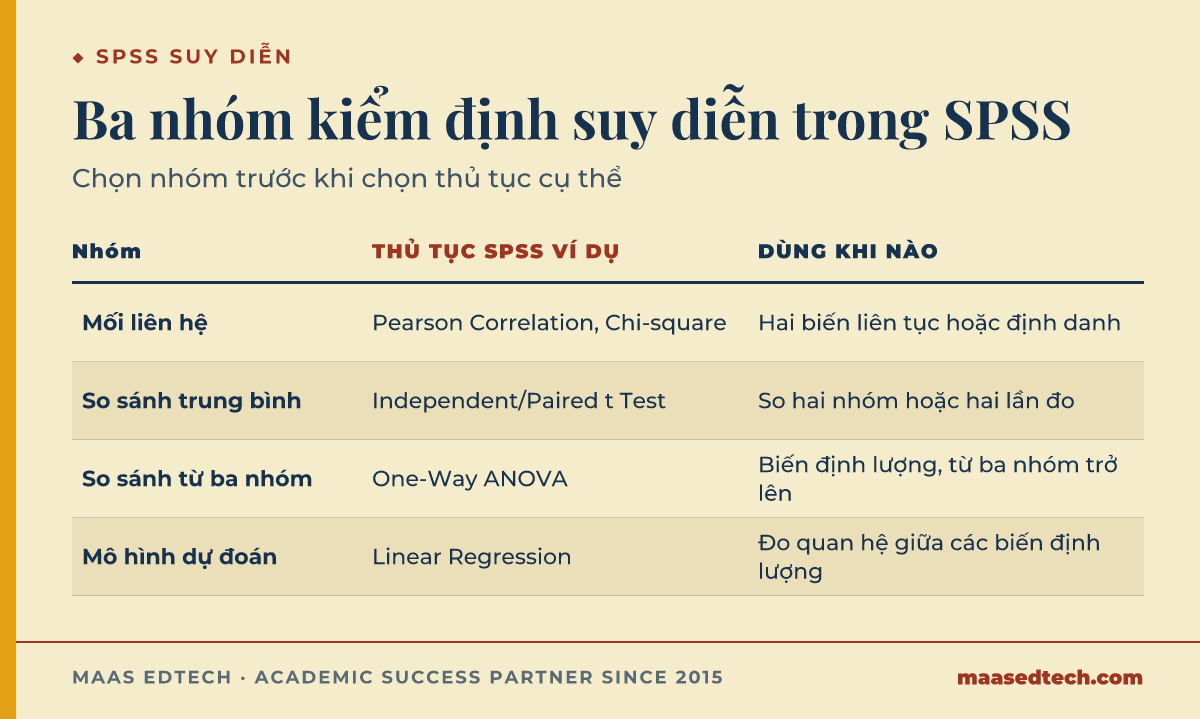
Bằng chứng: Kent State University Libraries (n.d.) tách phần kiểm định giả thuyết trong SPSS thành ba nhóm là mối liên hệ, so sánh trung bình và mô hình dự đoán, đồng thời liệt kê các thủ tục cụ thể cho từng nhóm. Nhóm kiểm định mối liên hệ giữa hai biến gồm Pearson Correlation cho hai biến liên tục và Chi-square Test of Independence cho hai biến định danh. Nhóm so sánh trung bình gồm One Sample t Test, Paired-Samples t Test, Independent Samples t Test và One-Way ANOVA. SPSS-tutorials (n.d.) phân loại chi tiết hơn thành sáu nhóm là univariate, within-subjects, between-subjects, đo lường liên hệ, phân tích dự đoán và phân loại, đồng thời đưa ví dụ cụ thể rằng independent-samples t-test kiểm định giả thuyết trung bình hai tổng thể bằng nhau bằng thống kê t, còn one-way ANOVA kiểm định giả thuyết trung bình từ ba nhóm trở lên bằng nhau. UCLA Office of Advanced Research Computing (n.d.) cung cấp một bảng tra riêng, đối chiếu số biến độc lập và phụ thuộc cùng loại biến để chọn đúng kiểm định trong số t-test, ANOVA, hồi quy và tương quan.
| Nhóm kiểm định suy diễn | Thủ tục SPSS ví dụ | Dùng khi nào |
|---|---|---|
| Kiểm định mối liên hệ | Pearson Correlation, Chi-square Test of Independence | Hai biến liên tục hoặc hai biến định danh cần xem có liên hệ hay không |
| So sánh trung bình | One Sample t Test, Paired-Samples t Test, Independent Samples t Test | So một nhóm với giá trị giả định, so hai lần đo trên cùng đối tượng, hoặc so hai nhóm độc lập |
| So sánh trung bình từ ba nhóm | One-Way ANOVA | Biến phụ thuộc định lượng, so sánh từ ba nhóm độc lập trở lên |
| Mô hình dự đoán | Linear Regression | Ước lượng mối quan hệ và khả năng dự đoán giữa các biến định lượng |
UCLA Office of Advanced Research Computing (n.d.) cũng nhấn mạnh cách chọn kiểm định phụ thuộc vào loại biến, cụ thể là định danh, thứ bậc hay khoảng-tỉ lệ, và vào việc dữ liệu có đạt phân phối chuẩn hay không. Đây nên là căn cứ chọn kiểm định, không phải thói quen hay kiểm định quen thuộc nhất. Toàn bộ nhóm kiểm định giả thuyết ở trên thuộc thống kê suy diễn.
p-value và mức ý nghĩa trong thống kê suy diễn nghĩa là gì?
Trả lời thẳng: p-value cho biết khả năng thấy được một kết quả bằng hoặc cực đoan hơn kết quả đã quan sát nếu giả thuyết H0 là thật, chứ không đo xác suất H0 đúng hay sai. Mức ý nghĩa, thường ký hiệu alpha ở mức 0,05, là ngưỡng so sánh với p-value để quyết định bác bỏ hay không bác bỏ H0. Khoảng tin cậy là cách khác để trình bày kết quả suy diễn.
Bằng chứng: Wasserstein và Lazar (2016), đại diện cho American Statistical Association, định nghĩa trong bản tuyên bố về p-value rằng p-value là xác suất tính trong giả định mô hình thống kê, kể cả giả thuyết H0, đúng, để có được một kết quả cực đoan bằng hoặc hơn giá trị đã quan sát. Cùng nguồn này nêu ở nguyên tắc thứ ba, nguyên văn "Scientific conclusions and business or policy decisions should not be based only on whether a p-value passes a specific threshold" (Wasserstein & Lazar, 2016, p. 131), rằng quyết định khoa học không nên chỉ dựa vào việc p-value có vượt một ngưỡng cố định hay không. Greenland và cộng sự (2016) ghi nhận rằng nhiều tạp chí hiện yêu cầu báo cáo khoảng tin cậy song song với kết quả kiểm định giả thuyết, vì khoảng tin cậy cho thấy một khoảng giá trị hợp lý thay vì chỉ một quyết định có hay không.
Ví dụ: Nếu bảng kết quả SPSS của bạn cho Sig. bằng 0,03 trong khi mức ý nghĩa đặt trước là 0,05, kết luận đúng là bác bỏ H0 ở mức ý nghĩa đó, chứ không phải khẳng định giả thuyết nghiên cứu chắc chắn đúng 97%. Cách đọc cột Sig. này và các ngộ nhận thường gặp khi viết p-value vào phần kết quả được trình bày sâu hơn ở bài Sig. trong SPSS là gì.
Sinh viên hay hiểu sai điều gì khi đọc p-value trong SPSS?
Trả lời thẳng: Hai lỗi đứng đầu danh sách 25 lỗi diễn giải của Greenland và cộng sự (2016) là coi p-value như xác suất giả thuyết H0 đúng, và coi p-value như xác suất kết quả quan sát được là do ngẫu nhiên tạo ra. Cả hai đều sai vì p-value được tính trong giả định H0 đã đúng từ đầu, không phải xác suất ngược lại của chính H0 hay của ngẫu nhiên.
Bằng chứng: Greenland và cộng sự (2016), đăng trên European Journal of Epidemiology, liệt kê lỗi diễn giải đứng đầu danh sách 25 lỗi là coi p bằng 0,01 nghĩa là giả thuyết H0 chỉ còn 1% khả năng đúng, trong khi thực tế p-value được tính trong giả định H0 đã đúng nên không thể quay lại đo xác suất của chính H0. Cùng nguồn này mô tả lỗi thứ hai là một biến thể của lỗi thứ nhất, coi p-value là xác suất kết quả quan sát được do ngẫu nhiên tạo ra, một cách hiểu cũng sai vì p-value được tính ra từ giả định ngẫu nhiên chứ không phải là xác suất của chính giả định đó. Wasserstein và Lazar (2016) bổ sung ở nguyên tắc thứ năm rằng p-value hay ý nghĩa thống kê không đo độ lớn hay tầm quan trọng thực tế của một kết quả, và với mẫu đủ lớn, một hiệu ứng dù rất nhỏ vẫn có thể cho p-value nhỏ.
Ví dụ: Một khoá luận báo cáo p bằng 0,001 cho chênh lệch điểm trung bình chỉ 0,2 trên thang 10, chạy trên mẫu vài nghìn sinh viên, cần nói rõ chênh lệch này có ý nghĩa thống kê nhưng gần như không đáng kể trên thực tế, thay vì chỉ dừng ở việc p-value rất nhỏ. Trước khi tin bất kỳ kết quả suy diễn nào, kiểm tra giả định của phép kiểm định như tính chuẩn và tính đồng nhất phương sai vẫn là bước không thể bỏ qua, và bài SPSS là gì trình bày tổng quan cả năm nhóm phân tích SPSS thường gặp, gồm cả bước kiểm tra giả định này.
Làm sao chọn đúng kiểm định suy diễn cho câu hỏi nghiên cứu?
Trả lời thẳng: Chọn đúng kiểm định suy diễn phụ thuộc vào ba yếu tố chính, gồm loại biến đang có, số nhóm cần so sánh và dữ liệu có đạt phân phối chuẩn hay không. Việc này nên làm trước khi mở SPSS ra chạy, không phải chạy thử rồi mới quyết định kiểm định nào cho ra kết quả đẹp.
Bằng chứng: UCLA Office of Advanced Research Computing (n.d.) cung cấp bảng tra kiểm định theo số biến độc lập, số biến phụ thuộc và loại biến, giúp người dùng khoanh vùng kiểm định phù hợp trước khi chạy thay vì thử từng kiểm định một. Kent State University Libraries (n.d.) phân biệt rõ Independent-Samples T-Test áp dụng cho đúng hai nhóm độc lập, còn One-Way ANOVA áp dụng khi cần so sánh từ hai nhóm trở lên, và là lựa chọn duy nhất trong hai khi có từ ba nhóm.
Ví dụ: So sánh chi tiêu trung bình của sinh viên ở ba khu vực sinh sống khác nhau cần One-Way ANOVA vì đối tượng so sánh không dừng ở hai nhóm, còn so sánh điểm giữa hai lớp học riêng biệt thì Independent Samples t Test là kiểm định phù hợp. Khi dữ liệu không đạt giả định phân phối chuẩn, nhóm kiểm định phi tham số là lựa chọn thay thế cho các kiểm định suy diễn ở trên, xem kiểm định phi tham số trong SPSS để biết khi nào cần chuyển hướng này. Với đề tài đo mối quan hệ giữa các biến liên tục thuộc nhóm mô hình dự đoán, bài phân tích hồi quy tuyến tính trong SPSS thực hiện thế nào trình bày cách chạy và đọc bảng hệ số hồi quy chi tiết hơn.
Câu hỏi thường gặp
Thống kê suy diễn khác thống kê mô tả ở điểm nào?
Thống kê mô tả chỉ tóm tắt dữ liệu đã thu thập được, còn thống kê suy diễn dùng dữ liệu mẫu đó để rút ra kết luận về một tổng thể rộng hơn, thông qua ước lượng tham số hoặc kiểm định giả thuyết.
p-value nhỏ có nghĩa là kết quả nghiên cứu quan trọng không?
Không hẳn. p-value nhỏ chỉ cho biết kết quả khó xảy ra nếu H0 đúng, không đo độ lớn hay tầm quan trọng thực tế của hiệu ứng, và với mẫu đủ lớn, một chênh lệch rất nhỏ vẫn có thể cho p-value nhỏ.
Khi nào nên báo cáo khoảng tin cậy thay vì chỉ p-value?
Nhiều tạp chí hiện yêu cầu báo cáo cả hai, vì khoảng tin cậy cho thấy một khoảng giá trị hợp lý của tham số đang ước lượng, trong khi p-value chỉ trả lời có bác bỏ H0 ở một mức ý nghĩa cụ thể hay không.
Mức ý nghĩa 0,05 có phải là quy tắc bắt buộc trong mọi nghiên cứu không?
Không. Wasserstein và Lazar (2016), trong tuyên bố của American Statistical Association, cho rằng kết luận khoa học không nên chỉ dựa vào việc p-value có vượt một ngưỡng cố định như 0,05 hay không, nên 0,05 là một quy ước phổ biến chứ không phải quy tắc bắt buộc.
Thống kê suy diễn có bắt buộc phải lấy mẫu ngẫu nhiên không?
Không hoàn toàn. Phương pháp suy diễn dựa trên giả định lấy mẫu ngẫu nhiên hoặc phân bổ ngẫu nhiên (Greenland và cộng sự, 2016), nên với một khoá luận dùng mẫu thuận tiện, kiểm định vẫn chạy và cho ra kết quả, nhưng phần suy rộng kết quả ra tổng thể cần được nêu rõ là một giới hạn của nghiên cứu, không phải khẳng định chắc chắn.
MAAS hỗ trợ gì cho sinh viên đang chọn kiểm định suy diễn trong SPSS?
MAAS cử chuyên gia hướng dẫn bạn chọn đúng kiểm định suy diễn cho dữ liệu và câu hỏi nghiên cứu đang có, chạy cùng bạn trên chính dữ liệu đó, và soát lại cách bạn đọc kết quả, để bạn hiểu và tự bảo vệ được phân tích của mình. Buổi tư vấn mở đầu không thu phí và kéo dài 15 phút. Xem thêm tại dịch vụ hướng dẫn chạy SPSS và Python, hoặc đặt lịch tại đây.
References
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337-350. https://doi.org/10.1007/s10654-016-0149-3
- Kent State University Libraries. (n.d.). SPSS tutorials. Retrieved September 23, 2026, from https://libguides.library.kent.edu/SPSS/home
- Social Sci LibreTexts, Monterey Peninsula College. (2025). 6.8: Descriptive versus inferential statistics. Retrieved September 23, 2026, from https://socialsci.libretexts.org/Courses/Monterey_Peninsula_College/Intro_to_Stats_in_the_Social_Sciences_(MPC)/06%3A_Inferential_Statistics_and_an_Introduction_to_Hypothesis_Testing/6.08%3A_Descriptive_versus_Inferential_Statistics
- SPSS-tutorials.com. (n.d.). Which statistical test should I use? Retrieved September 23, 2026, from https://www.spss-tutorials.com/which-statistical-test-should-i-use/
- Statistics LibreTexts, Fort Hays State University. (2020). 1.3: Two realms of statistics: Descriptive and inferential. Retrieved September 23, 2026, from https://stats.libretexts.org/Courses/Fort_Hays_State_University/Elements_of_Statistics/01%3A_Introduction_to_Statistics/1.03%3A_Two_Realms_of_Statistics-_Descriptive_and_Inferential
- UCLA Office of Advanced Research Computing. (n.d.). What statistical analysis should I use? Statistical analyses using SPSS. Retrieved September 23, 2026, from https://stats.oarc.ucla.edu/spss/whatstat/what-statistical-analysis-should-i-usestatistical-analyses-using-spss/
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129-133. https://doi.org/10.1080/00031305.2016.1154108