
Tính cỡ mẫu cho một nghiên cứu là xác định trước khi thu dữ liệu xem bạn cần bao nhiêu người tham gia để phát hiện được một hiệu ứng có thật. Bạn cố định mức power mong muốn, mức ý nghĩa và effect size dự kiến, rồi con số cần thiết sẽ được phần mềm tính ra. Bài viết này hướng dẫn bạn chọn ba đầu vào đó, chạy phép tính trong G*Power, điều chỉnh cho phần hao hụt và báo cáo kết quả theo cách người bình duyệt chấp nhận.
Tính sai thì cái giá phải trả rất đắt. Quá ít người tham gia thì một hiệu ứng có thật vẫn nằm ngoài tầm phát hiện và nhiều tháng làm việc thành công cốc, còn quá nhiều thì nguồn lực bị tiêu tốn không cần thiết và việc tuyển dư làm nảy sinh câu hỏi đạo đức. Với nhà nghiên cứu Việt Nam nhắm tới tạp chí Scopus Q1 hoặc Q2, một lập luận rõ ràng cho cỡ mẫu là thứ người bình duyệt phương pháp kiểm tra sớm nhất. Bài viết đi qua bảy câu hỏi mà nhà nghiên cứu Việt Nam hỏi cố vấn công bố của MAAS nhiều nhất khi bước vào giai đoạn thiết kế nghiên cứu.
Tác giả: Ban Biên tập MAAS
Cập nhật lần cuối: 2026-06-10
Chuyên mục: research-methods
Cỡ mẫu là gì và vì sao nó quyết định bài báo của bạn có được đăng?
Trả lời trực tiếp: Cỡ mẫu là số quan sát bạn thu được, như bệnh nhân, sinh viên hay người trả lời khảo sát. Statistical power, tức khả năng phát hiện một hiệu ứng có thật, phụ thuộc vào cỡ mẫu, nên nghiên cứu thiếu power có thể bỏ sót hiệu ứng đó. Người bình duyệt xem lập luận cỡ mẫu là dấu hiệu của thiết kế nghiêm túc, nên phép tính này thuộc về đề cương chứ không thuộc phần thảo luận.
Bằng chứng: Hickey và cộng sự (2018), viết từ trang 4 tới trang 9 trên European Journal of Cardio-Thoracic Surgery, mô tả phép tính cỡ mẫu là một phần cốt lõi của thiết kế thử nghiệm và cảnh báo rằng các nghiên cứu nhỏ "may possess insufficient power to detect a clinically significant difference, if such a difference exists", tức có thể không đủ power để phát hiện một khác biệt có ý nghĩa lâm sàng nếu khác biệt đó tồn tại. Serdar và cộng sự (2021) bổ sung rằng nghiên cứu thiếu cỡ mẫu có nguy cơ mắc sai lầm loại II (Type II error, bỏ sót một hiệu ứng có thật), còn nghiên cứu lớn quá mức cần thiết thì lãng phí nguồn lực và làm nảy sinh vấn đề đạo đức. Cả hai đều là lỗi thiết kế mà người bình duyệt nhìn ra được.
Ví dụ: Một khách của dịch vụ Cố vấn Công bố MAAS dự định làm một nghiên cứu bán thực nghiệm hai nhóm với 24 người mỗi nhánh, vì đó là số người chị ấy tuyển được. Một buổi rà soát thiết kế 20 phút cho thấy hiệu ứng chị ấy nhắm tới cần khoảng 64 người mỗi nhánh để đạt power 80%. Chị ấy thiết kế lại khoảng thời gian tuyển người trước khi thu một điểm dữ liệu nào, rẻ hơn nhiều so với phát hiện vấn đề lúc bình duyệt.
Bạn cần ba con số nào trước khi tính được cỡ mẫu?
Trả lời trực tiếp: Một phép tính a priori, tức tính trước khi có dữ liệu, cần ba đầu vào, và phần mềm giải ra đại lượng thứ tư là cỡ mẫu. Bạn đặt mức ý nghĩa alpha, thường là 0,05, tương đương 5% khả năng cho kết quả dương tính giả, đặt statistical power, thường là 0,80, và đặt effect size dự kiến. Cố định ba giá trị đó thì N cần thiết được xác định.
Bằng chứng: Kang (2021) nêu đúng bốn đại lượng liên kết với nhau: "the sample size calculation and power analysis are determined by the following factors: effect size, power (1-β), significance level (α), and type of statistical analysis" (Kang, 2021). Cố định ba đại lượng thì đại lượng còn lại được xác định, với 0,05 và 0,80 là hai giá trị quy ước trong nghiên cứu ngành sức khoẻ. Mức alpha 0,05 nghĩa là, khi thật ra không có hiệu ứng nào, nhà nghiên cứu chấp nhận 5% khả năng vẫn kết luận nhầm là có. Bài "power primer" của Cohen (1992), dài 5 trang trên Psychological Bulletin từ trang 155 tới 159, là nguồn gốc của quy ước power 0,80 được dùng rộng rãi, dựa trên lập luận chấp nhận tỷ lệ sai lầm loại II gấp bốn lần tỷ lệ sai lầm loại I.
Ví dụ: Một tác giả Việt Nam lần đầu công bố nói với cố vấn MAAS rằng anh ấy "chỉ muốn một mẫu đủ lớn". Cố vấn đặt lại vấn đề thành ba quyết định, gồm muốn chắc tới mức nào rằng mình không báo động nhầm (alpha), chắc tới mức nào rằng mình sẽ bắt được một hiệu ứng có thật (power), và hiệu ứng lớn tới đâu thì đáng bắt. Khi anh ấy đặt ba giá trị ở 0,05, 0,80 và một hiệu ứng trung bình, N cần thiết hiện ra trong hai phút.
Chọn effect size thế nào khi bạn chưa có dữ liệu thử nghiệm?
Trả lời trực tiếp: Effect size là đầu vào khó ước lượng nhất và cũng làm N thay đổi nhiều nhất, vì hiệu ứng cần phát hiện càng nhỏ thì càng cần nhiều người tham gia. Hãy ước lượng theo thứ tự ưu tiên, trước hết từ một nghiên cứu đã công bố tương tự, sau đó từ một pilot nhỏ, và chỉ khi không còn cách nào khác mới dùng mốc quy ước của Cohen. Luôn viết ra lý do bạn chọn.
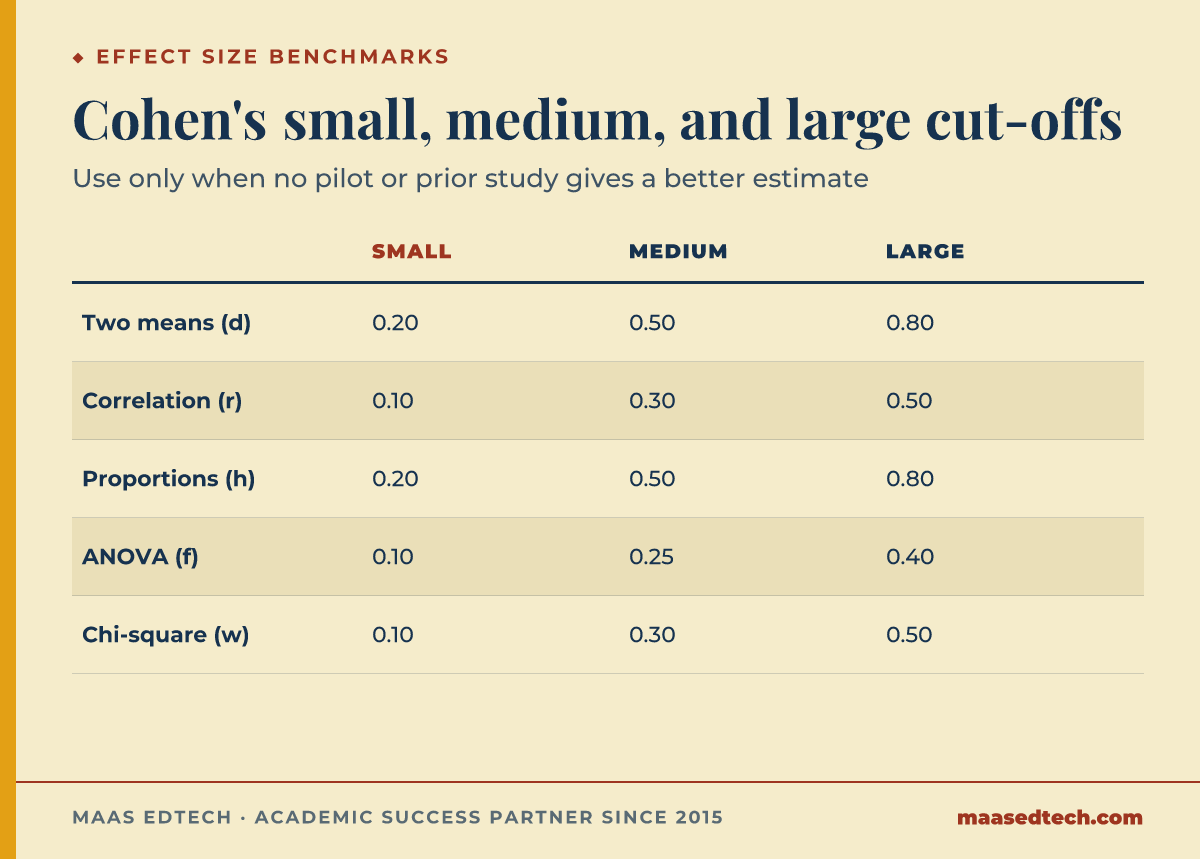
Bằng chứng: Serdar và cộng sự (2021) khuyên rút hiệu ứng dự kiến từ tài liệu đã có hoặc từ một pilot bất cứ khi nào có thể, và chỉ dùng mốc chuẩn hoá khi không có ước lượng nào tốt hơn. Cohen (1992) đưa ra các ngưỡng quy ước mà nhà nghiên cứu quay về khi không còn lựa chọn, tóm tắt trong bảng dưới đây.
| Phép kiểm định | Thước đo effect size | Nhỏ | Trung bình | Lớn |
|---|---|---|---|---|
| So sánh hai trung bình | d của Cohen | 0,20 | 0,50 | 0,80 |
| Tương quan | r | 0,10 | 0,30 | 0,50 |
| Chênh lệch tỷ lệ | h | 0,20 | 0,50 | 0,80 |
| ANOVA (khác biệt giữa nhóm) | f | 0,10 | 0,25 | 0,40 |
| Chi-square / liên hệ | w | 0,10 | 0,30 | 0,50 |
Ví dụ: Một sinh viên ngành khoa học sức khoẻ do MAAS đồng hành không có pilot và cũng không tìm được nghiên cứu nào thật sát đề tài. Nếu mặc định chọn hiệu ứng "lớn" cho dễ thở, bạn ấy chỉ cần một mẫu tí hon khoảng 26 người mỗi nhóm, và nghiên cứu sẽ thiếu power nếu hiệu ứng thật nhỏ hơn thế. Thay vào đó, cố vấn hướng dẫn bạn ấy tìm được hai bài báo tương đương báo cáo d của Cohen quanh 0,45. Tính power cho hiệu ứng sát thực tế đó đưa mục tiêu của sinh viên đó lên 158 người tham gia, một con số đủ vững trước người bình duyệt.
Chạy phép tính trong G*Power ra sao?
Trả lời trực tiếp: G*Power là phần mềm miễn phí, được chấp nhận rộng rãi và xử lý được phần lớn thiết kế thông dụng. Bạn chọn phép kiểm định khớp với phân tích dự kiến, đặt test family, nhập alpha, power và effect size, rồi bấm Calculate để nhận N cần thiết. Lỗi hay gặp nhất là chọn một phép kiểm định không khớp với phân tích bạn thật sự sẽ chạy.
Bằng chứng: Kang (2021) và Faul cùng cộng sự (2007), với bài viết về phần mềm này trên Behavior Research Methods chạy từ trang 175 tới 191, đều nhấn mạnh rằng phép kiểm định chọn trong G*Power phải phản chiếu đúng phân tích đã lên kế hoạch, dù là t-test, ANOVA, hồi quy hay chi-square, vì mỗi phép kiểm định có hàm power và thước đo effect size riêng. Chọn nhầm test family sẽ cho ra một con số sai mà phần mềm không báo lỗi gì.
Ví dụ: Một học viên thạc sĩ người Việt chạy power analysis theo dạng independent-samples t-test, trong khi lại định phân tích dữ liệu bằng repeated-measures ANOVA. Cố vấn MAAS phát hiện chỗ lệch này trong một buổi rà soát, và khi bạn ấy chọn lại đúng test family trong G*Power, cỡ mẫu cần thiết thay đổi gần 30%. Bạn ấy sửa trước khi tuyển người, thay vì phải giải thích trong thư phản hồi bình duyệt.
Điều chỉnh con số cho tỷ lệ bỏ cuộc và không phản hồi thế nào?
Trả lời trực tiếp: N mà G*Power trả về là số người bạn cần phân tích, không phải số người cần tuyển. Hãy cộng thêm phần hao hụt dự kiến bằng cách chia mục tiêu cho (1 trừ tỷ lệ bỏ cuộc). Nếu cần 100 người hoàn thành và dự kiến 20% bỏ cuộc, bạn tuyển 100 ÷ 0,80 = 125 người. Nghiên cứu khảo sát làm tương tự với tỷ lệ không phản hồi dự kiến.
Bằng chứng: Hickey và cộng sự (2018) lưu ý rằng nghiên cứu thực tế luôn mất người tham gia vì rút lui, mất liên lạc khi theo dõi và dữ liệu khuyết, nên mẫu tuyển vào phải lớn hơn mẫu phân tích đã tính. Serdar và cộng sự (2021) cũng khuyên đưa phần dự phòng hao hụt vào ngay mục tiêu tuyển người, thay vì phát hiện thiếu hụt khi nghiên cứu đã chạy được nửa đường. Trong ví dụ 100 người hoàn thành và 20% bỏ cuộc, con số tuyển là 125, vì phần hao hụt tính trên số người tuyển vào chứ không tính trên số người hoàn thành.
Ví dụ: Một khách của dịch vụ Cố vấn Công bố MAAS chạy một can thiệp kéo dài 12 tuần và tính ra cần 88 người hoàn thành để đạt power 80%. Dữ liệu từ một nhóm người Việt do đồng nghiệp chia sẻ gợi ý khoảng 15% bỏ cuộc trong khoảng thời gian đó, nên chị ấy tuyển 104 người. Số người rút lui nhiều hơn dự kiến hai người, nhưng chị ấy vẫn đạt mục tiêu phân tích, và việc báo cáo rõ bước cộng thêm này được một người bình duyệt tạp chí Q2 đánh giá tốt.
Tạp chí trông đợi bạn báo cáo những gì về cỡ mẫu?
Trả lời trực tiếp: Hãy báo cáo đủ để người đọc tái lập được phép tính, gồm biến kết cục chính và mức chênh lệch bạn coi là có ý nghĩa, mức alpha, power mục tiêu, effect size giả định kèm nguồn của nó, phép kiểm định đã dùng, và N cuối cùng đã tính cả phần dự phòng hao hụt. Ghi đủ những thông tin này trong phần Methods giờ là mức tối thiểu, không còn là điểm cộng.
Bằng chứng: Tuyên bố CONSORT 2010 (Schulz và cộng sự, 2010) yêu cầu các thử nghiệm ngẫu nhiên báo cáo cỡ mẫu được xác định ra sao. Tuy vậy, Kang (2021) và Serdar cùng cộng sự (2021) đều dẫn các tổng quan cho thấy chỉ khoảng một phần ba số phép tính cỡ mẫu trên các tạp chí có chỉ số ảnh hưởng cao được mô tả đủ chi tiết để tái lập, nên làm tốt phần này là một tín hiệu chất lượng thật sự.
Ví dụ: Một cố vấn MAAS gợi ý cho một tác giả Việt Nam khung câu sau: "Một mẫu N là cần thiết để phát hiện hiệu ứng [độ lớn, nguồn] với power [mức power] ở mức alpha hai phía 0,05. Tính thêm [%] hao hụt, chúng tôi đặt mục tiêu tuyển [số người]." Tác giả điền các chỗ trống bằng số liệu của chính mình, đưa câu đó vào phần Methods, và nhờ vậy trả lời trước một câu hỏi mà người bình duyệt gần như chắc chắn sẽ đặt ra.
Nếu nghiên cứu của bạn nhỏ, hoặc bạn đã thu xong dữ liệu thì sao?
Trả lời trực tiếp: Nếu không đạt được N lý tưởng, đừng tạo ra một con số "post-hoc power" để bào chữa, vì người bình duyệt nhận ra ngay. Hãy thiết kế trung thực trong giới hạn của mình, bằng cách đăng ký trước một pilot, báo cáo khoảng tin cậy thay vì chạy theo mức ý nghĩa, và nói thẳng giới hạn ra. Một nghiên cứu nhỏ minh bạch dễ được đăng hơn nhiều so với một nghiên cứu nói quá.
Bằng chứng: Hickey và cộng sự (2018) cảnh báo rõ về phép tính post-hoc power, vốn mang tính luẩn quẩn một khi dữ liệu đã có. Cohen (1992) và Serdar cùng cộng sự (2021) hướng nhà nghiên cứu tới việc báo cáo effect size kèm khoảng tin cậy, thứ vẫn giữ giá trị thông tin ngay cả khi mẫu khiêm tốn. Đây cũng là con đường mà nhiều nhà nghiên cứu Việt Nam giai đoạn đầu sự nghiệp đi vào kỷ yếu hội thảo và tạp chí Q2.
Ví dụ: Một sinh viên đại học do MAAS đồng hành chỉ tuyển được 40 người tham gia. Thay vì tô vẽ cho đẹp, cố vấn gợi ý đặt lại bài báo thành một pilot có nhãn rõ ràng, và sinh viên đó tự viết lại bài để báo cáo effect size kèm khoảng tin cậy, nêu cỡ mẫu như một giới hạn và đề xuất một nghiên cứu tiếp nối có đủ power. Bài được nhận đăng dưới dạng nghiên cứu pilot, đáng tin chính vì nó không nói quá.
Câu hỏi thường gặp
Tôi nên nhắm power bao nhiêu?
Quy ước là 0,80, nghĩa là 80% khả năng phát hiện được một hiệu ứng có thật. Một số nghiên cứu khẳng định hoặc có tính rủi ro cao dùng mức 0,90. Power cao hơn đòi mẫu lớn hơn, nên đây là một đánh đổi bạn phải cân với tính khả thi của nghiên cứu.
Cứ 30 người tham gia là đủ phải không?
Không. Quy tắc "30 là đủ" không có cơ sở, vì con số cần thiết phụ thuộc hoàn toàn vào effect size, power và phép kiểm định. Một hiệu ứng dự kiến nhỏ có thể cần tới hàng trăm người, và không có con số nào áp dụng được cho mọi nghiên cứu.
Tôi tính cỡ mẫu sau khi thu dữ liệu được không?
Về kỹ thuật thì vẫn chạy được, nhưng post-hoc power bị phê phán rộng rãi vì tính luẩn quẩn của nó. Hãy lên kế hoạch cỡ mẫu trước khi thu dữ liệu, còn sau đó thì báo cáo effect size và khoảng tin cậy.
Tôi dùng phần mềm miễn phí nào được?
G*Power là công cụ miễn phí được dùng rộng rãi nhất, phủ được t-test, ANOVA, hồi quy, tương quan và chi-square. Nhiều tạp chí chấp nhận kết quả từ phần mềm này, và bạn nên ghi rõ phiên bản đã dùng trong phần Methods.
Nghiên cứu định tính có cần tính cỡ mẫu không?
Không theo nghĩa power analysis, vì phép tính đó chỉ áp dụng cho kiểm định giả thuyết định lượng. Nghiên cứu định tính biện minh cho cỡ mẫu bằng việc đạt tới điểm bão hoà dữ liệu, một lô gích khác nhưng chính đáng ngang bằng.
MAAS có giúp tôi lập luận cho cỡ mẫu không?
Có. Dịch vụ Cố vấn Công bố của MAAS đồng hành cùng nhà nghiên cứu Việt Nam qua thiết kế nghiên cứu, chọn phép kiểm định, đặt power và effect size, chạy thử phép tính và góp ý cho phần lập luận cỡ mẫu, theo mô hình từng giai đoạn, trong đó bạn là người đưa ra quyết định và tự viết bài. Đặt lịch tư vấn qua trang liên hệ.
Sẵn sàng thiết kế một nghiên cứu mà người bình duyệt tin được?
Một phép tính cỡ mẫu làm xong trước khi tuyển người là khoản bảo hiểm rẻ nhất trong nghiên cứu, vì nó biến câu "chúng tôi dùng những ai tìm được" đầy sơ hở thành một lựa chọn phương pháp có thể bảo vệ. Với một cố vấn từng bình duyệt cho tạp chí Scopus, quyết định này chỉ tốn một cuộc trao đổi ngắn thay vì một vòng chỉnh sửa nhọc nhằn.
Cố vấn Công bố của MAAS dành riêng một giai đoạn phương pháp cho khâu thiết kế nghiên cứu, nơi những câu hỏi như cỡ mẫu được chốt, và lộ trình mở đầu bằng buổi kick-off miễn phí, không tính vào số buổi trả phí. Cố vấn của bạn có nhiều bài Q1 hoặc Q2 đứng tên chính mình, và 23% chuyên gia của MAAS có học vị Tiến sĩ. MAAS ghép cố vấn trong vòng 48 giờ khi mạng lưới đã có người phù hợp, còn nếu chưa có thì MAAS mở một đợt tuyển riêng cho hồ sơ của bạn, thường mất khoảng hai tuần. Bạn có thể bắt đầu bằng buổi tư vấn miễn phí 15 phút.
Đặt lịch tư vấn Cố vấn Công bố cùng MAAS →
Tài nguyên liên quan
- Chọn phép kiểm định thống kê phù hợp cho bài báo Q1 thế nào?: chọn phép kiểm định trước rồi mới tính power
- Chạy một phân tích tổng hợp khi lần đầu làm nghiên cứu thế nào?: gộp bằng chứng khi một mẫu là quá nhỏ
- Dịch vụ Cố vấn Công bố: các gói hỗ trợ đầy đủ cho công bố Scopus Q1 và Q2
- Dịch vụ phân tích dữ liệu SPSS, R và Python: hỗ trợ power analysis và thống kê trên SPSS, R và Python
- Gặp đội ngũ chuyên gia MAAS: những cố vấn trình độ Tiến sĩ đứng sau mảng cố vấn công bố
Tài liệu tham khảo
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146
- Hickey, G. L., Grant, S. W., Dunning, J., & Siepe, M. (2018). Statistical primer: Sample size and power calculations—why, when and how? European Journal of Cardio-Thoracic Surgery, 54(1), 4–9. https://doi.org/10.1093/ejcts/ezy169
- Kang, H. (2021). Sample size determination and power analysis using the G*Power software. Journal of Educational Evaluation for Health Professions, 18, 17. https://doi.org/10.3352/jeehp.2021.18.17
- Schulz, K. F., Altman, D. G., & Moher, D. (2010). CONSORT 2010 statement: Updated guidelines for reporting parallel group randomised trials. BMJ, 340, c332. https://doi.org/10.1136/bmj.c332
- Serdar, C. C., Cihan, M., Yücel, D., & Serdar, M. A. (2021). Sample size, power and effect size revisited: Simplified and practical approaches in pre-clinical, clinical and laboratory studies. Biochemia Medica, 31(1), Article 010502. https://doi.org/10.11613/BM.2021.010502
Công cụ và tài nguyên
- G*Power (Heinrich Heine University Düsseldorf): phần mềm miễn phí tính power a priori và cỡ mẫu
- Hub tài nguyên Scopus Publishing: mẫu đề cương và mẫu báo cáo cho nhà nghiên cứu Việt Nam
Bài viết này thuộc chuỗi MAAS Journal dành cho du học sinh sau đại học và nhà nghiên cứu người Việt. Cố vấn Công bố của MAAS là một đối tác cố vấn, đồng hành cùng tác giả theo mô hình từng giai đoạn với phản hồi phát triển từ các cố vấn trình độ Tiến sĩ đã công bố trên Scopus. MAAS không viết, không nộp và không cam kết bài được nhận đăng thay cho tác giả.