
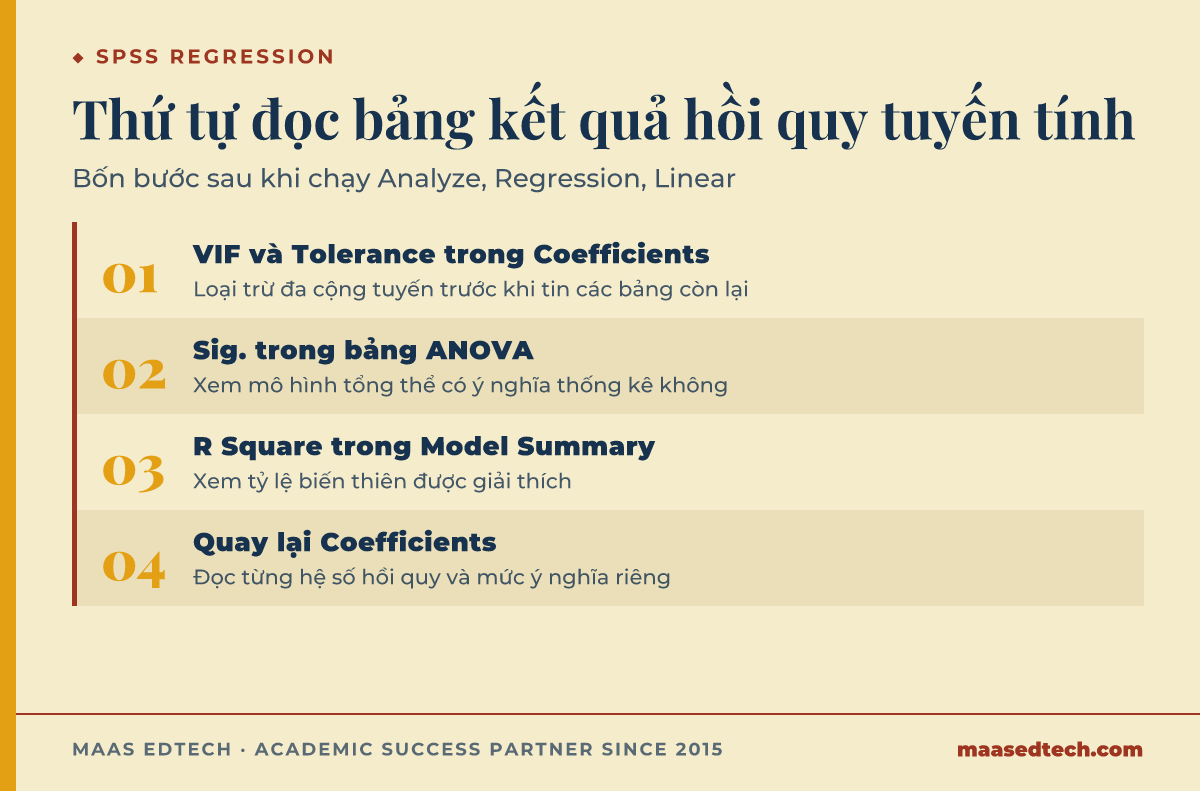
Bài này trình bày hồi quy tuyến tính trong SPSS, từ kiểm tra giả định, các bước chạy lệnh, tới cách đọc bảng Model Summary, ANOVA và Coefficients.
Cập nhật lần cuối: 2026-09-17
Chuyên mục: research-methods
Hồi quy tuyến tính trong SPSS là gì và khi nào dùng?
Trả lời thẳng: Hồi quy tuyến tính là kiểm định dùng để dự đoán một biến phụ thuộc (dependent hoặc outcome variable) từ một hoặc nhiều biến độc lập (independent hoặc predictor variable). Khi chỉ có một biến độc lập, đây là hồi quy đơn biến. Khi có từ hai biến độc lập trở lên, kiểm định này gọi là hồi quy tuyến tính bội, và trong SPSS cả hai loại đều chạy qua cùng một hộp thoại Linear Regression.
Bằng chứng: Laerd Statistics (n.d.-a) mô tả hồi quy tuyến tính đơn biến dùng để xem một biến độc lập dự đoán được bao nhiêu phần biến thiên của một biến phụ thuộc liên tục. Laerd Statistics (n.d.-b) mở rộng khái niệm này sang hồi quy bội, trong đó từ hai biến độc lập trở lên cùng được đưa vào một mô hình để dự đoán biến phụ thuộc.
Ví dụ: Nếu đề tài của bạn chỉ hỏi điểm số cuối kỳ có liên quan tới số giờ tự học hay không, đó là hồi quy đơn biến. Nếu đề tài hỏi điểm số cuối kỳ chịu tác động của số giờ tự học, mức độ hài lòng với giảng viên và tần suất đi học, đó là hồi quy bội với ba biến độc lập. Trước khi chọn giữa hai dạng này, bạn cũng cần xác định rõ đây là dữ liệu tự thu thập hay lấy lại từ nguồn đã công bố, điều bài dữ liệu sơ cấp và thứ cấp khác nhau ở điểm nào phân biệt rõ.
Trước khi chạy hồi quy tuyến tính cần kiểm tra những giả định nào?
Trả lời thẳng: Hồi quy tuyến tính đơn biến có bảy giả định cần kiểm trước khi tin kết quả. Bốn điều kiện đáng chú ý nhất là mức đo của biến phụ thuộc, hình dạng liên hệ giữa hai biến trên biểu đồ phân tán, sự vắng mặt của điểm số bất thường, và độ ổn định của phần dư dọc đường hồi quy. Hồi quy bội thêm một điều kiện riêng về mức tương quan giữa các biến độc lập.
Bằng chứng: Laerd Statistics (n.d.-a) liệt kê bảy giả định của hồi quy đơn biến, trong đó Giả định #1 yêu cầu biến phụ thuộc đo ở mức khoảng hoặc tỷ lệ (interval hoặc ratio), Giả định #3 yêu cầu quan hệ tuyến tính giữa hai biến, kiểm bằng biểu đồ phân tán (scatterplot), Giả định #4 yêu cầu không có ngoại lệ đáng kể, tức điểm có phần dư (residual) lớn và nằm xa đường hồi quy, và Giả định #6 yêu cầu phương sai đồng nhất (homoscedasticity), tức phương sai phần dư ổn định dọc theo đường hồi quy, trong khi vi phạm giả định này gọi là heteroscedasticity. Laerd Statistics (n.d.-b) bổ sung Giả định #6 riêng của hồi quy bội là không có đa cộng tuyến (multicollinearity) giữa các biến độc lập.
Ví dụ: Nếu biểu đồ phân tán giữa biến độc lập và biến phụ thuộc cho thấy các điểm nằm rải rác theo hình cong thay vì theo một đường thẳng, quan hệ đó không tuyến tính và chạy hồi quy tuyến tính trong trường hợp này sẽ cho kết quả sai lệch. Việc kiểm tra giả định nên làm trước khi mở bảng kết quả, không phải sau khi đã có con số Sig. để giải thích cho vừa ý.
Các bước chạy hồi quy tuyến tính trong SPSS là gì?
Trả lời thẳng: Trong SPSS, hồi quy tuyến tính chạy qua đường dẫn Analyze, sau đó Regression, rồi Linear. Biến phụ thuộc kéo vào ô Dependent, các biến độc lập kéo vào ô Independent(s). Với hồi quy bội cần kiểm tra đa cộng tuyến, bấm nút Statistics rồi tick vào ô Collinearity diagnostics trước khi bấm Continue và OK.
Bằng chứng: Quy trình SPSS để chạy hồi quy tuyến tính là Analyze, Regression, Linear, sau đó kéo biến phụ thuộc vào ô Dependent, các biến độc lập vào ô Independent(s), rồi bấm nút Statistics và tick "Collinearity diagnostics" để SPSS xuất thêm cột Tolerance và VIF trong bảng Coefficients (Statistics.arabpsychology.com, n.d.).
Ví dụ: Nếu bạn chạy hồi quy đơn biến, ô Independent(s) chỉ có đúng một biến và bạn không cần tick Collinearity diagnostics vì không có biến nào khác để so sánh mức tương quan. Nếu bạn thêm biến độc lập thứ hai vào cùng ô Independent(s), đây là lúc mô hình chuyển sang hồi quy bội và bước tick Collinearity diagnostics trở nên cần thiết.
Bảng Model Summary, ANOVA và Coefficients trong SPSS đọc như thế nào?
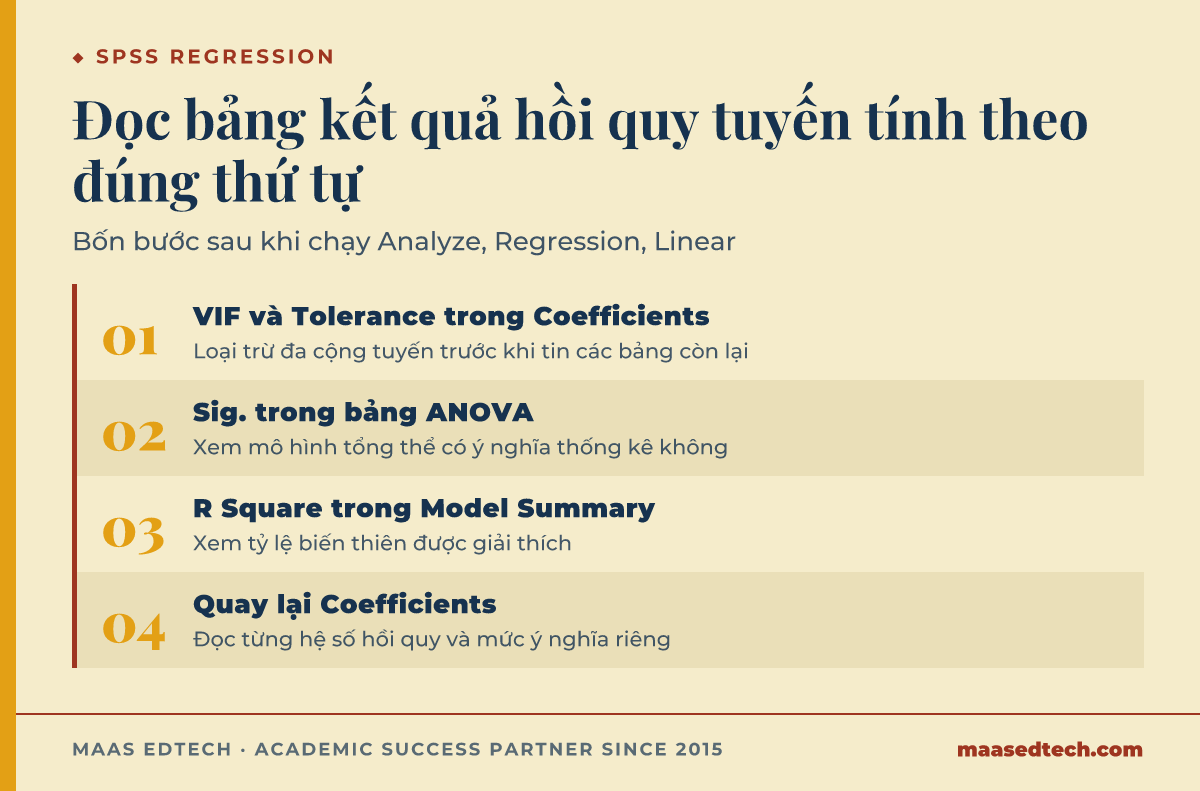
Trả lời thẳng: SPSS xuất ba bảng chính sau khi chạy hồi quy tuyến tính, nên đọc theo đúng thứ tự thay vì đọc theo vị trí xuất hiện. Với hồi quy bội, thứ tự khuyến nghị là xem VIF và Tolerance trong Coefficients trước để loại trừ đa cộng tuyến, tiếp theo xem Sig. trong ANOVA để biết mô hình có ý nghĩa tổng thể, sau đó xem R² trong Model Summary, rồi quay lại Coefficients để đọc từng hệ số.
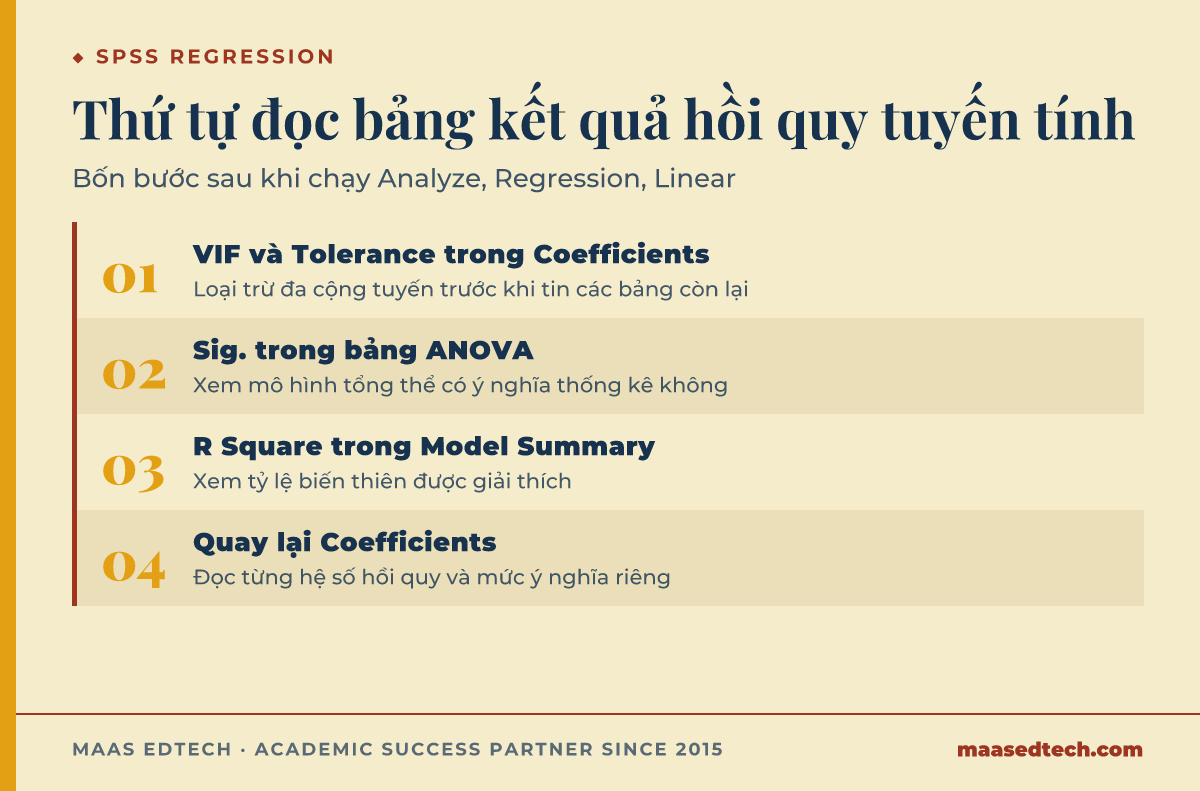
Bằng chứng: Laerd Statistics (n.d.-b) giải thích trong bảng Model Summary, cột R là hệ số tương quan bội (multiple correlation coefficient), đo chất lượng dự đoán của mô hình, còn cột R Square (R², hệ số xác định) là tỷ lệ phương sai của biến phụ thuộc được các biến độc lập giải thích, kèm ví dụ minh hoạ R² bằng 0,577, mà nguồn này diễn giải là "our independent variables explain 57.7% of the variability of our dependent variable" (Laerd Statistics, n.d.-b). Cùng nguồn này lưu ý cần báo cáo Adjusted R² thay vì chỉ dùng R² thô, vì R² thô có xu hướng tăng khi thêm biến vào mô hình dù biến đó không thực sự đóng góp. Social Sci LibreTexts (2025) trình bày thứ tự đọc bốn bước nêu trên, dựa trên một ví dụ số liệu thật với bảng Coefficients đầy đủ, và khuyến nghị xem VIF trước tiên.
Ví dụ: Nếu Sig. trong bảng ANOVA nhỏ hơn 0,05, mô hình tổng thể có ý nghĩa thống kê, nghĩa là ít nhất một biến độc lập trong mô hình có liên hệ với biến phụ thuộc. Điều này không có nghĩa mọi biến độc lập đều có ý nghĩa riêng lẻ, vì mức ý nghĩa của từng biến nằm ở cột Sig. trong bảng Coefficients, không phải bảng ANOVA. Với đề tài kiểm định mối quan hệ giữa các biến định lượng, phân tích tương quan Pearson là bước thường chạy trước hồi quy để có cái nhìn sơ bộ về chiều và độ mạnh của từng cặp biến.
Đa cộng tuyến trong hồi quy tuyến tính SPSS là gì và VIF bao nhiêu là chấp nhận được?
Trả lời thẳng: Đa cộng tuyến là tình trạng từ hai biến độc lập có quan hệ mật thiết, khiến khó tách bạch phần đóng góp riêng của mỗi biến. SPSS đo mức nghiêm trọng bằng chỉ số VIF. VIF bằng 1 là biến tách biệt hoàn toàn, khoảng 1 tới 5 vẫn trong vùng đa số nhà nghiên cứu chấp nhận, còn vượt 5 cần xem xét kỹ, dù một số ngành chỉ coi trên 10 mới đáng lo.
Bằng chứng: Công thức VIF bằng 1 chia cho (1 trừ R² của biến i), trong đó R² của biến i là hệ số xác định khi hồi quy biến độc lập thứ i theo các biến độc lập còn lại trong mô hình, và VIF từ 1 đến 5 là mức chấp nhận được với đa số nhà nghiên cứu, còn VIF trên 5 chỉ ra vấn đề đa cộng tuyến nghiêm trọng làm sai số chuẩn của hệ số bị phóng đại (Statistics.arabpsychology.com, n.d.). Tolerance là giá trị nghịch đảo của VIF, trong đó Tolerance gần 1 nghĩa là biến độc lập với các biến khác, còn Tolerance gần 0 là dấu hiệu cần chú ý (Wlm.userweb.mwn.de, n.d.). VIF đo mức phóng đại của PHƯƠNG SAI hệ số hồi quy, nên sai số chuẩn (căn bậc hai của phương sai) bị phóng đại theo căn bậc hai của VIF, không phóng đại theo đúng giá trị VIF: VIF bằng 3 nghĩa là sai số chuẩn thực tế lớn hơn khoảng 1,7 lần so với khi biến hoàn toàn độc lập. Khi bật Collinearity Diagnostics, SPSS còn xuất một bảng riêng gồm Eigenvalue và Condition Index, trong đó nhiều Eigenvalue gần 0 và Condition Index trên 15 là dấu hiệu đa cộng tuyến, còn Condition Index trên 30 là dấu hiệu rất mạnh (Regorz-statistik.de, n.d.). Cùng nguồn này trình bày quy trình đọc thực hành: nếu VIF của mọi biến đều dưới 10 thì coi như ổn, chỉ khi có trên hai biến VIF vượt 10 mới cần soi thêm bảng Collinearity Diagnostics để tìm dòng có Condition Index trên 15 và từ hai giá trị Variance Proportion trở lên vượt 0,90 nhằm xác định cặp biến gây ra vấn đề.
| Chỉ số | Ngưỡng ổn | Ngưỡng cần chú ý | Ngưỡng nghiêm trọng |
|---|---|---|---|
| Tolerance | Trên 0,20 | Từ 0,10 đến 0,20 | Dưới 0,10 |
| VIF | Dưới 3 đến 5 | Từ 3-5 đến 5-10 | Trên 5 đến 10, tuỳ trường phái |
| R² | Định tính: R² cao hơn nghĩa là mô hình giải thích được nhiều biến thiên hơn, mức đủ tuỳ ngành và tuỳ thiết kế nghiên cứu |
Ví dụ: Ngưỡng VIF trong bảng trên viết theo khoảng vì các nguồn không thống nhất một con số duy nhất. Manchester CCSR (2020) và Social Sci LibreTexts (2025) ghi nhận thêm một góc đọc khác, dựa trên tương quan Pearson giữa hai biến độc lập, với ngưỡng trên 0,7 đến 0,8 được coi là cao và cần cân nhắc trước khi đưa cả hai biến vào cùng một mô hình. Nếu bạn đang phân vân giữa việc bỏ một biến hay giữ nguyên mô hình vì VIF cao, đọc kỹ phần lỗi thường gặp bên dưới trước khi quyết định.
Những lỗi thường gặp khi chạy hồi quy tuyến tính trong SPSS là gì?
Trả lời thẳng: Ba lỗi thường gặp là chỉ nhìn ma trận tương quan mà không chạy VIF thật, cắt bỏ một biến để chỉnh cho được VIF cao mà không có lý do lý thuyết, và bỏ qua dấu hiệu đa cộng tuyến khi hệ số hồi quy đổi mạnh hoặc đổi dấu ngược kỳ vọng lúc thêm hay bớt biến khỏi mô hình.
Bằng chứng: Manchester CCSR (2020) liệt kê ba dấu hiệu của đa cộng tuyến trong kết quả: hệ số hồi quy không có ý nghĩa thống kê dù biến đó tương quan mạnh với biến phụ thuộc khi xét riêng lẻ, hệ số đổi mạnh khi thêm hoặc bớt một biến khác khỏi mô hình, và hệ số mang dấu ngược với kỳ vọng lý thuyết ban đầu. Một lỗi quy trình thường gặp là chỉ nhìn ma trận tương quan giữa từng cặp biến mà không chạy VIF thật, vì ma trận tương quan không phát hiện được đa cộng tuyến khi ba hoặc bốn biến cùng có quan hệ tuyến tính với nhau, và cắt bỏ một biến để làm giảm VIF mà không có lý do lý thuyết đi kèm.
Ví dụ: Nếu bạn thấy hệ số hồi quy của một biến đổi từ dương sang âm chỉ vì thêm một biến độc lập khác vào mô hình, đây là dấu hiệu cần soi lại bảng VIF trước khi kết luận biến đó không có tác động. Loại bỏ một biến chỉ vì VIF hơi cao mà không có căn cứ lý thuyết là quyết định dễ bị hội đồng chất vấn, vì bạn đang thay đổi mô hình nghiên cứu chỉ để đổi một con số thay vì trả lời câu hỏi nghiên cứu ban đầu. Sau khi thang đo đạt độ tin cậy đủ để tổng hợp thành biến, bước tiếp theo thường là đưa biến tổng hợp đó vào mô hình hồi quy, và kiểm định Cronbach's alpha là gì và alpha bao nhiêu là đạt trình bày quy trình đó trước khi tới bước này.
Nên báo cáo kết quả hồi quy tuyến tính thế nào trong luận văn?
Trả lời thẳng: Phần kết quả nên nêu rõ đã dùng Tolerance và VIF để kiểm tra đa cộng tuyến, báo cáo khoảng giá trị thu được, rồi kết luận có hay không có vấn đề, sau đó mới trình bày Sig. của mô hình, R² hoặc Adjusted R², và hệ số hồi quy của từng biến kèm mức ý nghĩa riêng.
Bằng chứng: Social Sci LibreTexts (2025) trình bày ví dụ đọc kết quả theo đúng thứ tự bốn bước đã nêu ở phần trên, từ VIF, tới Sig. trong ANOVA, tới R² trong Model Summary, rồi mới quay lại từng hệ số trong bảng Coefficients để diễn giải. Cách trình bày phổ biến khi báo cáo phần kiểm tra đa cộng tuyến là nêu rõ đã dùng Tolerance và VIF, kèm khoảng giá trị đo được, rồi kết luận có hay không có vấn đề trước khi chuyển sang kết quả hồi quy chính.
Ví dụ: Nếu VIF của mọi biến trong mô hình đều nằm trong khoảng 1 đến 3, bạn có thể viết ngắn gọn rằng không có bằng chứng đa cộng tuyến đáng kể, thay vì chỉ dán bảng số liệu mà không kết luận. Xem đề cương luận văn thạc sĩ gồm những phần nào nếu bạn cần biết phần phương pháp nên viết chi tiết tới mức nào trước khi tới phần kết quả này.
Câu hỏi thường gặp
Phân tích hồi quy đa biến trong SPSS khác gì hồi quy đơn biến?
Hồi quy đơn biến chỉ có một biến độc lập dự đoán biến phụ thuộc, còn hồi quy đa biến, hay còn gọi là hồi quy bội, có từ hai biến độc lập trở lên cùng đưa vào một mô hình. Hồi quy bội có thêm một giả định riêng là không có đa cộng tuyến giữa các biến độc lập, điều mà hồi quy đơn biến không cần kiểm vì chỉ có đúng một biến độc lập để so sánh.
VIF bao nhiêu là chấp nhận được trong hồi quy tuyến tính?
VIF bằng 1 là lý tưởng, VIF từ 1 đến 5 là mức tương quan vừa phải mà phần lớn nhà nghiên cứu chấp nhận, và VIF trên 5 là dấu hiệu cần chú ý. Một số ngành và hướng dẫn luận văn đặt ngưỡng khác, có nơi xem VIF trên 3 đã cần lưu ý, có nơi chỉ coi VIF trên 10 là nghiêm trọng, nên không có một con số tuyệt đối áp dụng cho mọi ngành.
R² và Adjusted R² khác nhau thế nào?
R² là tỷ lệ phương sai của biến phụ thuộc được các biến độc lập trong mô hình giải thích, nhưng có xu hướng tăng khi thêm biến vào mô hình dù biến đó không thực sự đóng góp. Adjusted R² điều chỉnh theo số biến độc lập trong mô hình, cho con số chính xác hơn khi so sánh các mô hình có số biến khác nhau, nên báo cáo cả hai thay vì chỉ dùng R² thô.
Đa cộng tuyến ảnh hưởng gì đến kết quả hồi quy?
Đa cộng tuyến làm sai số chuẩn của hệ số hồi quy bị phóng đại, khiến hệ số của một biến có thể không có ý nghĩa thống kê dù biến đó tương quan mạnh với biến phụ thuộc khi xét riêng lẻ. Đa cộng tuyến cũng làm hệ số hồi quy dễ đổi mạnh hoặc đổi dấu khi thêm hay bớt một biến khác khỏi mô hình, khiến việc diễn giải từng hệ số trở nên không đáng tin cậy.
Làm sao biết mô hình hồi quy có ý nghĩa thống kê không?
Xem cột Sig. trong bảng ANOVA sau khi chạy hồi quy trong SPSS. Nếu Sig. nhỏ hơn 0,05, mô hình tổng thể có ý nghĩa thống kê, nghĩa là ít nhất một biến độc lập trong mô hình thực sự có liên hệ với biến phụ thuộc. Kết quả này không cho biết biến nào có ý nghĩa riêng lẻ, vì mức ý nghĩa của từng biến nằm ở cột Sig. trong bảng Coefficients.
MAAS hỗ trợ gì cho sinh viên đang chạy hồi quy tuyến tính trong SPSS?
Chuyên gia MAAS đúng chuyên ngành sẽ ngồi cùng bạn từ bước chọn kiểm định phù hợp với dữ liệu và câu hỏi nghiên cứu, tới lúc bạn tự chạy hồi quy tuyến tính trong SPSS và đọc đúng các bảng Model Summary, ANOVA, Coefficients cùng chỉ số VIF trên chính dữ liệu của mình. Buổi đầu tiên kéo dài 15 phút và không tính phí. Xem thêm tại dịch vụ hướng dẫn chạy SPSS và Python, hoặc đặt lịch tại đây.
References
- Laerd Statistics. (n.d.-a). Linear regression analysis using SPSS Statistics. Retrieved September 17, 2026, from https://statistics.laerd.com/spss-tutorials/linear-regression-using-spss-statistics.php
- Laerd Statistics. (n.d.-b). Multiple regression analysis using SPSS Statistics. Retrieved September 17, 2026, from https://statistics.laerd.com/spss-tutorials/multiple-regression-using-spss-statistics.php
- Manchester CCSR. (2020). Multiple regression [Working paper]. Cathie Marsh Institute for Social Research, University of Manchester. https://hummedia.manchester.ac.uk/institutes/cmist/archive-publications/working-papers/2020/multiple-linear-regression.pdf
- Regorz-statistik.de. (n.d.). How to interpret a collinearity diagnostics table in SPSS. Retrieved September 17, 2026, from https://www.regorz-statistik.de/en/collinearity_diagnostics_table_SPSS.html
- Social Sci LibreTexts. (2025). 7.2.9: Quantitative analysis with SPSS: Multivariate regression. Retrieved September 17, 2026, from https://socialsci.libretexts.org/Workbench/Statistics_for_the_Behavioral_Sciences_(IVC_PSY_10)/07%3A_Part_7-_Statistics_Tool_Box/7.02%3A_Using_SPSS_for_Statistical_Analysis/7.2.09%3A_Quantitative_Analysis_with_SPSS-_Multivariate_Regression
- Statistics.arabpsychology.com. (n.d.). Understanding multicollinearity in regression analysis using SPSS. Retrieved September 17, 2026, from https://statistics.arabpsychology.com/test-for-multicollinearity-in-spss/
- Wlm.userweb.mwn.de. (n.d.). SPSS guide: Linear regression. Retrieved September 17, 2026, from https://wlm.userweb.mwn.de/SPSS/wlmsreg.htm