
Phân tích tương quan Pearson đo mức độ và chiều của quan hệ tuyến tính giữa hai biến, ra hệ số r từ −1 đến +1, chỉ đáng tin khi dữ liệu thỏa vài điều kiện.
Cập nhật lần cuối: 2026-09-14
Chuyên mục: research-methods
Phân tích tương quan Pearson là gì?
Trả lời thẳng: Tương quan Pearson là một phép đo thống kê cho biết hai biến liên tục có quan hệ tuyến tính với nhau ở mức độ nào và theo chiều nào. Kết quả là một hệ số, ký hiệu r khi tính trên mẫu và ρ (rho) khi nói về tổng thể, luôn nằm trong khoảng từ −1 đến +1.
Bằng chứng: PennState Eberly College of Science (n.d.-a) định nghĩa hệ số tương quan Pearson là thước đo mức độ và hướng của quan hệ tuyến tính giữa hai biến. Cùng nguồn này và Online Statistics Education (Lane et al., n.d.) xác nhận r luôn nằm trong đoạn từ −1 đến +1, trong đó r = +1 nghĩa là hai biến tăng giảm cùng chiều hoàn hảo, r = −1 nghĩa là chúng ngược chiều hoàn hảo, còn r = 0 nghĩa là không có quan hệ tuyến tính giữa chúng.
Ví dụ: Nếu một luận văn đo điểm chuyên cần và điểm thi cuối kỳ của sinh viên, r dương và gần 1 cho biết sinh viên chuyên cần cao thường cũng đạt điểm thi cao.
Hệ số tương quan Pearson r được tính như thế nào?
Trả lời thẳng: Về mặt khái niệm, r có thể tính theo hai cách tương đương: nhân điểm chuẩn hoá của X và Y cho từng cặp, cộng lại rồi chia cho (n−1), hoặc lấy hiệp phương sai của X và Y chia cho tích độ lệch chuẩn của hai biến. SPSS và các phần mềm thống kê tính con số này tự động, nhưng hiểu công thức giúp người đọc biết r đang so sánh cái gì với cái gì.
Bằng chứng: PennState Stat 200 (n.d.-b) trình bày công thức r dưới dạng tổng tích điểm chuẩn hoá (z) của hai biến chia cho (n−1). PennState Stat 509 (n.d.-a) trình bày cùng hệ số r dưới dạng hiệp phương sai của hai biến chia cho căn bậc hai của tích hai phương sai, tức cùng một con số nhưng viết theo công thức hiệp phương sai. Online Statistics Education (Lane et al., n.d.) bổ sung rằng r bất biến với phép biến đổi tuyến tính, nghĩa là đổi đơn vị đo không làm thay đổi giá trị r. Janse và cộng sự (2021) cũng xác nhận mọi phép biến đổi tuyến tính hay đổi thang đo của một hoặc cả hai biến đều không làm thay đổi hệ số tương quan.
Ví dụ: Tương quan giữa chiều cao và cân nặng của một nhóm sinh viên vẫn cho ra cùng một hệ số r dù chiều cao được đo bằng centimet hay bằng mét.
Những điều kiện nào cần thỏa trước khi chạy tương quan Pearson?
Trả lời thẳng: Trước khi tin vào một hệ số r, dữ liệu cần thỏa một số điều kiện: cả hai biến được đo ở thang khoảng hoặc thang tỷ lệ, quan hệ giữa chúng có dạng tuyến tính, các quan sát độc lập với nhau, không có điểm dữ liệu ngoại lai (outlier) ảnh hưởng lớn, mỗi biến xấp xỉ phân phối chuẩn, và phương sai đồng nhất dọc theo đường quan hệ giữa hai biến.
Bằng chứng: Laerd Statistics (n.d.) liệt kê nhóm điều kiện này. PennState Eberly College of Science (n.d.-a) và Aggarwal và Ranganathan (2016) nhấn mạnh cùng nhóm điều kiện, đặc biệt quan hệ tuyến tính và việc kiểm tra outlier, và đều khuyên vẽ biểu đồ phân tán (scatterplot) trước khi tính r để phát hiện outlier hay nhóm ẩn. Aggarwal và Ranganathan (2016), trong bài thứ tám thuộc loạt bài Common Pitfalls in Statistical Analysis, còn lưu ý tương quan giả định các quan sát độc lập với nhau, nên không dùng khi bộ dữ liệu có nhiều hơn một lần đo trên cùng một người, và với mẫu rất nhỏ, khoảng 3 đến 6 quan sát, một mối quan hệ có thể hiện ra dù thực tế không tồn tại. Janse và cộng sự (2021) cũng khuyên xem biểu đồ phân tán trước, để đánh giá dữ liệu có thể mô tả bằng một quan hệ tuyến tính hay không và việc tính hệ số tương quan có hợp lý hay không.
Ví dụ: Trước khi chạy tương quan Pearson giữa số giờ tự học và điểm thi, người viết luận văn nên vẽ scatterplot trước, để xem quan hệ có thật sự là một đường thẳng hay có vài sinh viên với số liệu bất thường kéo lệch cả kết quả.
Hệ số r bao nhiêu thì được xem là mạnh hay yếu?
Trả lời thẳng: Không có một bảng ngưỡng duy nhất được mọi tài liệu thống nhất. Ít nhất hai cách chia phổ biến đang cùng tồn tại, và một luận văn cần nói rõ mình đang dùng thang nào, thay vì trộn lẫn các con số của các thang khác nhau lại với nhau. Dù dùng thang nào, con số r vẫn cần được đọc cùng bối cảnh và mục đích của nghiên cứu.
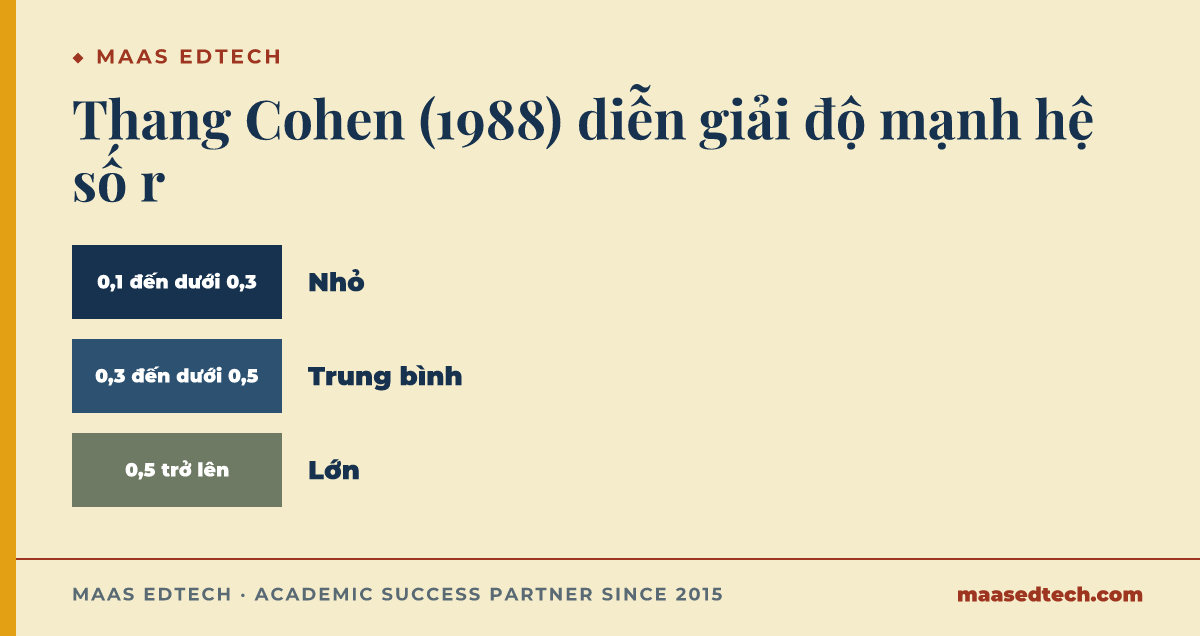
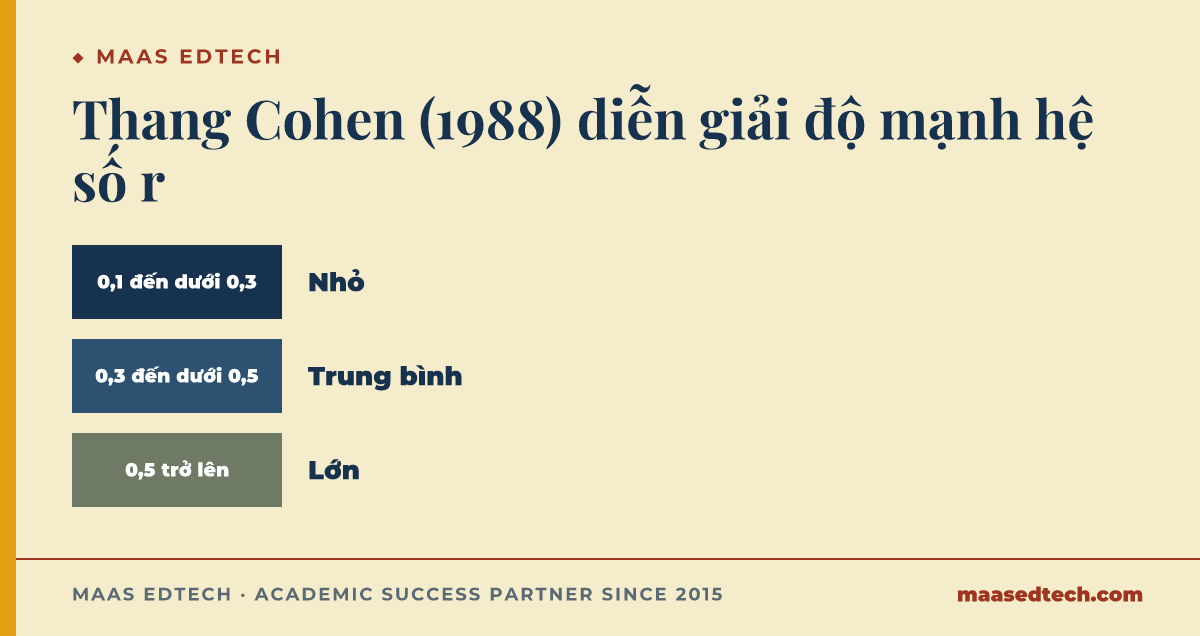
Bằng chứng: Loughborough University (n.d.) trích dẫn trực tiếp mốc năm 1988 do Cohen đề xuất, theo đó giá trị tuyệt đối của r bằng 0,1 là nhỏ, 0,3 là trung bình, và 0,5 là lớn. Maricopa Open Digital Press (2021) và Laerd Statistics (n.d.) dùng cùng ba mốc này, chỉ trình bày lại dưới dạng khoảng thay vì mốc đơn lẻ. PennState Stat 200 (n.d.-b) lại đưa ra cách chia năm mức khác, từ rất yếu đến rất mạnh theo từng khoảng 0,2. Janse và cộng sự (2021) còn đi xa hơn, cho rằng không nên áp các quy tắc ngón tay cái như vậy cho hệ số tương quan, vì cách diễn giải luôn phải phụ thuộc vào bối cảnh và mục đích của nghiên cứu.
| Mức độ mạnh | Thang năm 1988 do Cohen đề xuất, theo Loughborough/Laerd | Thang 5 mức (PennState) |
|---|---|---|
| Yếu | 0,1 đến dưới 0,3 | 0 đến 0,2 là rất yếu, 0,2 đến 0,4 là yếu |
| Trung bình | 0,3 đến dưới 0,5 | 0,4 đến 0,6 |
| Mạnh | 0,5 trở lên | 0,6 đến 0,8 là mạnh, 0,8 đến 1,0 là rất mạnh |
Ví dụ: Một luận văn báo cáo r = 0,42 nên nói rõ mình dùng thang nào. Theo mốc năm 1988 của Cohen, đây là mức trung bình, còn theo thang 5 mức của PennState, đây cũng rơi vào mức trung bình.
r² (hệ số xác định) khác gì so với r?
Trả lời thẳng: r² là bình phương của hệ số tương quan r, biểu thị tỷ lệ phương sai của một biến được giải thích bởi biến kia. Trong khi r nói về mức độ và chiều của quan hệ tuyến tính, r² nói về việc biến này giải thích được bao nhiêu phần biến thiên của biến kia, tính theo phần trăm.
Bằng chứng: Aggarwal và Ranganathan (2016) đưa ví dụ cụ thể, nếu r = 0,80 giữa chiều cao và cân nặng thì r² = 0,64, nghĩa là 64% phương sai của cân nặng được giải thích bởi chiều cao. Cũng theo nguồn này, ở mẫu cỡ trung bình đến lớn, giá trị p có thể cho một hệ số r rất nhỏ vẫn hiện ra là có ý nghĩa thống kê, nên hai tác giả khuyên nên đọc r² thay vì chỉ đọc r để đánh giá mức độ quan trọng thực tiễn của một mối quan hệ.
Ví dụ: Hai luận văn cùng báo cáo r = 0,80, nhưng một luận văn còn tính thêm r² = 0,64 và giải thích 64% biến thiên của biến phụ thuộc gắn liền với biến độc lập đang xét, sẽ cho thấy phần diễn giải kết quả sâu hơn.
Những lỗi diễn giải thường gặp khi đọc kết quả tương quan Pearson là gì?
Trả lời thẳng: Sáu lỗi diễn giải thường gặp là nhầm tương quan với quan hệ nhân quả, bỏ sót ảnh hưởng của một điểm dữ liệu ngoại lai, bỏ qua khả năng quan hệ thực tế là phi tuyến, gộp chung các phân nhóm khác biệt trong cùng một mẫu, bỏ qua phương sai không đồng nhất, và nhầm ý nghĩa thống kê với ý nghĩa thực tiễn.
Bằng chứng: Aggarwal và Ranganathan (2016) trình bày bốn tình huống làm sai lệch cách đọc r. Một outlier duy nhất có thể kéo r từ gần 0 lên tới 0,71, và loại điểm đó ra thì r giảm gần về 0. Một quan hệ phi tuyến, ví dụ lực nắm tay tăng theo tuổi ở trẻ em rồi giảm dần ở người lớn tuổi, có thể cho r gần 0 dù thực tế có quan hệ rõ ràng dạng đường cong. Gộp chung hai phân nhóm ẩn, ví dụ gộp cả nam và nữ khi phân tích chiều cao và mức hemoglobin, có thể tạo ra r dương giả dù từng nhóm riêng không hề có tương quan. Phương sai không đồng nhất, ví dụ chi tiêu y tế biến động nhiều hơn hẳn ở nhóm thu nhập cao, cũng làm sai lệch cách diễn giải r. Cùng nguồn này và Janse và cộng sự (2021) đều nhấn mạnh tương quan không chứng minh được quan hệ nhân quả, vì hai biến có thể cùng tương quan do chịu tác động từ một biến thứ ba. Janse và cộng sự (2021) lấy ví dụ việc dùng thuốc ức chế men chuyển ACE và mức suy giảm chức năng thận có tương quan chặt với nhau, không phải vì thuốc gây suy thận mà vì cả hai cùng chịu tác động của một nguyên nhân chung là tình trạng albumin niệu. Loughborough University (n.d.) cũng nhấn mạnh quan hệ nhân quả chỉ xác lập được bằng một thử nghiệm ngẫu nhiên có đối chứng. Hole (n.d.) gọi nguyên tắc này là "điều quan trọng bậc nhất cần nhớ về tương quan" (Hole, n.d., tr. 1). Aggarwal và Ranganathan (2016) dẫn ví dụ mức tiêu thụ sô-cô-la bình quân đầu người và số người đoạt giải Nobel trên 10 triệu dân của các quốc gia có tương quan với nhau, một phát hiện Messerli công bố năm 2012, trong khi cả hai biến thực chất cùng gắn với thu nhập quốc gia. Janse và cộng sự (2021) chỉ ra thêm một bẫy khác là biên độ dữ liệu. Trên 50 quan sát giả định có r = 0,87, chỉ giữ lại 25 quan sát thấp nhất thì r giảm còn 0,57, nên không thể so sánh trực tiếp hệ số r giữa các nhóm hay các nghiên cứu có biên độ dữ liệu khác nhau. Hole (n.d.) minh hoạ cùng hiện tượng bằng tương quan giữa IQ và kết quả học tập, vốn mạnh hơn khi xét toàn dân số so với khi chỉ xét riêng sinh viên đại học, vì biên độ của cả hai biến trong nhóm sinh viên hẹp hơn. Hole (n.d.) cũng chỉ ra rằng khi cỡ mẫu đủ lớn (ví dụ 102 người trong ví dụ của tác giả), một hệ số r nhỏ chỉ khoảng 0,19 vẫn có thể đạt ý nghĩa thống kê, nhưng điều đó không đồng nghĩa với ý nghĩa thực tiễn.
Ví dụ: Một luận văn cỡ mẫu 400 sinh viên báo cáo r = 0,19 giữa thời gian dùng mạng xã hội và điểm trung bình, kèm p nhỏ hơn 0,05, và kết luận vội đây là phát hiện quan trọng. Nhưng r² chỉ khoảng 0,036, nghĩa là thời gian dùng mạng xã hội chỉ giải thích chưa tới 4% biến thiên của điểm trung bình.
Khi nào nên dùng tương quan Spearman thay vì Pearson?
Trả lời thẳng: Khi dữ liệu không thỏa các điều kiện của Pearson, ví dụ quan hệ giữa hai biến không tuyến tính, dữ liệu không xấp xỉ phân phối chuẩn, hoặc biến được đo ở thang thứ hạng (ordinal) thay vì thang khoảng, nên chuyển sang dùng hệ số tương quan Spearman. Spearman tính trên thứ hạng của dữ liệu thay vì giá trị gốc, nên cũng ít nhạy cảm với outlier hơn Pearson.
Bằng chứng: Loughborough University (n.d.) khuyến nghị dùng hệ số tương quan Spearman hoặc Kendall khi dữ liệu vi phạm giả định tuyến tính hoặc phân phối chuẩn của Pearson, hoặc khi dữ liệu vốn là thứ hạng. Janse và cộng sự (2021) và Laerd Statistics (n.d.) đều ghi nhận Spearman ít nhạy cảm với outlier hơn Pearson, vì Spearman tính trên thứ hạng của các giá trị thay vì tính trực tiếp trên giá trị gốc. Aggarwal và Ranganathan (2016) lấy ví dụ thang tự đánh giá mức đau từ 0 đến 10, trong đó quãng từ 1 đến 3 và quãng từ 6 đến 8 không nhất thiết phản ánh cùng một mức thay đổi, nên dữ liệu thứ hạng kiểu này cần dùng tương quan Spearman.
Ví dụ: Nếu một luận văn khảo sát mức độ hài lòng của khách hàng theo thang đo thứ hạng từ 1 đến 5, tương quan Spearman phù hợp hơn Pearson. Cách chọn kiểm định phù hợp với từng loại dữ liệu cũng là bước cần làm rõ trước khi chạy phân tích thống kê, tương tự cách phân biệt ANOVA với các kiểm định khác theo tình huống nghiên cứu (xem Nên chọn kiểm định nào cho một biến định lượng và các nhóm cần so sánh). Bài Thang đo Likert 5 mức độ là gì giải thích vì sao chỉ điểm thang đo tổng hợp, không phải từng mục hỏi riêng lẻ, mới nên đưa vào tương quan Pearson.
Câu hỏi thường gặp
Tương quan Pearson và tương quan Spearman khác nhau ở điểm nào?
Pearson đo quan hệ tuyến tính giữa hai biến đo ở thang khoảng hoặc tỷ lệ và yêu cầu dữ liệu xấp xỉ phân phối chuẩn, còn Spearman tính trên thứ hạng của dữ liệu, phù hợp với dữ liệu thứ hạng hoặc khi dữ liệu vi phạm các giả định của Pearson.
Tương quan Pearson có chứng minh được quan hệ nhân quả không?
Không. Hai biến có tương quan với nhau không có nghĩa là biến này gây ra biến kia, vì cả hai có thể cùng chịu ảnh hưởng từ một biến thứ ba mà phân tích không đo tới.
Cỡ mẫu bao nhiêu là đủ để chạy tương quan Pearson?
Cỡ mẫu cần thiết tuỳ vào từng đề tài. Cỡ mẫu quá nhỏ khiến kết quả kém ổn định, còn cỡ mẫu quá lớn có thể khiến một hệ số r rất nhỏ vẫn đạt ý nghĩa thống kê dù không có ý nghĩa thực tiễn. Hole (n.d.) minh hoạ độ bất ổn của mẫu nhỏ bằng một bảng mô phỏng hai biến thực tế không tương quan, trong đó 80% hệ số r tính từ mẫu vẫn dao động từ −0,69 tới 0,69 khi cỡ mẫu là 5, từ −0,35 tới 0,35 khi cỡ mẫu là 15, từ −0,18 tới 0,18 khi cỡ mẫu là 50, từ −0,13 tới 0,13 khi cỡ mẫu là 100, và từ −0,09 tới 0,09 khi cỡ mẫu là 200.
Vì sao một điểm dữ liệu ngoại lai (outlier) có thể làm sai lệch cả kết quả tương quan?
Vì công thức tính r dựa trên độ lệch của từng điểm so với giá trị trung bình, nên một điểm cách xa phần còn lại của dữ liệu có thể kéo lệch hệ số r đáng kể.
r = 0 có nghĩa là hai biến hoàn toàn không liên quan không?
Không hẳn. r = 0 chỉ cho biết không có quan hệ tuyến tính giữa hai biến, nhưng chúng vẫn có thể có một quan hệ phi tuyến rõ rệt mà hệ số Pearson không đo được.
Nên đọc r hay r² khi báo cáo kết quả trong luận văn?
Nên báo cáo cả hai. r cho biết chiều và mức độ của quan hệ tuyến tính, còn r² cho biết bao nhiêu phần trăm biến thiên của một biến được giải thích bởi biến kia.
MAAS đồng hành thế nào với phần chạy tương quan Pearson trong luận văn?
Chọn đúng kiểm định (xem thêm SPSS thực hiện được những nhóm kiểm định thống kê nào), chạy đúng lệnh, và đọc đúng hệ số r cùng r² là ba bước riêng biệt, và khi bảo vệ, người viết cần tự giải thích được vì sao con số đó có ý nghĩa. Chuyên gia MAAS hướng dẫn bạn chọn kiểm định phù hợp, chạy phân tích trên chính bộ dữ liệu của mình và đọc kết quả, để bạn hiểu và tự bảo vệ được phần phân tích số liệu. MAAS không làm trọn dự án dữ liệu hay lập trình thay bạn. Đặt buổi tư vấn miễn phí 15 phút để trao đổi về bộ dữ liệu và kiểm định bạn đang cần chạy, hoặc xem dịch vụ hướng dẫn chạy SPSS và Python.
References
- Aggarwal, R., & Ranganathan, P. (2016). Common pitfalls in statistical analysis: The use of correlation techniques. Perspectives in Clinical Research, 7(4), 187-190. https://doi.org/10.4103/2229-3485.192046
- Hole, G. (n.d.). Eight things you need to know about interpreting correlations. University of Sussex. Retrieved September 14, 2026, from https://users.sussex.ac.uk/~grahamh/RM1web/Eight%20things%20you%20need%20to%20know%20about%20interpreting%20correlations.pdf
- Janse, R. J., Hoekstra, T., Jager, K. J., Zoccali, C., Tripepi, G., Dekker, F. W., & van Diepen, M. (2021). Conducting correlation analysis: Important limitations and pitfalls. Clinical Kidney Journal, 14(11), 2332-2337. https://doi.org/10.1093/ckj/sfab085
- Lane, D. M., et al. (n.d.). Values of the Pearson correlation. Online Statistics Education. Retrieved September 14, 2026, from https://onlinestatbook.com/lms/describing_bivariate_data/bivariate.pdf
- Loughborough University. (n.d.). Pearson correlation [statstutor resource]. Retrieved September 14, 2026, from https://statstutor.lboro.ac.uk/resources/uploaded/pearsoncorrelation3.pdf
- Maricopa Open Digital Press. (2021). Chapter 16: Correlations. In Introduction to statistics for psychology. Retrieved September 14, 2026, from https://open.maricopa.edu/psy230mm/chapter/chapter-16-correlations/
- PennState Eberly College of Science. (n.d.-a). 18.1 - Pearson correlation coefficient. STAT 509. Retrieved September 14, 2026, from https://online.stat.psu.edu/stat509/book/export/html/784
- PennState Eberly College of Science. (n.d.-b). 12.2 - Correlation. STAT 200. Retrieved September 14, 2026, from https://online.stat.psu.edu/stat200/book/export/html/239
- Laerd Statistics. (n.d.). Pearson product-moment correlation. Retrieved September 14, 2026, from https://statistics.laerd.com/statistical-guides/pearson-correlation-coefficient-statistical-guide.php