
◆ Phương pháp nghiên cứu
Mô hình SEM là gì và nên chọn CB-SEM hay PLS-SEM?
Mô hình SEM kiểm định điều gì trong luận văn, và bộ dữ liệu của bạn hợp với CB-SEM hay PLS-SEM, là hai câu hỏi bạn sẽ tự trả lời được khi đọc tới cuối bài.
Bài viết dành cho sinh viên đại học, học viên cao học và nghiên cứu sinh đang viết bằng tiếng Việt và đã có hoặc sắp có bảng hỏi với nhiều khái niệm cần đo. Kết quả mong đợi là bạn giải thích được vì sao mình chọn một nhánh ước lượng và đọc đúng các chỉ số đánh giá mô hình. Thao tác trên từng phần mềm được giữ riêng ở hai bài chị em, nên ở đây bạn chỉ cần nắm cách nghĩ về mô hình.
◆ Câu hỏi 1 / 8 · Mô hình SEM
Mô hình SEM là gì?
Trả lời thẳng: Mô hình SEM là phương pháp thống kê ước lượng cùng lúc nhiều quan hệ giữa các biến, kể cả những biến không đo trực tiếp được, và tính đến sai số đo lường. Hair và cộng sự (2021) gọi SEM là kỹ thuật thế hệ thứ hai, vì hồi quy và ANOVA có mô hình quá đơn giản, chỉ xử lý biến quan sát được và giả định không có sai số đo lường.
SEM là viết tắt của structural equation modeling, thường được dịch là mô hình phương trình cấu trúc. Trong tiếng Việt, nhiều người còn gọi nó là mô hình cấu trúc tuyến tính, và đó là cùng một phương pháp chứ không phải một kỹ thuật khác.
Điểm làm SEM khác một mô hình hồi quy thông thường là nó cho phép một biến vừa giải thích biến này vừa được biến khác giải thích. UCLA Advanced Research Computing (n.d.) mô tả hồi quy tuyến tính, hồi quy đa biến, phân tích đường dẫn, phân tích nhân tố khẳng định và hồi quy cấu trúc đều là những trường hợp đặc biệt của SEM. Nếu bạn đã quen với hồi quy trong SPSS thì SEM là bước mở rộng chứ không phải một thế giới mới.
Trong luận văn, SEM thường xuất hiện khi mô hình nghiên cứu có nhiều khái niệm như chất lượng dịch vụ, sự hài lòng và lòng trung thành, mỗi khái niệm được đo bằng nhiều câu hỏi trong bảng hỏi, và các khái niệm đó tác động lẫn nhau theo một chuỗi. Với một biến độc lập và một biến phụ thuộc thì hồi quy đủ dùng, như bài hồi quy tuyến tính trong SPSS đã trình bày.
◆ Câu hỏi 2 / 8 · Mô hình SEM gồm
Mô hình SEM gồm những phần nào?
Trả lời thẳng: Mô hình SEM gồm hai phần là mô hình đo lường và mô hình cấu trúc. Mô hình đo lường nối các câu hỏi quan sát được với khái niệm tiềm ẩn mà chúng đại diện, còn mô hình cấu trúc nối các khái niệm tiềm ẩn với nhau. UCLA Advanced Research Computing (n.d.) dùng đúng hai tên gọi này, và Iacobucci (2009) chỉ ra phần đo lường về bản chất là phân tích nhân tố khẳng định.
Phần đo lường quyết định bạn có đang đo đúng khái niệm hay không, nên nó cần được kiểm tra trước. Iacobucci (2009) khuyên nên xác nhận mô hình đo lường khớp tương đối tốt rồi mới xét các đường dẫn của phần cấu trúc, vì nếu thang đo đã lệch thì các hệ số đường dẫn phía sau không còn nhiều ý nghĩa. Vì vậy trước SEM bạn thường đã có bước kiểm tra độ tin cậy như Cronbach's alpha và bước gom câu hỏi thành nhân tố như phân tích nhân tố khám phá EFA. Bước xác nhận cấu trúc đo lường đó được giải thích riêng ở bài phân tích nhân tố khẳng định CFA.
Phần cấu trúc dùng hai loại biến. UCLA Advanced Research Computing (n.d.) gọi biến chỉ giải thích biến khác là biến ngoại sinh, và biến được ít nhất một đường dẫn trỏ tới là biến nội sinh. Một khái niệm trung gian như sự hài lòng sẽ là nội sinh vì nó được chất lượng dịch vụ giải thích, đồng thời lại đi tiếp để giải thích lòng trung thành. Khái niệm trung gian này được nói kỹ ở bài biến trung gian và biến điều tiết.
Còn một khác biệt về hướng mũi tên trong phần đo lường. Hair và cộng sự (2021) phân biệt thang đo phản xạ, trong đó mũi tên đi từ khái niệm tới từng chỉ báo và mỗi chỉ báo có sai số riêng, với thang đo hình thành, trong đó mũi tên đi từ các chỉ báo tới khái niệm và không có sai số ở chỉ báo. Bạn nên xác định kiểu thang đo của mình trước khi chọn nhánh ước lượng.
◆ Câu hỏi 3 / 8 · CB-SEM và PLS-SEM khác nhau
CB-SEM và PLS-SEM khác nhau thế nào?
Trả lời thẳng: CB-SEM và PLS-SEM khác nhau ở mục đích và cách ước lượng. Hair và cộng sự (2021) cho biết CB-SEM chủ yếu dùng để xác nhận hoặc bác bỏ lý thuyết, và ước lượng sao cho ma trận hiệp phương sai của mô hình gần ma trận của mẫu nhất. PLS-SEM tính các biến tổng hợp từ chỉ báo và tối đa hoá phương sai giải thích của biến nội sinh, nên hướng về dự báo.
Ba điểm khác nhau giữa CB-SEM và PLS-SEM
Mỗi hàng đặt một tiêu chí cạnh cách hai nhánh xử lý nó.
Tiêu chí
CB-SEM và PLS-SEM
Mục đích chính
Xác nhận hoặc bác bỏ lý thuyết, so với giải thích phương sai và dự báo biến phụ thuộc
Cách coi biến tiềm ẩn
Nhân tố chung chỉ dùng phương sai chung, so với biến tổng hợp từ chỉ báo dùng toàn bộ phương sai
Thang đo hình thành
Làm được nhưng phải đặt ràng buộc, so với xử lý trực tiếp
Lưu hình này
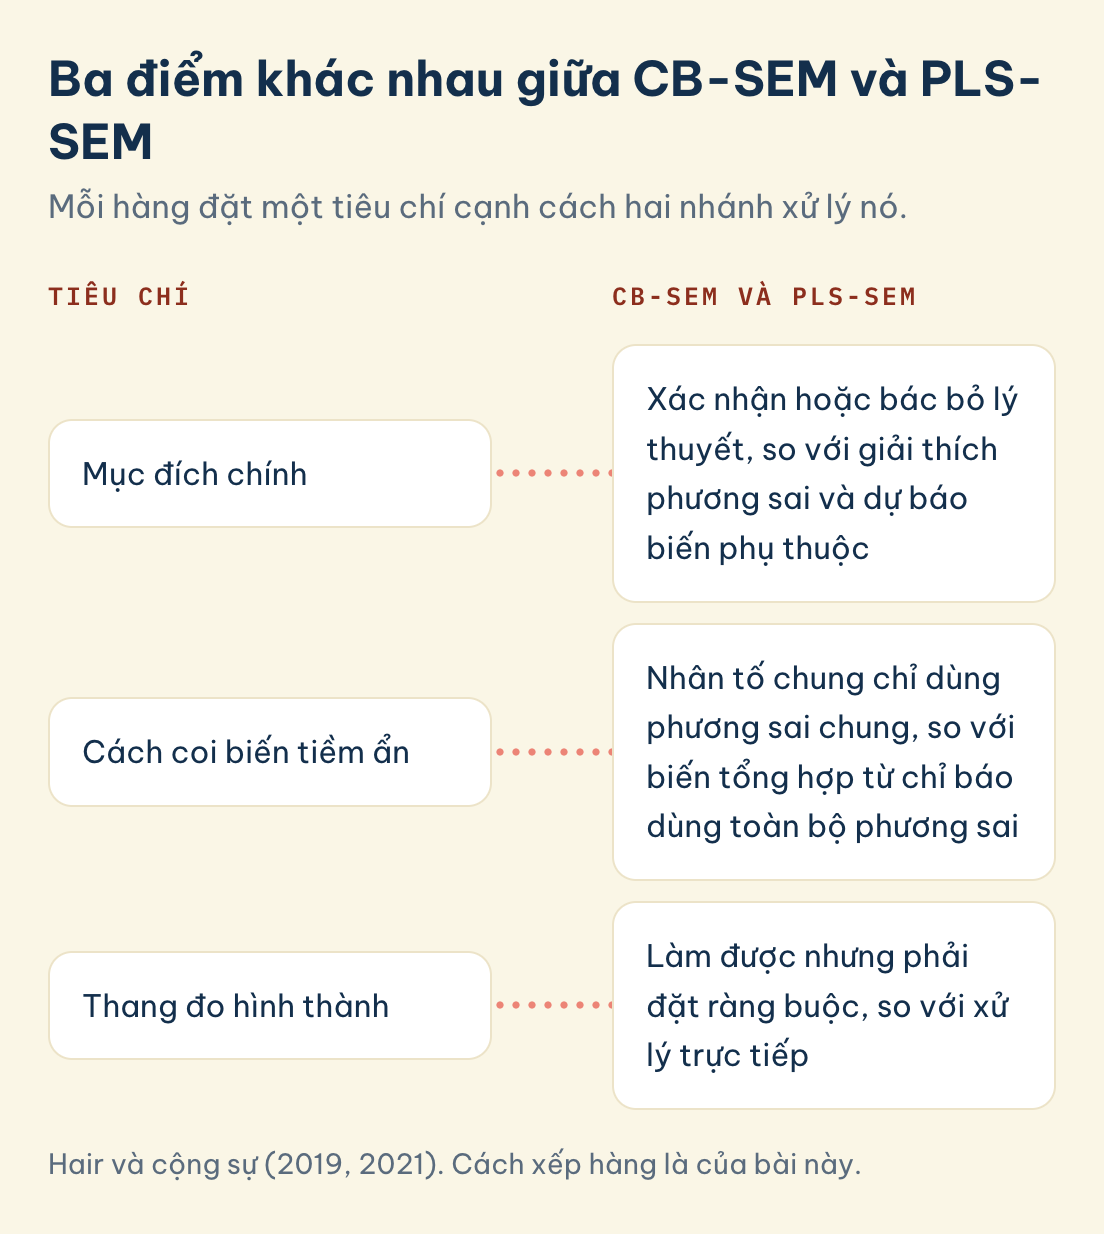
Hair và cộng sự (2021) viết rằng "CB-SEM is primarily used to confirm (or reject) theories and their underlying hypotheses", và cũng chính nhóm tác giả này mô tả PLS-SEM theo hướng dự báo và giải thích. Về mặt kỹ thuật, CB-SEM chỉ dùng phương sai chung của các chỉ báo, còn PLS-SEM dùng toàn bộ phương sai và chạy các hồi quy bình phương nhỏ nhất lặp lại. Bảng dưới đây tóm tắt năm điểm khác nhau mà người mới dễ nhầm nhất.
| Tiêu chí | CB-SEM | PLS-SEM |
|---|---|---|
| Mục đích chính | Xác nhận hoặc bác bỏ lý thuyết, theo Hair và cộng sự (2021) | Giải thích phương sai và dự báo biến phụ thuộc, theo Hair và cộng sự (2021) |
| Cách coi biến tiềm ẩn | Nhân tố chung, chỉ dùng phương sai chung, theo Hair và cộng sự (2021) | Biến tổng hợp từ chỉ báo, dùng toàn bộ phương sai, theo Hair và cộng sự (2021) |
| Độ phù hợp toàn mô hình | Chi bình phương cùng các chỉ số như CFI, RMSEA, SRMR, với ngưỡng theo Hu và Bentler (1999) | Chưa có thước đo đã được thiết lập, theo Hair và cộng sự (2021), đánh giá bằng R², Q² và PLSpredict theo Hair và cộng sự (2019) |
| Cỡ mẫu | Tuỳ từng mô hình, từ 30 đến 460 trong mô phỏng của Wolf và cộng sự (2013) | Chạy được mẫu nhỏ nhưng nên phân tích công suất, theo Hair và cộng sự (2019) |
| Thang đo hình thành | Làm được nhưng phải đặt ràng buộc, theo Hair và cộng sự (2021) | Xử lý trực tiếp, theo Hair và cộng sự (2019) |
Một điều hay bị hiểu sai là CB-SEM chỉ dùng được cho thang đo phản xạ. Hair và cộng sự (2021) cho biết CB-SEM vẫn xử lý được thang đo hình thành, nhưng muốn mô hình xác định được thì phải đặt các ràng buộc, và các ràng buộc này thường mâu thuẫn với cân nhắc lý thuyết. Vì vậy chọn PLS-SEM khi có thang đo hình thành là hợp lý, còn câu "CB-SEM không làm được" thì nói quá.
Phần chọn nhánh cũng nên được hiểu là chọn theo mục tiêu, không phải chọn nhánh nào "hiện đại" hơn. Hair và cộng sự (2021) kết luận hai nhánh nên được coi là bổ trợ cho nhau: "Researchers should consider the two SEM approaches as complementary and apply the SEM technique that best suits their research objective, data characteristics, and model setup." Với luận văn, câu hỏi đáng đặt trước là đề tài của bạn đang xác nhận một lý thuyết có sẵn hay đang tìm yếu tố dự báo một biến kết quả.
◆ Câu hỏi 4 / 8 · PLS-SEM là gì, và khi
PLS-SEM là gì, và khi nào nên chọn?
Trả lời thẳng: PLS-SEM là nhánh SEM dựa trên bình phương nhỏ nhất từng phần, trong đó các chỉ báo được gộp thành biến tổng hợp rồi quan hệ giữa chúng được ước lượng qua các hồi quy lặp. Hair và cộng sự (2019) xem nhánh này thích hợp khi đề tài hướng tới dự báo, khám phá hoặc có thang đo hình thành, còn phân phối lệch chuẩn tự nó không phải căn cứ đủ mạnh.
Bạn cũng sẽ gặp tên này viết là PLS SEM hoặc chỉ PLS, và đều chỉ cùng một nhánh. Hair và cộng sự (2019) nêu chín tình huống nên cân nhắc PLS-SEM, gồm cả trường hợp dữ liệu là tỉ số tài chính, dữ liệu thứ cấp và trường hợp cần điểm số của biến tiềm ẩn cho phân tích tiếp theo. Cũng theo nhóm tác giả này, PLS-SEM không chỉ dành cho mẫu nhỏ mà còn hoạt động rất tốt với mẫu lớn.
Về dữ liệu không chuẩn, Hair và cộng sự (2019) cho biết ước lượng khả năng cực đại của CB-SEM khá bền với vi phạm phân phối chuẩn, nhưng có thể cần cỡ mẫu lớn hơn nhiều, và chọn PLS-SEM chỉ vì dữ liệu không chuẩn thường là chưa đủ lý do. Nếu hội đồng hỏi vì sao bạn chọn PLS-SEM, câu trả lời gắn với mục tiêu dự báo hoặc thang đo hình thành sẽ vững hơn câu "vì dữ liệu không chuẩn".
Có một hạn chế bạn phải biết trước khi viết phần phương pháp. Hair và cộng sự (2021) cho biết PLS-SEM chưa có thước đo độ phù hợp toàn mô hình đã được thiết lập, và khái niệm độ phù hợp theo nghĩa của CB-SEM không áp dụng cho nhánh này. Hair và cộng sự (2019) nói thêm rằng các thước đo dựa trên chi bình phương cùng phần mở rộng của chúng không áp dụng được, và chỉ số như SRMR cần hết sức thận trọng khi dùng. Vì vậy một luận văn dùng PLS-SEM mà báo cáo "chỉ số fit" như kiểu CB-SEM sẽ đưa ra tín hiệu rằng người viết chưa hiểu hai nhánh khác nhau ở đâu.
◆ Câu hỏi 5 / 8 · Cỡ mẫu cho mô hình
Cỡ mẫu cho mô hình SEM nên là bao nhiêu?
Trả lời thẳng: Mẫu cần cho một mô hình SEM thay đổi theo số chỉ báo, hệ số tải và độ phức tạp của mô hình, nên không có một con số chung. Wolf và cộng sự (2013) cho thấy mẫu cần có thể nhỏ như 30 hoặc lớn tới 460 tuỳ mô hình, nên các quy tắc cố định chỉ nên được coi là điểm xuất phát chứ không phải bằng chứng đủ mẫu.
Nhiều người nhớ các quy tắc như mẫu tối thiểu 100 hoặc 200, mười ca cho mỗi biến. Wolf và cộng sự (2013) nhận xét rằng các quy tắc này không được xây dựng riêng cho từng mô hình, nên có thể ước tính quá thấp hoặc quá cao. Trong mô phỏng Monte Carlo của họ, mô hình phân tích nhân tố khẳng định một nhân tố với bốn chỉ báo cần khoảng 190 quan sát khi hệ số tải là 0,50 và khoảng 60 quan sát khi hệ số tải là 0,80, còn mô hình hai nhân tố với ba chỉ báo mỗi nhân tố và hệ số tải 0,50 cần khoảng 460. Số chỉ báo cho mỗi nhân tố nhiều hơn thường làm mẫu cần thiết giảm xuống.
UCLA Advanced Research Computing (n.d.) dẫn lại một quy tắc khác là tỉ lệ 20 quan sát trên mỗi tham số cần ước lượng, nghĩa là mô hình có 10 tham số thì cần mẫu 200. Cùng nguồn này nói mẫu lớn hơn luôn được ưu tiên hơn. Bạn nên xem các con số ấy như mức tham khảo rồi giải thích lựa chọn của mình trong phần phương pháp.
Với PLS-SEM, Hair và cộng sự (2019) cho biết nhánh này chạy được với mẫu nhỏ, nhưng không biến một mẫu kém đại diện thành mẫu tốt, và cỡ mẫu nên được xác định bằng phân tích công suất.
◆ Câu hỏi 6 / 8 · Làm sao biết mô hình
Làm sao biết mô hình SEM phù hợp với dữ liệu?
Trả lời thẳng: Với CB-SEM, bạn đánh giá độ phù hợp bằng chi bình phương cùng các chỉ số như CFI, TLI, RMSEA và SRMR, và nên đọc nhiều chỉ số cùng lúc thay vì một chỉ số. Hu và Bentler (1999) đề xuất cặp SRMR với một chỉ số khác. PLS-SEM không dùng bộ chỉ số này mà đánh giá mô hình đo lường và mô hình cấu trúc bằng tiêu chí riêng.
Hu và Bentler (1999) nêu giá trị gần 0,95 cho TLI và CFI, gần 0,08 cho SRMR và gần 0,06 cho RMSEA thì mới kết luận mô hình khớp tương đối tốt, và họ lưu ý TLI cùng RMSEA dễ loại nhầm mô hình đúng khi mẫu nhỏ. UCLA Advanced Research Computing (n.d.) đưa ngưỡng riêng cho RMSEA, với giá trị từ 0,05 trở xuống là khớp sát, từ 0,05 đến 0,08 là khớp xấp xỉ chấp nhận được và từ 0,10 trở lên là khớp kém.
Chi bình phương cũng cần được đọc cẩn thận. UCLA Advanced Research Computing (n.d.) cảnh báo "chi-square is often overly sensitive in model testing especially for large samples", nghĩa là mẫu càng lớn thì chi bình phương càng dễ báo mô hình không khớp dù sai lệch nhỏ. Điều kiện để chi bình phương có ý nghĩa là mô hình phải quá xác định. Số giá trị đã biết bằng p nhân p cộng một rồi chia hai với p là số biến quan sát, và bậc tự do là số giá trị đã biết trừ số tham số tự do, theo cùng nguồn.
Ví dụ tự tính từ công thức đó cho dễ hình dung. Một mô hình có 10 biến quan sát thì có 10 nhân 11 chia 2, bằng 55 giá trị đã biết. Nếu giả sử bạn cần ước lượng 20 tham số tự do thì bậc tự do là 35, lớn hơn không, nên mô hình quá xác định và chi bình phương đọc được. Con số 20 này chỉ để minh hoạ.
Với PLS-SEM, Hair và cộng sự (2019) đưa một bộ tiêu chí khác cho mô hình đo lường phản xạ. Hệ số tải chỉ báo nên trên 0,708, vì khi đó khái niệm giải thích hơn một nửa phương sai của chỉ báo, và phần cấu trúc xem R² ở các mức 0,75, 0,50 và 0,25 là đáng kể, trung bình và yếu.
◆ Câu hỏi 7 / 8 · Mô hình SEM có chứng
Mô hình SEM có chứng minh quan hệ nhân quả không?
Trả lời thẳng: Mô hình SEM không tự chứng minh quan hệ nhân quả. Iacobucci (2009) khuyên không nên diễn giải hệ số đường dẫn như quan hệ nhân quả, và mức thận trọng này không khác gì khi kết quả đến từ hồi quy. Mũi tên trong mô hình thể hiện giả thuyết của người nghiên cứu, và chỉ khi có lập luận lý thuyết vững thì mới nên đọc nó là tác động.
Iacobucci (2009) nhấn mạnh mô hình SEM được dựng từ lý thuyết, nghĩa là hướng mũi tên do người nghiên cứu đặt ra trước rồi dữ liệu mới được dùng để kiểm tra. Hair và cộng sự (2021) cũng viết rằng mũi tên một chiều trong PLS-SEM là quan hệ dự báo, và chỉ với sự hỗ trợ lý thuyết vững mới có thể diễn giải thành nhân quả.
Trong phần thảo luận của luận văn, cách viết an toàn là nói rằng kết quả phù hợp với giả thuyết, hoặc rằng biến này dự báo biến kia, thay vì nói biến này làm cho biến kia thay đổi. Hội đồng có thể hỏi đúng chỗ này. Quy chế của từng trường và ý kiến của giảng viên hướng dẫn quyết định phần mềm cùng phương pháp nào được chấp nhận, nên bạn nên hỏi họ trước khi chốt nhánh ước lượng.
◆ Câu hỏi 8 / 8 · Sau khi chọn nhánh, làm
Sau khi chọn nhánh, làm gì với AMOS và SmartPLS?
Trả lời thẳng: Sau khi chọn nhánh, bạn chọn phần mềm tương ứng, thường là AMOS cho CB-SEM và SmartPLS cho PLS-SEM, rồi mới đi vào thao tác. Hair và cộng sự (2019) nêu AMOS và LISREL là phần mềm hay dùng cho CB-SEM, còn SmartPLS và PLS-Graph cho PLS-SEM. Ranh giới này đã mờ, vì SmartPLS GmbH (n.d.) cho biết SmartPLS nay có cả khả năng CB-SEM.
IBM (n.d.) giới thiệu IBM SPSS Amos là phần mềm SEM của IBM, mở rộng hồi quy và phân tích nhân tố để chạy phân tích đường dẫn và phân tích nhân tố khẳng định. Phần mềm này chỉ chạy trên Windows và có trong SPSS Statistics Premium hoặc được mua riêng. Cách đọc giao diện và các bước chạy được trình bày ở bài AMOS là gì, còn nhánh PLS-SEM nằm ở bài SmartPLS là gì.
Điều quan trọng hơn tên phần mềm là thứ tự việc phải làm. Bạn nên kiểm tra thang đo bằng Cronbach's alpha và EFA, xác nhận phần đo lường bằng CFA, rồi mới chạy phần cấu trúc. Nếu mô hình có biến trung gian hoặc biến điều tiết, hãy đọc thêm biến trung gian và biến điều tiết, và để phân biệt vai trò các biến ngay từ đầu, bài biến độc lập và biến phụ thuộc sẽ giúp bạn.
Câu hỏi thường gặp
Mô hình SEM khác hồi quy thường ở điểm nào?
Mô hình SEM khác hồi quy thường ở chỗ nó ước lượng cùng lúc nhiều quan hệ, cho phép một biến vừa là biến được giải thích vừa là biến giải thích, và tính đến sai số đo lường của các biến tiềm ẩn. UCLA Advanced Research Computing (n.d.) xếp hồi quy vào trường hợp đặc biệt của SEM, nên hồi quy là một phần của SEM chứ không đối lập với nó.
PLS-SEM là gì?
PLS-SEM là nhánh của mô hình SEM dựa trên bình phương nhỏ nhất từng phần, tính biến tổng hợp từ các chỉ báo rồi ước lượng quan hệ giữa chúng. Hair và cộng sự (2021) mô tả nhánh này theo hướng giải thích và dự báo biến phụ thuộc, và cho biết nó chưa có thước đo độ phù hợp toàn mô hình đã được thiết lập như CB-SEM.
CB-SEM và PLS-SEM khác nhau thế nào, chọn cái nào cho luận văn?
CB-SEM hợp khi bạn muốn xác nhận một lý thuyết có sẵn, còn PLS-SEM hợp khi bạn nhắm tới dự báo, có mô hình phức tạp hoặc thang đo hình thành. Hair và cộng sự (2021) khuyên coi hai nhánh là bổ trợ nhau và chọn nhánh khớp nhất với mục tiêu, đặc điểm dữ liệu và cấu trúc mô hình của mình.
Mô hình cấu trúc tuyến tính có phải là mô hình SEM không?
Mô hình cấu trúc tuyến tính là cách gọi tiếng Việt mà nhiều người dùng cho mô hình SEM, nên đây là cùng một phương pháp.
Có cần chạy EFA và CFA trước khi chạy SEM không?
Trước khi chạy SEM, bạn thường nên kiểm tra thang đo rồi mới chạy phần cấu trúc. Iacobucci (2009) khuyên xác nhận mô hình đo lường khớp tương đối tốt rồi mới xét các đường dẫn, và phần đo lường của SEM về bản chất là phân tích nhân tố khẳng định, nên CFA thường là bước ngay trước phần cấu trúc.
Nhờ MAAS hướng dẫn thì phần mô hình SEM trong luận văn được làm ra sao?
Bạn được ghép với một chuyên gia cùng lĩnh vực để cùng cân nhắc chọn mô hình và nhánh ước lượng. Chuyên gia chạy trên chính dữ liệu của bạn với từng bước được giải thích, rồi bàn giao tệp dữ liệu, sơ đồ mô hình, tệp dự án và bảng kết quả để bạn tự chạy lại và bảo vệ. Phần diễn giải kết quả trong luận văn do bạn viết, chuyên gia chỉ góp ý. Thời gian ghép thường trong 48 giờ, và nếu chưa có chuyên gia phù hợp thì MAAS phải tuyển thêm nên có thể kéo dài khoảng hai tuần. Cách làm nằm ở trang hỗ trợ xử lý số liệu luận văn, và bạn có thể đặt buổi tư vấn miễn phí 20 phút.
References
- Hair, J. F., Hult, G. T. M., Ringle, C. M., Sarstedt, M., Danks, N. P., & Ray, S. (2021). An introduction to structural equation modeling. In Partial least squares structural equation modeling (PLS-SEM) using R (chap. 1). Springer. https://doi.org/10.1007/978-3-030-80519-7_1
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2-24. https://doi.org/10.1108/EBR-11-2018-0203
- Hu, L.-t., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling, 6(1), 1-55. https://doi.org/10.1080/10705519909540118
- Iacobucci, D. (2009). Everything you always wanted to know about SEM (structural equations modeling) but were afraid to ask. Journal of Consumer Psychology, 19(4), 673-680. https://doi.org/10.1016/j.jcps.2009.09.002
- IBM. (n.d.). IBM SPSS Amos. Retrieved October 16, 2026, from https://www.ibm.com/products/structural-equation-modeling-sem
- SmartPLS GmbH. (n.d.). PLS-SEM compared with CB-SEM (and more). Retrieved October 16, 2026, from https://smartpls.com/documentation/choosing-pls-sem/pls-sem-compared-with-cbsem/
- UCLA Advanced Research Computing: Statistical Methods and Data Analytics. (n.d.). Introduction to structural equation modeling (SEM) in R with lavaan. Retrieved October 16, 2026, from https://stats.oarc.ucla.edu/r/seminars/rsem/
- Wolf, E. J., Harrington, K. M., Clark, S. L., & Miller, M. W. (2013). Sample size requirements for structural equation models: An evaluation of power, bias, and solution propriety. Educational and Psychological Measurement, 73(6), 913-934. https://doi.org/10.1177/0013164413495237
Chưa chắc hướng dẫn này áp vào trường hợp của mình ra sao? Trao đổi với MAAS trong buổi tư vấn miễn phí 20 phút.
Đặt lịch tư vấn miễn phí ▸