
◆ Phương pháp nghiên cứu
Phân tích nhân tố khẳng định CFA là gì và đọc kết quả ra sao?
Phân tích nhân tố khẳng định CFA kiểm tra xem các câu hỏi trong thang đo có đo đúng những khái niệm bạn đã đặt ra hay không, dựa trên dữ liệu của bạn.
Bài cũng chỉ ra cách nhận biết thang đo của bạn đã đủ tốt để đưa vào mô hình cấu trúc hay chưa, cách đọc các chỉ số trong kết quả CFA, và dấu hiệu cho thấy mình đang sửa mô hình chỉ để làm đẹp số.
◆ Câu hỏi 1 / 8 · Phân tích nhân tố khẳng
Phân tích nhân tố khẳng định CFA là gì, và khác EFA ở điểm nào?
Trả lời thẳng: CFA là phương pháp kiểm tra xem một cấu trúc nhân tố do bạn chỉ định trước từ lý thuyết có khớp với dữ liệu thu được hay không. Albright và Park (2009) mô tả CFA là phương pháp dẫn dắt bởi lý thuyết hoặc giả thuyết, có ràng buộc và có chỉ số độ phù hợp, còn EFA để dữ liệu quyết định cấu trúc và có xoay nhân tố.
Albright và Park (2009) cũng chỉ ra rằng CFA tương ứng với mô hình đo lường trong SEM, tức là phần mô hình cho biết mỗi khái niệm được đo bằng những câu hỏi nào. Vì vậy CFA thường là bước kiểm tra thang đo trước khi bạn đặt các khái niệm vào một mô hình cấu trúc, và bài mô hình SEM là gì nói tiếp về bước sau đó.
Trong CFA, thường mỗi câu hỏi được gán cho đúng một nhân tố và phần lớn hệ số tải chéo bị cố định bằng 0, nên mô hình có thể bị bác bỏ khi dữ liệu không ủng hộ. EFA không kiểm định một cấu trúc đã gán sẵn từng câu hỏi vào từng nhân tố theo cách đó. Bài phân tích nhân tố khám phá EFA đã giải thích vì sao chạy EFA rồi chạy CFA trên cùng một bộ dữ liệu chưa phải là xác nhận thật sự, nên bài này không nhắc lại chi tiết và chỉ nối tiếp từ chỗ đó.
◆ Câu hỏi 2 / 8 · Cần bao nhiêu mẫu để
Cần bao nhiêu mẫu để chạy CFA?
Trả lời thẳng: Cỡ mẫu cho CFA do hệ số tải và cấu trúc của mô hình quyết định, nên các quy tắc cố định như 10 ca cho mỗi biến không nên được dùng như một con số chắc chắn. Wolf và cộng sự (2013) chạy mô phỏng trên nhiều mô hình CFA và ghi nhận cỡ mẫu tối thiểu từ 30 đến 460 ca, tuỳ hệ số tải, số chỉ báo mỗi nhân tố và số nhân tố.
Wolf và cộng sự (2013) cho ví dụ cụ thể trong điều kiện mô phỏng của họ. Mô hình một nhân tố có bốn chỉ báo cần 190, 90 và 60 ca khi hệ số tải lần lượt là 0,50, 0,65 và 0,80. Mô hình hai nhân tố, mỗi nhân tố ba chỉ báo, cần 460, 200 và 120 ca với cùng ba mức hệ số tải. Như vậy hệ số tải yếu làm cỡ mẫu cần thiết tăng hơn gấp ba lần so với hệ số tải mạnh.
Hai kết quả ấy cho bạn một lời khuyên thực tế. Trước khi thu thập dữ liệu, hãy ước lượng trước thang đo của bạn có hệ số tải cao hay thấp, rồi so với các mức trên để biết cỡ mẫu mình đang nhắm tới có hợp lý không. Wolf và cộng sự (2013) cũng thấy số chỉ báo mỗi nhân tố nhiều hơn thì cỡ mẫu cần ít hơn, nên rút bớt câu hỏi để thang đo gọn hơn không phải lúc nào cũng có lợi cho độ ổn định của ước lượng.
◆ Câu hỏi 3 / 8 · Phân tích CFA trên AMOS
Phân tích CFA trên AMOS cần quyết định những gì?
Trả lời thẳng: Khi chạy phân tích CFA trên AMOS, bạn đưa ra bốn quyết định chính. Đó là câu hỏi nào thuộc nhân tố nào, các nhân tố có được phép tương quan với nhau không, mỗi biến tiềm ẩn được gán thang đo ra sao, và dùng phương pháp ước lượng nào. Schermelleh-Engel và cộng sự (2003) nêu ML là phương pháp thông dụng nhất.
Quyết định đầu tiên đến từ lý thuyết, không đến từ phần mềm. Albright và Park (2009) mô tả CFA là mô hình có ràng buộc, nên bạn phải biết trước mỗi câu hỏi đo khái niệm nào trước khi vẽ sơ đồ. Quyết định thứ ba thường được giải quyết bằng cách cố định một hệ số tải của mỗi nhân tố, vì biến tiềm ẩn không có thang đo sẵn.
Về ước lượng, Schermelleh-Engel và cộng sự (2003, tr. 26) cho biết ML giả định phân phối chuẩn nhiều chiều. Nếu phân phối lệch nặng thì ML vẫn nhất quán, nhưng kiểm định χ² sẽ không đáng tin. Vì vậy bạn nên kiểm tra phân phối của dữ liệu trước khi báo cáo χ². Cách thao tác từng bước trong phần mềm được trình bày ở bài AMOS là gì, còn nếu thầy cô yêu cầu hướng PLS thì thang đo được đánh giá theo cách khác, xem bài SmartPLS là gì.
Những quyết định này không phụ thuộc vào phần mềm bạn chọn, nhưng nếu hướng dẫn luận văn của khoa nêu ngưỡng hay cách trình bày riêng thì hãy theo hướng dẫn đó và ghi rõ nguồn.
◆ Câu hỏi 4 / 8 · Đọc chỉ số độ phù
Đọc chỉ số độ phù hợp mô hình thế nào, ngưỡng nào là đạt?
Trả lời thẳng: Chỉ số độ phù hợp mô hình là nhóm số cho biết mô hình CFA khớp dữ liệu đến đâu, và ngưỡng của chúng là quy ước. Hu và Bentler (1999) đề xuất gần 0,95 cho CFI và TLI, gần 0,06 cho RMSEA và gần 0,08 cho SRMR, còn Schermelleh-Engel và cộng sự (2003) đưa ra hai mức là tốt và chấp nhận được, trong đó chỉ mức tốt khắt khe hơn Hu và Bentler (1999).
| Chỉ số | Hu và Bentler (1999) | Schermelleh-Engel và cộng sự (2003): tốt | Schermelleh-Engel và cộng sự (2003): chấp nhận được |
|---|---|---|---|
| χ²/df | không đưa ra | 0 đến 2 | 2 đến 3 |
| RMSEA | gần 0,06 | không quá 0,05 | 0,05 đến 0,08 |
| SRMR | gần 0,08 | không quá 0,05 | 0,05 đến 0,10 |
| CFI | gần 0,95 | 0,97 đến 1,00 | 0,95 đến dưới 0,97 |
| TLI (NNFI) | gần 0,95 | từ 0,97 | từ 0,95 |
| GFI | không đưa ra | từ 0,95 | từ 0,90 |
Ngưỡng của hai nguồn khác nhau ở cùng một chỉ số. Nguồn: Hu và Bentler (1999), Schermelleh-Engel và cộng sự (2003, bảng 1).
Bảng trên cho thấy cùng một mô hình có thể đạt theo bộ ngưỡng này nhưng chỉ chấp nhận được theo bộ ngưỡng kia. Schermelleh-Engel và cộng sự (2003, tr. 24) viết rằng "as there does not exist a consensus about what constitutes a "good fit"", các chỉ số nên được xem xét đồng thời. Vì vậy hãy chọn một bộ ngưỡng, nêu nguồn trong phần phương pháp, rồi báo cáo cả χ², χ²/df, RMSEA, SRMR và CFI thay vì chỉ chọn những số đẹp.
Hu và Bentler (1999) còn khuyến nghị báo cáo SRMR cùng ít nhất một chỉ số bổ sung. Họ cũng chỉ ra rằng TLI và RMSEA có xu hướng loại oan mô hình đúng khi mẫu nhỏ, nên một mô hình trượt ngưỡng ở mẫu nhỏ chưa chắc là mô hình sai. Schermelleh-Engel và cộng sự (2003, tr. 51) lưu ý GFI và AGFI phụ thuộc cỡ mẫu và có xu hướng đánh giá thấp độ khớp của mô hình phức tạp, nên GFI chỉ nên là chỉ số phụ.
◆ Câu hỏi 5 / 8 · Hệ số tải, CR
Hệ số tải, CR và AVE bao nhiêu thì thang đo đạt?
Trả lời thẳng: Độ tin cậy tổng hợp CR và phương sai trích trung bình AVE là hai số được tính từ hệ số tải chuẩn hoá của CFA. Cheung và cộng sự (2024) nêu tiêu chí giá trị hội tụ gồm CR từ 0,7, mọi hệ số tải chuẩn hoá từ 0,5 và AVE từ 0,5, nên hệ số tải đạt 0,5 ở mọi chỉ báo vẫn chưa đủ để AVE đạt.
Ba ví dụ giả định tính CR và AVE từ hệ số tải chuẩn hoá
Mỗi hàng đặt một bộ hệ số tải cạnh CR, AVE và kết luận theo ngưỡng 0,7 và 0,5.
Hệ số tải chuẩn hoá
CR, AVE và kết luận
0,70 / 0,70 / 0,70
CR 0,742, AVE 0,490: CR đạt, AVE chưa đạt
0,50 / 0,50 / 0,50 / 0,50
CR 0,571, AVE 0,250: cả hai chưa đạt
0,80 / 0,75 / 0,70 / 0,65
CR 0,817, AVE 0,529: cả hai đạt
Lưu hình này
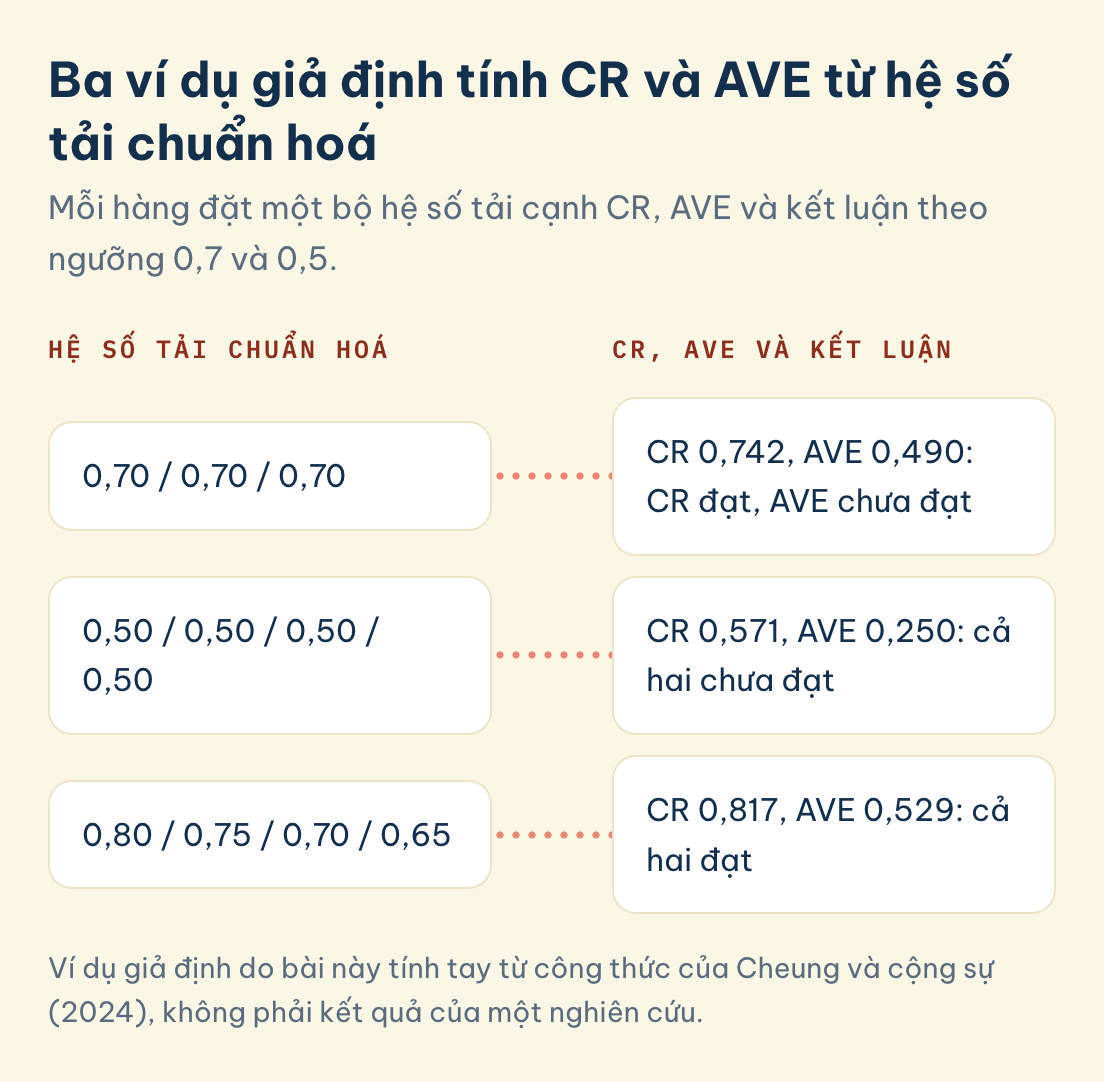
Cheung và cộng sự (2024) định nghĩa CR bằng bình phương tổng các hệ số tải chuẩn hoá, chia cho tổng đó cộng với tổng phần sai số (1 trừ bình phương từng hệ số tải). AVE là trung bình bình phương các hệ số tải chuẩn hoá. Cùng nguồn này nhắc rằng ngưỡng AVE 0,5 là quy tắc ngón tay cái chứ không phải một kiểm định thống kê, vì nó bỏ qua sai số do lấy mẫu.
Để thấy hai công thức hoạt động ra sao, bảng dưới là ba ví dụ giả định do chúng tôi tính tay từ công thức của Cheung và cộng sự (2024). Đây không phải kết quả của một nghiên cứu nào.
| Hệ số tải chuẩn hoá của các chỉ báo | CR | AVE | Kết luận theo ngưỡng 0,7 và 0,5 |
|---|---|---|---|
| 0,70 / 0,70 / 0,70 | 0,742 | 0,490 | CR đạt, AVE chưa đạt |
| 0,50 / 0,50 / 0,50 / 0,50 | 0,571 | 0,250 | cả hai chưa đạt |
| 0,80 / 0,75 / 0,70 / 0,65 | 0,817 | 0,529 | cả hai đạt |
Ví dụ giả định, tính tay từ công thức CR và AVE. Nguồn công thức và ngưỡng: Cheung và cộng sự (2024).
Dòng thứ hai là điều nhiều bạn dễ bỏ sót. Bốn chỉ báo cùng đạt hệ số tải 0,5, tức vừa chạm mức tối thiểu, nhưng AVE chỉ còn 0,25. Dòng đầu cho thấy ba hệ số tải cùng 0,7 vẫn làm AVE hụt ngưỡng 0,49 so với 0,5, dù CR đã qua. Nếu thang đo của bạn rơi vào tình huống này, đừng vội bỏ ngưỡng, mà hãy xem câu hỏi nào có hệ số tải thấp nhất và nội dung của nó có thật sự đo khái niệm hay không. CR cũng khác Cronbach's alpha ở chỗ nó dùng hệ số tải của từng câu thay vì giả định mọi câu đóng góp như nhau, và bài kiểm định Cronbach's alpha trình bày bước kiểm tra độ tin cậy trước khi chạy CFA.
◆ Câu hỏi 6 / 8 · Kiểm tra giá trị phân
Kiểm tra giá trị phân biệt bằng Fornell-Larcker hay HTMT?
Trả lời thẳng: Giá trị phân biệt cho biết hai khái niệm trong mô hình có thật sự khác nhau hay không. Rönkkö và Cho (2022) chỉ ra tiêu chí so AVE với bình phương tương quan nhân tố có tỉ lệ dương tính giả cao, còn Henseler và cộng sự (2015) đề xuất tỉ số HTMT với ngưỡng 0,85 hoặc 0,90.
Tiêu chí Fornell-Larcker yêu cầu AVE của cả hai nhân tố đều lớn hơn bình phương tương quan giữa chúng. Rönkkö và Cho (2022) nhắc hai lỗi hay gặp. Lỗi thứ nhất là dùng tương quan giữa điểm thang đo, trong khi phép so đúng phải dùng tương quan nhân tố lấy từ CFA. Lỗi thứ hai là đem AVE so với mốc 0,5, vì mốc đó chỉ dành cho giá trị hội tụ. Rönkkö và Cho (2022) còn khuyến nghị kiểm tra khoảng tin cậy của tương quan nhân tố từ CFA so với một ngưỡng đã chọn, thay vì dựa vào tiêu chí Fornell-Larcker.
Henseler và cộng sự (2015) xây dựng HTMT cho các mô hình dựa trên phương sai như PLS, và cho thấy ở loại mô hình đó tiêu chí Fornell-Larcker cùng hệ số tải chéo không phát hiện đáng tin việc thiếu giá trị phân biệt. Không ngưỡng HTMT nào trong số các ngưỡng được xét báo vấn đề về giá trị phân biệt khi tương quan giữa các khái niệm từ 0,70 trở xuống. Nếu bạn dùng CFA, có thể báo cáo thêm HTMT như một kiểm tra bổ sung, còn đánh giá giá trị phân biệt trong PLS được bàn riêng ở bài SmartPLS là gì.
Cheung và cộng sự (2024) tổng hợp một hướng dẫn dễ nhớ về tương quan giữa hai nhân tố. Tương quan không cao hơn 0,7 thường không đáng lo, còn tương quan trên 0,8 hoặc 0,85 là lý do để xem lại xem hai khái niệm có đang đo cùng một thứ. Cùng nguồn này coi giá trị phân biệt là mức độ khác biệt, không phải kết luận có hoặc không.
◆ Câu hỏi 7 / 8 · Mô hình không khớp
Mô hình không khớp thì sửa thế nào mà không làm đẹp số?
Trả lời thẳng: Khi mô hình CFA không khớp, hãy kiểm tra hệ số tải thấp, biến tải chéo và cơ sở lý thuyết trước khi nghĩ tới modification indices. MacCallum, Roznowski và Necowitz (1992) cảnh báo sửa mô hình theo dữ liệu dễ chạy theo đặc điểm ngẫu nhiên của mẫu, và các sửa đổi có thể rất không nhất quán giữa các mẫu.
Theo MacCallum, Roznowski và Necowitz (1992), việc sửa mô hình theo dữ liệu "is inherently susceptible to capitalization on chance characteristics of the data". Họ khuyên nên xác định trước nhiều mô hình lý thuyết thay thế để so sánh, thay vì sửa dần một mô hình cho tới khi chỉ số đẹp.
Trong thực hành, nghĩa là mỗi lần bạn thêm một đường tương quan sai số hoặc loại một câu hỏi, hãy ghi lại lý do về nội dung chứ không chỉ ghi rằng chỉ số tăng. Một câu hỏi bị loại nên là câu có hệ số tải thấp và có lý do để nghi ngờ nội dung của nó. Loại câu hỏi để đạt ngưỡng rồi không giải thích được thì khó bảo vệ trước người chấm. Nếu bạn đã loại nhiều câu mà mô hình vẫn không khớp, có thể cấu trúc lý thuyết ban đầu cần xem lại, và đó là kết quả đáng được báo cáo thẳng.
◆ Câu hỏi 8 / 8 · Viết kết quả CFA vào
Viết kết quả CFA vào luận văn thế nào?
Trả lời thẳng: Phần kết quả CFA trong luận văn nên có ba thành phần. Đó là bảng chỉ số độ phù hợp kèm ngưỡng và nguồn, bảng hệ số tải chuẩn hoá cùng CR và AVE của từng nhân tố, và bảng giá trị phân biệt. Mọi con số báo cáo cần khớp với ngưỡng bạn đã chọn từ trước, nếu không người đọc sẽ nghi ngờ ngưỡng được chọn sau khi nhìn kết quả.
Bảng thứ nhất nên liệt kê χ², bậc tự do, χ²/df, RMSEA, SRMR, CFI và TLI, mỗi chỉ số kèm ngưỡng và nguồn của ngưỡng, ví dụ Hu và Bentler (1999) hoặc Schermelleh-Engel và cộng sự (2003). Bảng thứ hai nên nêu mỗi câu hỏi với hệ số tải chuẩn hoá, rồi CR và AVE của nhân tố đó. Bảng thứ ba là ma trận tương quan nhân tố hoặc HTMT, đi kèm một câu nêu bạn dùng tiêu chí nào.
Sau các bảng, đoạn diễn giải nên nói thang đo nào đạt, thang đo nào cần thận trọng và vì sao, bằng lời của chính bạn. Đoạn đó là phần hội đồng hay hỏi nhất, và chỉ bạn mới giải thích được vì sao mình giữ hay loại một câu hỏi. Khi mọi nhân tố đã đạt, bước kế tiếp là mô hình cấu trúc, được trình bày ở bài mô hình SEM là gì.
Câu hỏi thường gặp
CFA là gì và dùng để làm gì?
CFA là phân tích nhân tố khẳng định, dùng để thử một giả thuyết về việc các câu hỏi gộp thành những khái niệm nào. Albright và Park (2009) lưu ý CFA có ràng buộc và có chỉ số đánh giá độ khớp, nên CFA thường là bước kiểm tra thang đo trước khi đưa vào mô hình cấu trúc.
CFA khác EFA thế nào, có bắt buộc phải chạy EFA trước không?
EFA để dữ liệu gợi ý cấu trúc nhân tố, còn CFA kiểm tra một cấu trúc đã được chỉ định trước. Nếu thang đo của bạn còn mới thì thường khám phá bằng EFA trước, rồi xác nhận bằng CFA trên một mẫu độc lập, như bài phân tích nhân tố khám phá EFA đã giải thích. Chạy cả hai trên cùng một bộ dữ liệu chưa phải là xác nhận thật sự.
CFA cần cỡ mẫu bao nhiêu?
Cỡ mẫu CFA tuỳ thuộc vào độ mạnh của hệ số tải và cấu trúc của mô hình. Trong mô phỏng của Wolf và cộng sự (2013), mức tối thiểu trải rộng từ 30 đến 460 ca, chẳng hạn mô hình một nhân tố bốn chỉ báo cần 190 ca khi hệ số tải là 0,50 và 60 ca khi hệ số tải là 0,80.
CFI và RMSEA bao nhiêu thì chấp nhận được?
Hu và Bentler (1999) đề xuất CFI gần 0,95 và RMSEA gần 0,06, còn Schermelleh-Engel và cộng sự (2003) coi CFI từ 0,95 và RMSEA không quá 0,08 là chấp nhận được. Hai bộ ngưỡng khác nhau, nên bạn cần chọn một bộ và nêu rõ nguồn trong luận văn.
Phân tích CFA khác gì với mô hình SEM đầy đủ?
CFA tương ứng với mô hình đo lường của SEM theo Albright và Park (2009), tức chỉ kiểm tra các câu hỏi đo khái niệm có tốt không. Mô hình SEM đầy đủ thêm phần mô hình cấu trúc, kiểm tra mối quan hệ giữa các khái niệm, và bạn có thể đọc tiếp ở bài mô hình SEM là gì.
MAAS đồng hành được gì ở phần kiểm định thang đo bằng CFA?
Phần kiểm định thang đo của khoá luận, luận văn hay luận án là chỗ chuyên gia đúng chuyên ngành của MAAS có thể đồng hành. Chuyên gia cùng bạn chọn cách phân tích rồi chạy trên dữ liệu bạn đã có, giải thích từng bước, và bàn giao tệp dữ liệu cùng bảng kết quả để bạn tự mở lại và giải thích được. Phần diễn giải trong luận văn vẫn do bạn viết, chuyên gia chỉ góp ý, và MAAS không làm trọn phần số liệu thay bạn. Bạn có thể xem dịch vụ hỗ trợ xử lý số liệu luận văn, hoặc gọi +84 979 422 393 để hẹn buổi tư vấn miễn phí 20 phút trước khi gửi dữ liệu.
References
- Albright, J. J., & Park, H. M. (2009). Confirmatory factor analysis using Amos, LISREL, Mplus, SAS/STAT CALIS. Indiana University. https://hdl.handle.net/2022/19736
- Cheung, G. W., Cooper-Thomas, H. D., Lau, R. S., & Wang, L. C. (2024). Reporting reliability, convergent and discriminant validity with structural equation modeling: A review and best-practice recommendations. Asia Pacific Journal of Management, 41(2), 745-783. https://doi.org/10.1007/s10490-023-09871-y
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43(1), 115-135. https://doi.org/10.1007/s11747-014-0403-8
- Hu, L.-t., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling, 6(1), 1-55. https://doi.org/10.1080/10705519909540118
- MacCallum, R. C., Roznowski, M., & Necowitz, L. B. (1992). Model modifications in covariance structure analysis: The problem of capitalization on chance. Psychological Bulletin, 111(3), 490-504. https://doi.org/10.1037/0033-2909.111.3.490
- Rönkkö, M., & Cho, E. (2022). An updated guideline for assessing discriminant validity. Organizational Research Methods, 25(1), 6-14. https://doi.org/10.1177/1094428120968614
- Schermelleh-Engel, K., Moosbrugger, H., & Müller, H. (2003). Evaluating the fit of structural equation models: Tests of significance and descriptive goodness-of-fit measures. Methods of Psychological Research Online, 8(2), 23-74. https://www.stats.ox.ac.uk/~snijders/mpr_Schermelleh.pdf
- Wolf, E. J., Harrington, K. M., Clark, S. L., & Miller, M. W. (2013). Sample size requirements for structural equation models: An evaluation of power, bias, and solution propriety. Educational and Psychological Measurement, 73(6), 913-934. https://doi.org/10.1177/0013164413495237
Chưa chắc hướng dẫn này áp vào trường hợp của mình ra sao? Trao đổi với MAAS trong buổi tư vấn miễn phí 20 phút.
Đặt lịch tư vấn miễn phí ▸