
Cơ sở dữ liệu chạy được mà vẫn mất điểm vì COMM2822 không chấm xem bài của bạn có hoạt động hay không, mà chấm xem các quyết định thiết kế phía sau có bảo vệ được trước bản mô tả nghiệp vụ hay không, và câu truy vấn có trả lời đúng câu hỏi đề bài đặt ra hay không. Bài viết này giúp bạn biết điểm thật sự nằm ở đâu, cách viết phần giả định, cách giải thích chuẩn hoá và cách giữ cho câu SQL không trả lời nhầm câu hỏi.
COMM2822 Introduction to Databases for Business Analytics ở UNSW là một trong số ít môn kinh doanh mà bài làm hoặc chạy được hoặc không, và chính sự rành mạch đó dễ đánh lừa người học. Lược đồ (schema) nạp lên trơn tru, câu truy vấn trả về dữ liệu, không có gì hỏng, vậy mà điểm vẫn dừng ở khoảng giữa. Moody và Shanks (2003) giải thích khoảng cách này bằng cách tách tính đúng kỹ thuật khỏi chất lượng của một mô hình dữ liệu, và phần còn lại của bài đi theo đúng lằn ranh đó.
Tác giả: Ban Biên tập MAAS
Cập nhật lần cuối: 17/08/2026
Chuyên mục: communication-pr
COMM2822 là môn gì và nằm ở đâu trong chương trình?
Trả lời trực tiếp: COMM2822 Introduction to Databases for Business Analytics là môn 6 tín chỉ của UNSW Business School, do School of Information Systems and Technology Management giảng dạy. Môn bàn về cơ sở dữ liệu doanh nghiệp, các đặc trưng của dữ liệu lớn (Big Data) và SQL, với mô hình thực thể liên kết và chuẩn hoá là hai phương pháp cốt lõi. Đây là môn nền cho nhánh phân tích dữ liệu trong chương trình kinh doanh.
Bằng chứng: Môn có năm chuẩn đầu ra (learning outcomes) được công bố, và ba chuẩn đầu đi theo một trình tự có chủ đích. Chuẩn thứ nhất là tạo lập và vận dụng phương pháp mô hình hoá ở mức khái niệm lẫn mức quan hệ, chuẩn thứ hai là thiết kế, triển khai và đánh giá hệ cơ sở dữ liệu, còn chuẩn thứ ba là truy xuất và thao tác dữ liệu trong một cơ sở dữ liệu quan hệ bằng SQL. Động từ ở chuẩn thứ hai là chỗ người học hay lướt qua. Đánh giá không đồng nghĩa với xây dựng, và một môn yêu cầu bạn đánh giá chính thiết kế của mình đang báo trước rằng phần lập luận có điểm. Hai chuẩn còn lại nói về làm việc nhóm hiệu quả và về các hệ quả đạo đức, quyền riêng tư cùng an ninh của dữ liệu lớn, và cả hai đều dễ bị quên chính vì chúng nằm cuối danh sách.
Ví dụ: Một sinh viên người Việt học năm hai ở UNSW tìm tới MAAS vì bài của bạn ấy bị chấm thấp hơn bài của một người cùng lớp, trong khi hai cơ sở dữ liệu có đúng các bảng như nhau. Khi đặt hai bài cạnh nhau, mentor tìm ra khác biệt chỉ trong khoảng nửa trang. Người kia có một đoạn ngắn giải thích vì sao một mối quan hệ được mô hình hoá thành nhiều-nhiều (many-to-many), còn bạn ấy chỉ vẽ nó ra. Cấu trúc hai bài giống hệt nhau, nhưng chỉ một bài có lập luận.
Điểm của một bài cơ sở dữ liệu thực ra nằm ở đâu?
Trả lời trực tiếp: Với một môn thiết kế theo kiểu này, điểm dồn vào ba chỗ, và không chỗ nào là chuyện bài có chạy hay không. Đó là độ trung thành của mô hình với tình huống nghiệp vụ, lập luận cho những giả định bạn buộc phải đưa ra, và việc câu SQL trả lời đúng câu hỏi. Moody và Shanks (2003) tách tính đúng khỏi chất lượng của mô hình, nên đúng kỹ thuật chỉ là vé vào cửa.
| Sinh viên nghĩ được chấm cái gì | Thường thực tế chấm cái gì | Lỗ hổng lộ ra ở đâu |
|---|---|---|
| Sơ đồ vẽ đúng quy tắc | Sơ đồ khớp với nghiệp vụ được mô tả | Có thực thể tự nghĩ ra mà đề bài không hề nhắc |
| Các bảng đã chuẩn hoá | Nói được chuẩn hoá đã sửa cái gì | Khẳng định đạt 3NF mà không chứng minh |
| Câu truy vấn trả về dữ liệu | Câu truy vấn trả lời đúng câu hỏi được nêu | Kết quả đúng nhưng câu hỏi sai |
| Thiết kế chạy được | Thiết kế đứng vững trước các phương án khác | Không có mục giả định nào cả |
Bằng chứng: Moody và Shanks (2003), trong một nghiên cứu thực nghiệm về chất lượng mô hình dữ liệu, tách bạch tính đúng với chất lượng và lập luận rằng một mô hình phải được đánh giá theo nhiều chiều như tính đầy đủ, tính toàn vẹn và mức dễ hiểu, chứ không đối chiếu với một đáp án duy nhất. Một bảng tiêu chí chấm (rubric) cho bài cơ sở dữ liệu áp dụng đúng logic đó. Một mô hình nhất quán bên trong vẫn có thể là bản mô tả tồi cho chính doanh nghiệp mà nó lẽ ra phải mô tả.
Ví dụ: Một sinh viên mô hình hoá tình huống một cửa hàng bán lẻ nhỏ và dựng ra một lược đồ mười một bảng, chuẩn hoá rất đẹp. Mentor chỉ hỏi bạn ấy một câu, là câu nào trong đề bài đã khiến bạn ấy tạo bảng liên hệ nhà cung cấp. Bạn ấy tìm mãi không ra. Sinh viên đó đã mô hình hoá doanh nghiệp trong tưởng tượng của mình thay vì doanh nghiệp mà đề bài đưa ra, và mỗi bảng thừa là một chỗ để mất điểm chứ không phải để kiếm điểm.
Vì sao phần giả định lại nặng ký tới vậy?
Trả lời trực tiếp: Mọi tình huống nghiệp vụ giao cho sinh viên đều cố ý thiếu thông tin, và môn học rèn bạn nhận ra chỗ mơ hồ thay vì lấp liếm nó. Khi đề không nói rõ, bạn phải chọn, và điểm đến từ việc nêu lựa chọn cùng hệ quả của nó. Chen (1976) dựng ký pháp thực thể liên kết để thiết kế được đem ra bàn bạc.
Bằng chứng: Chen (1976) giới thiệu cách tiếp cận thực thể liên kết như một cách biểu diễn góc nhìn về thế giới thực ở dạng có thể đem ra bàn bạc và thống nhất trước khi triển khai, trên tiền đề mà ông viết thành lời: "the entity-relationship model adopts the more natural view that the real world consists of entities and relationships" (Chen, 1976, p. 9), tức mô hình này nhìn thế giới thực một cách tự nhiên hơn, như một tập hợp các thực thể và mối quan hệ. Chữ bàn bạc ở đây quan trọng. Ký pháp tồn tại để một người không ở trong đầu bạn vẫn chất vấn được thiết kế, và đó chính là việc người chấm đang làm. Khi đề bài không nói một khách hàng có được giữ nhiều tài khoản hay không, một giả định không nói ra sẽ bị đọc là sơ sót, còn một giả định được nói ra sẽ được đọc là phán đoán.
Bài báo năm 1976 của Chen tự nó là một phản ứng trước hai mô hình thống trị cơ sở dữ liệu thương mại trước đó. Mô hình thứ nhất là mô hình phân cấp đứng sau Information Management System của IBM, ra mắt lần đầu năm 1968, còn mô hình thứ hai là mô hình mạng do CODASYL chuẩn hoá năm 1969. Cả hai đều ép một đường truy cập cố định vào dữ liệu. Mô hình quan hệ của Codd, cùng cách vẽ sơ đồ của Chen đặt lên trên nó, cho phép người mô hình hoá mô tả doanh nghiệp trước và để đường truy cập lại cho câu truy vấn, và đó là toàn bộ lý do COMM2822 có thể yêu cầu bạn bảo vệ một thiết kế trước khi viết dòng SQL nào. Ký pháp của Chen cũng ra đời trước sơ đồ lớp (class diagram), loại sơ đồ nay là chuẩn trong kỹ nghệ phần mềm và được Object Management Group đưa vào UML năm 1997. Nếu tutor phác một thiết kế bằng những ô và đường nối trông hơi khác với giáo trình của bạn, đó thường là một biến thể UML của cùng ý tưởng nền, chứ không phải một phương pháp cạnh tranh.
Ví dụ: Hai sinh viên trong cùng một lớp tutorial xử lý cùng một chỗ mơ hồ theo hai hướng ngược nhau. Một bạn cho phép một lượt đặt phòng tham chiếu tới nhiều phòng, bạn kia thì không. Cả hai đều được điểm tốt, vì cả hai đều viết một câu nói rõ chi tiết nào trong đề bài đẩy mình theo hướng đó, và điều gì sẽ phải thay đổi nếu giả định hoá ra sai. Một sinh viên thứ ba chọn giống bạn đầu tiên nhưng không viết gì, và mất đúng phần điểm mà hai bạn kia giữ được.
Chuẩn hoá thực chất đang kiểm tra điều gì?
Trả lời trực tiếp: Chuẩn hoá kiểm tra xem bạn có gọi tên được vấn đề mà một thay đổi thiết kế giải quyết hay không. Dạng chuẩn thứ ba (3NF) không phải thứ trang trí gắn vào lúc cuối, mà là chuỗi quyết định loại bỏ những bất thường khi cập nhật, thêm và xoá dữ liệu. Nói được phép tách bảng nào loại bất thường nào mới là hiểu.
Bằng chứng: Codd (1970) đề xuất mô hình quan hệ để người dùng không phải biết dữ liệu được tổ chức vật lý ra sao, và để cấu trúc logic giữ được ổn định khi dữ liệu thay đổi. Các dạng chuẩn sau đó được trình bày như những quy tắc thực hành nhằm loại bỏ dư thừa cùng các bất thường mà dư thừa gây ra. Kent (1983), trong bản diễn giải kinh điển bằng lời thường, nhấn mạnh rằng mỗi dạng chuẩn xử lý một loại rắc rối riêng chứ không phải một dấu hiệu chất lượng chung chung. Một thiết kế có thể chuẩn hoá đầy đủ mà vẫn sai với doanh nghiệp, và vì vậy phần lập luận nặng ký hơn cái nhãn.
Dạng chuẩn thứ ba cũng chưa phải lựa chọn chặt nhất. Năm 1974, Boyce và Codd đưa ra một dạng chuẩn chặt hơn, nay được dạy với tên Boyce-Codd Normal Form (BCNF), để bịt những trường hợp bất thường mà 3NF còn bỏ ngỏ khi một bảng có nhiều hơn một khoá ứng viên (candidate key). Phần lớn bài COMM2822 không cần đi xa tới đó, nhưng khi người chấm thấy bạn gọi tên lựa chọn này và giải thích vì sao mình dừng ở 3NF, họ đang đọc một lập luận mạnh hơn hẳn so với một bài khẳng định 3NF như thể đó là mức trần.
Ví dụ: Một sinh viên viết trong báo cáo rằng các bảng của mình đạt 3NF vì đã loại bỏ phụ thuộc bắc cầu (transitive dependency). Mentor đề nghị bạn ấy chỉ ra một phụ thuộc cụ thể. Lần lại, bạn ấy phát hiện rằng việc lưu mã bưu chính của chi nhánh cạnh tên chi nhánh trong bảng giao dịch có nghĩa là mỗi lần chi nhánh chuyển địa điểm sẽ phải cập nhật hàng trăm dòng, rồi viết đúng câu đó vào báo cáo. Phần kỹ thuật không đổi chút nào, nhưng câu văn ấy mang lại phần điểm mà cái nhãn 3NF không mang lại.
Những kiểu hỏng mô hình hoá này lặp lại ở các môn cơ sở dữ liệu của trường khác, và bài hướng dẫn INFO20003 Database Systems của Melbourne trình bày kỹ các nghiên cứu đã công bố về lỗi mô hình thực thể liên kết của người mới học.
Các dạng chuẩn và ký pháp bạn sẽ gặp trong môn này là gì?
Trả lời trực tiếp: Đề bài và slide thường nhắc các dạng chuẩn bằng tên viết tắt mà không giải thích lại, nên bạn nên nắm trước nghĩa của từng dạng. Theo cách Kent (1983) mô tả, mỗi dạng xử lý một loại dư thừa riêng, còn BCNF của Boyce và Codd siết chặt hơn 3NF khi có nhiều khoá ứng viên. Về sơ đồ, bạn sẽ gặp ký pháp gốc của Chen và ký pháp Crow's Foot.
Dạng chuẩn thứ nhất (1NF) đòi mỗi ô chỉ chứa một giá trị đơn. Dạng chuẩn thứ hai (2NF) loại bỏ phụ thuộc từng phần, tức trường hợp một cột chỉ phụ thuộc vào một phần của khoá chính gồm nhiều cột. Dạng chuẩn thứ ba (3NF) loại bỏ phụ thuộc bắc cầu giữa các cột không phải khoá. Kent (1983) mô tả riêng từng dạng này, mỗi dạng gắn với một loại rắc rối cụ thể. BCNF siết chặt hơn 3NF cho những trường hợp có nhiều khoá ứng viên chồng lấn nhau.
Về ký pháp vẽ sơ đồ, hai kiểu phổ biến nhất là ký pháp gốc của Chen (1976), dùng hình thoi cho mối quan hệ, và ký pháp Crow's Foot, dùng ký hiệu ba nhánh như chân chim để biểu diễn lực lượng (cardinality) của mối quan hệ. Ký pháp Crow's Foot quen thuộc hơn với phần lớn công cụ vẽ sơ đồ hiện nay, nên bạn nên xem course outline để biết môn yêu cầu kiểu nào.
Làm sao để SQL không trả lời nhầm câu hỏi?
Trả lời trực tiếp: Bạn viết câu hỏi bằng lời thường phía trên mỗi câu truy vấn trước khi viết truy vấn, rồi đọc kết quả đối chiếu ngược với câu đó. Phần lớn câu SQL làm mất điểm đều đúng cú pháp nhưng sai suy luận, và lỗi suy luận không lộ ra khi chạy thử vì truy vấn vẫn trả kết quả bình thường. Elmasri và Navathe (2016) dành hẳn nhiều trang cho khác biệt về nghĩa giữa các kiểu join.
Bằng chứng: Connolly và Begg (2015), cùng Elmasri và Navathe (2016), coi khâu đặt câu truy vấn là một hoạt động mô hình hoá đúng nghĩa chứ không phải một bài dịch, và dành nhiều dung lượng cho khác biệt ngữ nghĩa giữa các loại phép nối (join) cũng như cho vị trí đặt điều kiện lọc trong trình tự tính toán. Những chương đó tồn tại chính vì lỗi ở đây thuộc về khái niệm chứ không thuộc về cú pháp. Cụ thể, một câu truy vấn hỏng khi phép nối âm thầm loại bỏ những dòng không có bản ghi khớp, khi một hàm gộp (aggregate) được tính trên một tập đã lọc nên không còn đại diện cho tổng thể mà đề hỏi, hoặc khi một điều kiện được đặt sau bước gom nhóm trong khi lẽ ra phải đặt trước.
Lịch sử chuẩn hoá của chính SQL là lý do cú pháp bạn học ở môn này dùng được ở nơi khác. Oracle ra mắt hệ thương mại đầu tiên dựng trên mô hình của Codd vào năm 1979, ANSI chấp nhận SQL làm chuẩn quốc gia năm 1986, và ISO chấp nhận chuẩn tương đương vào năm sau đó. Vì thế một câu lệnh SELECT chạy theo cùng một cách, dù bạn chạy nó trên hệ quản trị của môn học, trên PostgreSQL hay trên SQL Server cài ở máy mình. Logic nối và lọc là chuẩn chung, còn những lỗi mô tả ở trên đến từ cách suy luận về nghiệp vụ chứ không đến từ biến thể của ngôn ngữ.
Ví dụ: Một bài nhóm yêu cầu tính giá trị đơn hàng trung bình trên mỗi khách hàng, và câu truy vấn trả về một con số nghe rất hợp lý. Mentor hỏi những khách đã đăng ký mà chưa từng đặt đơn nào thì đi đâu, và cả nhóm lặng đi. Phép nối trong (inner join) đã loại những khách đó ra, nên con số mô tả khách đang hoạt động chứ không phải toàn bộ khách hàng. Chỉ một từ trong câu lệnh thay đổi, nhưng phần diễn giải trong báo cáo đổi hoàn toàn, và khuyến nghị dựng trên phần diễn giải ấy cũng đổi theo.
Những cặp từ khoá SQL nào hay bị dùng sai nghĩa?
Trả lời trực tiếp: Hai cặp hay bị lẫn nhất là INNER JOIN với LEFT JOIN, và WHERE với HAVING. Cặp thứ nhất quyết định dòng nào còn lại sau phép nối, đúng loại lỗi làm bài tính đơn hàng trung bình ở trên bỏ sót khách. Cặp thứ hai quyết định điều kiện lọc chạy trước hay sau bước gom nhóm, và đặt sai thường không báo lỗi mà chỉ âm thầm đổi con số.
INNER JOIN chỉ giữ những dòng có bản ghi khớp ở cả hai bảng, còn LEFT JOIN giữ toàn bộ dòng của bảng bên trái kể cả khi bảng bên phải không có bản ghi khớp. Đó chính là khác biệt khiến bài tính đơn hàng trung bình ở ví dụ trên bỏ sót những khách chưa từng đặt đơn. WHERE lọc dòng trước khi gom nhóm bằng GROUP BY, còn HAVING lọc sau khi các hàm gộp như COUNT, SUM, AVG hay MAX đã tính xong. Một truy vấn con lồng trong mệnh đề FROM và một Common Table Expression (CTE) viết bằng WITH thường cho cùng kết quả, nhưng CTE dễ đọc lại hơn khi bạn phải giải thích từng bước cho người chấm.
Vài mệnh đề khác cũng hay bị hiểu sai nghĩa. LIMIT chỉ cắt bớt số dòng hiển thị chứ không thay đổi phép tính phía trên nó, LIKE khớp theo mẫu ký tự chứ không khớp giá trị chính xác, ORDER BY sắp xếp kết quả nhưng không lọc bớt dòng nào, và UNION gộp kết quả của nhiều truy vấn đồng thời loại bỏ dòng trùng. EXISTS chỉ kiểm tra có dòng khớp hay không chứ không trả về giá trị của dòng đó. NULL không bằng số không và cũng không bằng chuỗi rỗng, nên so sánh NULL bằng dấu bằng thường cho kết quả sai.
Bài nhóm thì khác gì bài cá nhân?
Trả lời trực tiếp: Môn dạng này thường chia phần đánh giá thành bài cá nhân rồi tới bài nhóm, nên rủi ro dịch từ năng lực kỹ thuật sang tính nhất quán. Điểm rơi khi mỗi người dùng một hệ từ vựng, khi tên trên sơ đồ lệch tên bảng, hoặc khi giả định của người này bị truy vấn của người kia phủ định. Moody và Shanks (2003) coi tính mạch lạc là một chiều chất lượng riêng.
Chuẩn đầu ra thứ năm, về các hệ quả đạo đức, quyền riêng tư và an ninh, cũng không phải thứ trang trí. Có hai mốc đáng biết, dù trước đây bạn học ở đâu. General Data Protection Regulation (GDPR) của Liên minh châu Âu có hiệu lực từ năm 2018 và thay đổi cách các tổ chức trên toàn thế giới phải giải thích vì sao họ giữ dữ liệu cá nhân. SQL injection, một lỗ hổng sinh ra trực tiếp từ việc dựng câu truy vấn bằng cách nối chuỗi dữ liệu người dùng nhập vào, đã có mặt trong danh sách OWASP Top 10 về rủi ro ứng dụng web ở mọi phiên bản kể từ khi OWASP được thành lập năm 2001. Một lược đồ lưu dữ liệu cá nhân mà không nêu lý do giữ và quyền truy cập, hay một câu truy vấn dựng bằng cách nối chuỗi, sẽ không đạt chuẩn đầu ra này dù phần mô hình hoá ở chỗ khác có tốt tới đâu.
Nửa về dữ liệu lớn trong phần mô tả môn cũng có nguồn gốc lần lại được. Cách chia ba vế volume, velocity và variety (khối lượng, tốc độ và độ đa dạng) mà phần lớn slide về Big Data vẫn dùng do nhà phân tích Doug Laney đặt ra trong một ghi chú nghiên cứu năm 2001, hơn một thập kỷ trước khi cụm từ Big Data trở nên phổ biến. Biết rằng cách chia này đến từ phân tích ngành chứ không đến từ một bài báo bình duyệt về cơ sở dữ liệu sẽ giúp bạn hiểu vì sao môn học coi nó là bối cảnh, chứ không coi nó là một kỹ thuật chặt chẽ như chuẩn hoá. Các hệ NoSQL dựng ra để xử lý khối lượng và tốc độ đó, như MongoDB ra mắt năm 2009 và Apache Cassandra được Facebook mở mã nguồn sớm hơn một năm, vào năm 2008, cố ý nới lỏng những quy tắc chuẩn hoá mà môn này dạy. Vì vậy, dùng một kho tài liệu (document store) để trả lời một câu hỏi mô hình hoá quan hệ sẽ bị chấm là hiểu sai đề chứ không phải một phương án thay thế hợp lệ.
Bằng chứng: Làm việc nhóm hiệu quả là một chuẩn đầu ra được gọi tên của môn, chứ không phải một đặc điểm tình cờ của cách chia bài đánh giá. Moody và Shanks (2003) cũng xếp tính mạch lạc thành một chiều chất lượng độc lập của mô hình dữ liệu, đứng cạnh tính đúng và tính đầy đủ. Một mô hình mà mỗi người đọc hiểu một kiểu đã thất bại ở đúng việc mà ký pháp sinh ra để làm, và bài nhóm là nơi thất bại đó dễ lộ ra nhất. Cấu trúc và trọng số đánh giá cụ thể thay đổi giữa các kỳ, nên hãy luôn kiểm lại trên Moodle của lớp mình.
Ví dụ: Một nhóm bốn người, trong đó ba bạn là sinh viên Việt Nam, nộp báo cáo mà sơ đồ ghi Customer, lược đồ ghi Client, còn câu SQL đặt bí danh cho cả hai là c. Không có gì sai về kỹ thuật. Nhận xét của người chấm là thiết kế khó theo dõi, mà khó theo dõi lại đúng là một tiêu chí chấm. Cách mentor xử lý là dành 15 phút rà lại tên gọi trước khi nộp, và nay đó là việc đầu tiên mentor MAAS đề nghị một nhóm làm bài cơ sở dữ liệu thực hiện.
Những khái niệm mô hình hoá nào bạn cần gọi tên chính xác?
Trả lời trực tiếp: Bạn cần gọi đúng tên khoá chính, khoá ngoại và ba loại lực lượng quan hệ, vì người chấm chấm cả cách bạn nói về mô hình. Sơ đồ đúng ký hiệu mà gọi sai khái niệm vẫn mất điểm. Moody và Shanks (2003) coi mức dễ hiểu là một chiều chất lượng của mô hình, nên cách gọi tên cũng là một phần chất lượng.
PK (primary key), tức khoá chính, xác định duy nhất mỗi dòng trong một bảng. FK (foreign key), tức khoá ngoại, tham chiếu tới khoá chính của một bảng khác để biểu diễn mối quan hệ giữa hai bảng. Quan hệ một-một nghĩa là mỗi dòng ở bảng này khớp với đúng một dòng ở bảng kia, quan hệ một-nhiều là một dòng ở bảng cha khớp với nhiều dòng ở bảng con, còn quan hệ nhiều-nhiều cần thêm một bảng trung gian mới biểu diễn được. Bảng trung gian đó chính là dạng bảng liên hệ mà ví dụ nhà cung cấp ở phần trên đã dựng ra mà không có căn cứ trong đề.
Một thực thể yếu (weak entity) không tự có khoá chính mà phải mượn một phần khoá từ thực thể mà nó phụ thuộc. Một khoá phức hợp (composite key) gồm nhiều cột gộp lại vẫn chỉ là một khoá chính, chỉ là khoá chính nhiều cột. Khi viết phần lập luận, gọi đúng những tên này giúp người chấm theo được bạn đang nói về chỗ nào của sơ đồ.
Nên làm việc theo trình tự nào trong suốt kỳ?
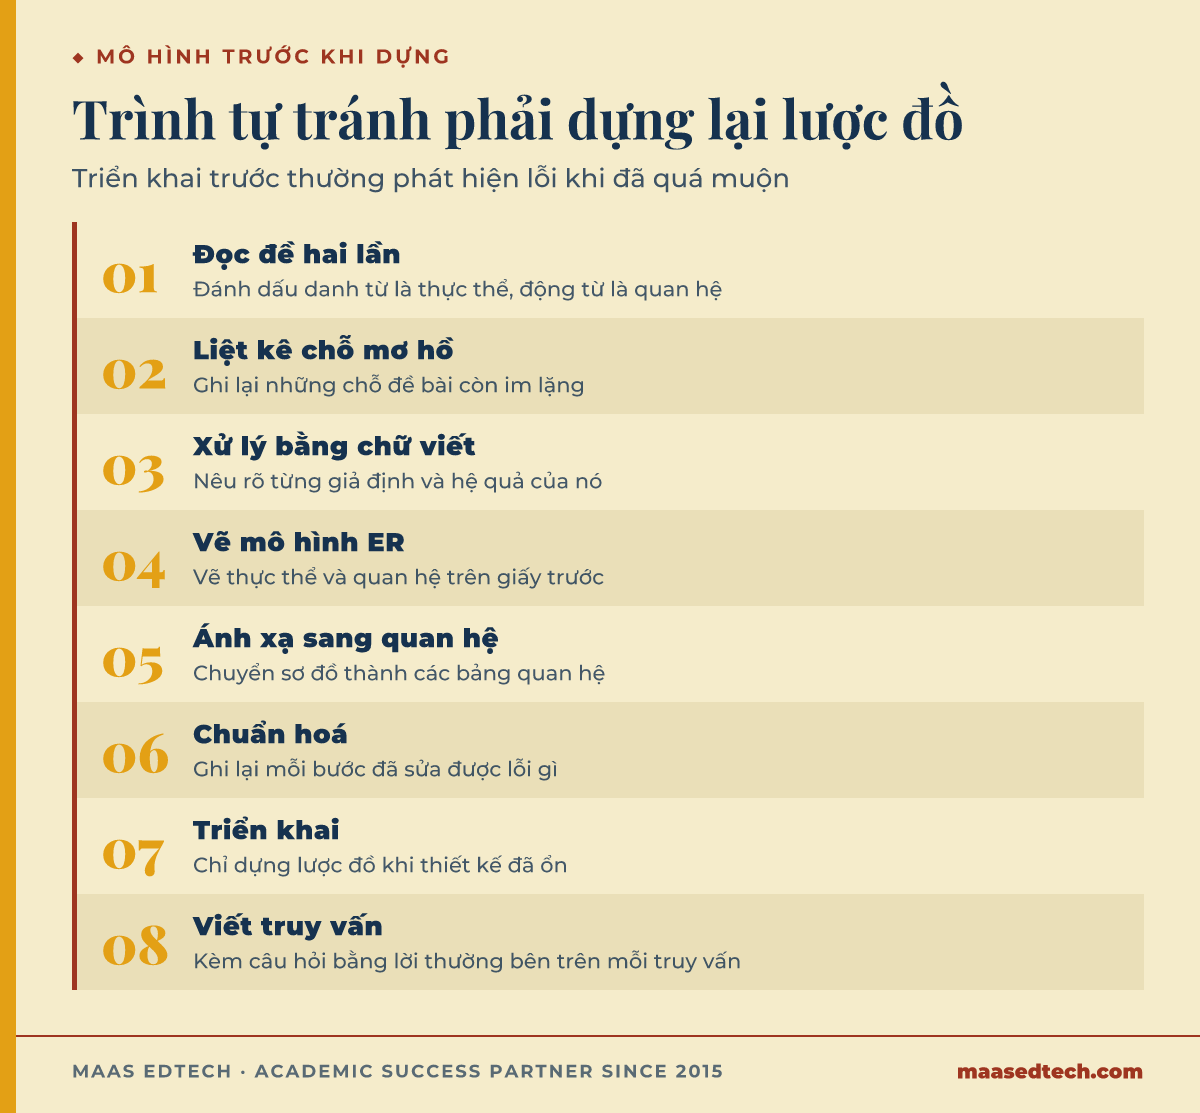
Trả lời trực tiếp: Hãy mô hình hoá trước khi dựng. Bạn đánh dấu danh từ có thể là thực thể, động từ có thể là mối quan hệ, xử lý chỗ mơ hồ bằng chữ, vẽ mô hình, chuẩn hoá, rồi mới triển khai và viết truy vấn kèm câu hỏi bằng lời thường. Codd (1970) tách tầng logic khỏi tầng vật lý nên mô hình làm xong trước được. Ai triển khai trước thường thấy lỗi mô hình khi đã muộn.
Trình tự cụ thể gồm tám bước. Bạn đọc đề hai lần và đánh dấu mọi danh từ có thể là thực thể cùng mọi động từ có thể là mối quan hệ, rồi liệt kê các chỗ mơ hồ và xử lý từng chỗ bằng chữ viết. Sau đó bạn vẽ mô hình thực thể liên kết, ánh xạ nó sang các quan hệ, chuẩn hoá và ghi lại mỗi bước đã sửa được điều gì. Chỉ khi đó bạn mới triển khai, rồi viết các câu truy vấn kèm câu hỏi bằng lời thường đặt ngay phía trên.
Bằng chứng: Connolly và Begg (2015) trình bày trình tự khái niệm, rồi logic, rồi vật lý như phương pháp thiết kế chuẩn trong loại giáo trình mà môn học dựa vào, và trình tự này tồn tại vì chi phí làm lại tăng mạnh qua mỗi giai đoạn. Sửa một mối quan hệ trên giấy mất vài phút. Cùng phép sửa đó sau khi đã triển khai sẽ đụng tới lược đồ, tới dữ liệu và tới mọi câu truy vấn dựng trên đó.
Ví dụ: Một sinh viên đang dựng lại lược đồ tới lần thứ ba trong tuần cuối được mentor đề nghị ngừng động vào cơ sở dữ liệu và dành một tiếng quay lại với sơ đồ. Bạn ấy phát hiện một mối quan hệ đã bị mô hình hoá ngược ngay từ đầu, và lỗi đó giải thích cả ba lần dựng lại. Một tiếng tưởng như làm chậm tiến độ lại chính là một tiếng chấm dứt vòng lặp.
Công cụ và các nhóm lệnh SQL thường gặp là gì?
Trả lời trực tiếp: Các môn cơ sở dữ liệu thường cho thực hành trên một hệ quản trị cơ sở dữ liệu quan hệ và một công cụ vẽ sơ đồ, ghi trong course outline. Bạn cũng nên phân biệt hai nhóm lệnh DDL và DML, cách phân loại có trong giáo trình của Connolly và Begg (2015).
Một hệ quản trị cơ sở dữ liệu quan hệ (RDBMS) thường gặp trong giảng dạy là MySQL, PostgreSQL hoặc Microsoft SQL Server, đi kèm một công cụ vẽ sơ đồ như MySQL Workbench hay Lucidchart cho phần mô hình hoá. Môn của bạn dùng hệ nào thì hãy xem course outline, vì mỗi trường và mỗi kỳ có thể chọn khác nhau.
Bản thân SQL chia thành các nhóm lệnh. DDL (Data Definition Language) dùng để tạo và sửa cấu trúc bảng qua các lệnh CREATE, ALTER và DROP. DML (Data Manipulation Language) dùng để thao tác dữ liệu qua các lệnh SELECT, INSERT, UPDATE và DELETE. Khi đề bài bàn tới dữ liệu lớn, bạn cũng có thể gặp cặp OLTP, tức hệ xử lý giao dịch trực tuyến phục vụ vận hành hằng ngày, và OLAP, tức hệ phân tích trực tuyến phục vụ báo cáo và ra quyết định. Quy trình ETL, gồm trích xuất, chuyển đổi rồi nạp dữ liệu, nối hai thế giới đó lại với nhau.
Câu hỏi thường gặp
Không biết lập trình thì có học tốt COMM2822 được không?
Được. SQL là ngôn ngữ truy vấn khai báo chứ không phải ngôn ngữ lập trình theo nghĩa thông thường, và môn học được thiết kế cho sinh viên khối kinh doanh. Người học gặp khó thường gặp khó ở chỗ xử lý sự mơ hồ khi mô hình hoá, chứ không phải ở cú pháp.
Thiết kế của mình khác bạn cùng lớp thì có phải là sai không?
Không hẳn. Hai mô hình đều bảo vệ được vẫn có thể khác nhau ở những chỗ đề bài mơ hồ. Điều phân định là mỗi bài có nêu rõ giả định tạo ra khác biệt đó và theo nó nhất quán tới cùng hay không.
Sơ đồ chiếm bao nhiêu điểm so với phần SQL?
Tỷ lệ này thay đổi theo kỳ, nên hãy đọc đề bài của lớp mình. Điều ổn định là phần lập luận bằng chữ quanh cả hai đáng giá hơn sinh viên tưởng, và đó lại là phần hay bị để tới giờ cuối.
Có nên chuẩn hoá vượt quá dạng chuẩn thứ ba không?
Chỉ nên khi bạn giải thích được vì sao, và khi tình huống đề bài đòi hỏi. Đi xa hơn mà không có lý do sẽ mời tới câu hỏi bạn đang giải quyết vấn đề gì, và câu trả lời "cho kỹ" không phải câu trả lời kiếm được điểm.
Môn có dạy cả dữ liệu lớn chứ không riêng cơ sở dữ liệu quan hệ phải không?
Đúng vậy. Nguyên lý và đặc trưng của dữ liệu lớn được nêu ngay trong phần mô tả môn, còn các hệ quả đạo đức, quyền riêng tư và an ninh của dữ liệu lớn là một trong năm chuẩn đầu ra. Một bài hướng dẫn coi môn này chỉ gồm cơ sở dữ liệu quan hệ là đang mô tả thiếu.
Bài dùng kiểu trích dẫn nào và dài bao nhiêu chữ?
Hãy xác nhận cả hai trong đề bài của lớp mình, vì yêu cầu cho báo cáo kỹ thuật thay đổi theo kỳ. Điều ổn định là mọi nguyên lý thiết kế bạn dựa vào đều nên được ghi nguồn, và một báo cáo chủ yếu gồm sơ đồ với mã lệnh vẫn cần nguồn cho các khái niệm đứng sau chúng.
MAAS có hỗ trợ COMM2822 không?
Có. Dịch vụ hỗ trợ assignment và essay của MAAS đồng hành cùng bạn theo mô hình Outline → Draft → Final, gồm giải mã tình huống đề bài, lập bản đồ giả định, rà soát thiết kế và kiểm tra logic truy vấn cùng mentor có nền tảng dữ liệu. MAAS hướng dẫn bạn làm bài của chính mình, không làm bài hộ.
Muốn bước vào COMM2822 với một thiết kế bảo vệ được?
Nếu cơ sở dữ liệu của bạn chạy được mà bạn vẫn chưa giải thích nổi vì sao nó có hình dạng như vậy, khoảng trống đó chính là chỗ một chuyên gia giúp được nhiều nhất. Dịch vụ hỗ trợ assignment và essay của MAAS làm việc cùng bạn theo trình tự Outline → Draft → Final, để các quyết định thiết kế vẫn là của bạn còn lập luận phía sau hiện ra rõ ràng trước người chấm. Ở dịch vụ này, bạn và MAAS thống nhất mục tiêu điểm theo ba mức (Pass, Merit hoặc Distinction) ngay từ đầu, kèm 45 ngày hỗ trợ sau khi nộp bài.
Bạn gửi đề bài COMM2822, và MAAS ghép bạn với một chuyên gia mảng quản trị dữ liệu trong vòng 48 giờ. Trong số hơn 100 chuyên gia của MAAS, 23% có bằng Tiến sĩ.
Trao đổi với MAAS về đề bài COMM2822 của bạn →
Bài liên quan
- COMM1190: vì sao biểu đồ đúng vẫn chỉ được điểm giữa?: môn cùng trường ở UNSW về chuyện biến kết quả phân tích thành một quyết định
- COMM2501: kể chuyện bằng dữ liệu tới đâu thì thành bóp méo dữ liệu?: về đạo đức của việc thuyết phục bằng dữ liệu khi dữ liệu đã có trong tay
- Cách tiếp cận bài ISYS3453 Data Analytics ở RMIT: một điểm đối chiếu từ một môn phân tích dữ liệu khác ở Úc
- Hướng dẫn bài ACC203 Accounting Information Systems: tư duy hệ thống áp vào dữ liệu kế toán
- Dịch vụ cố vấn học thuật MAAS: làm việc 1:1 với mentor trình độ Tiến sĩ đúng chuyên ngành
- Đồng hành bài tập theo mã môn: bài trụ về cách xử lý assignment của bất kỳ môn nào cùng mentor MAAS
References
- Chen, P. P.-S. (1976). The entity-relationship model: Toward a unified view of data. ACM Transactions on Database Systems, 1(1), 9–36. https://doi.org/10.1145/320434.320440
- Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377–387. https://doi.org/10.1145/362384.362685
- Connolly, T., & Begg, C. (2015). Database systems: A practical approach to design, implementation, and management (6th ed.). Pearson.
- Elmasri, R., & Navathe, S. B. (2016). Fundamentals of database systems (7th ed.). Pearson.
- Kent, W. (1983). A simple guide to five normal forms in relational database theory. Communications of the ACM, 26(2), 120–125. https://doi.org/10.1145/358024.358054
- Moody, D. L., & Shanks, G. G. (2003). Improving the quality of data models: Empirical validation of a quality management framework. Information Systems, 28(6), 619–650. https://doi.org/10.1016/S0306-4379(02)00043-1
Tools & resources
- UNSW Sydney. (n.d.). UNSW Handbook: COMM2822 Introduction to Databases for Business Analytics. Truy cập ngày 17 tháng 8, 2026, từ https://www.handbook.unsw.edu.au/undergraduate/courses/2026/COMM2822
- UNSW Sydney. (n.d.). UNSW Library. Truy cập ngày 17 tháng 8, 2026, từ https://www.library.unsw.edu.au
Bài viết thuộc chuyên mục MAAS Journal dành cho du học sinh Việt Nam. Dịch vụ hỗ trợ học thuật của MAAS là đối tác cố vấn, đồng hành cùng sinh viên theo mô hình Outline → Draft → Final với phản hồi mang tính phát triển từ chuyên gia đúng chuyên ngành. MAAS không viết hộ và không nộp bài thay sinh viên.