
Trả lời thẳng: Kể chuyện bằng dữ liệu (data storytelling) thành bóp méo dữ liệu đúng lúc mạch tường thuật bắt đầu chọn bằng chứng cho mình thay vì đi theo bằng chứng. COMM2501 yêu cầu bạn ghép dữ liệu, biểu đồ và mạch tường thuật thành câu chuyện thúc đẩy thay đổi, nhưng kỹ thuật làm biểu đồ thuyết phục cũng có thể làm nó gây hiểu lầm, và không ai đánh dấu sẵn ranh giới giữa hai bên.
Sinh viên coi đây là một môn học phần mềm, chỉ lo học R và Tableau, sẽ cho ra bài đạt yêu cầu. Sinh viên coi sức thuyết phục là một nghĩa vụ phải giữ đúng mức sẽ cho ra bài bảo vệ được trước người chấm.
Bài viết này giúp bạn chọn biểu đồ bằng lý lẽ có nghiên cứu đứng sau, nhận ra chỗ một biểu đồ bắt đầu nói quá sự thật, và biến bài nộp từ một bản báo cáo thành một lập luận. Cuối bài có một trình tự làm việc sáu bước để bạn áp ngay vào dự án của mình.
Tác giả: Ban Biên tập MAAS
Cập nhật lần cuối: 2026-08-12
Chuyên mục: communication-pr
COMM2501 là môn gì, và thật ra học những gì?
Trả lời thẳng: Tại UNSW, COMM2501 là môn Data Visualisation and Communication, trị giá 6 đơn vị tín chỉ bậc đại học của Business School. Môn giới thiệu công cụ thống kê và trực quan hoá cho phân tích khám phá dữ liệu, dạy dựng biểu đồ tương tác bằng R và Tableau, và đặc biệt chú trọng kể chuyện bằng dữ liệu, tức ghép dữ liệu, hình ảnh và mạch tường thuật thành một câu chuyện thúc đẩy thay đổi.
Phần mô tả môn mở đầu bằng cách gọi tên vấn đề mà môn sinh ra để giải quyết. Doanh nghiệp tạo ra khối lượng dữ liệu khổng lồ, và khả năng giúp người khác tiếp cận khối dữ liệu đó bằng hình ảnh là kỹ năng thiết yếu của người làm phân tích. Hãy chú ý cách đặt vấn đề này. Trực quan hoá được trình bày như một bài toán tiếp cận chứ không phải bài toán trang trí, và biểu đồ là giao diện nối một tập dữ liệu với một quyết định.
Một sinh viên dựng bảng điều khiển (dashboard) gồm mười hai biểu đồ phủ hết mọi thứ trong tập dữ liệu. Bảng đó rất đầy đủ nhưng không ai dùng được. Bản sửa chỉ còn ba biểu đồ trả lời đúng một câu hỏi, vì người phân tích đã tự quyết định điều gì quan trọng thay vì đẩy việc đó sang người đọc. Đây cũng là kỷ luật mà Few (2006) đặt ra cho dashboard và Knaflic (2015) đặt ra cho slide thuyết trình.
Vì sao chữ "hiệu quả" ở đây mang nghĩa kỹ thuật?
Trả lời thẳng: Vì tính hiệu quả của biểu đồ đã được Cleveland và McGill (1984) nghiên cứu bằng thực nghiệm chứ không bị bỏ mặc cho gu thẩm mỹ. Nghiên cứu đó đo được thứ bậc về mức chính xác khi con người đọc thông tin định lượng từ các cách mã hoá hình ảnh khác nhau, và thứ bậc ấy cho bạn một lý do bảo vệ được khi chọn loại biểu đồ này thay vì loại kia.
Cleveland và McGill (1984) đặt mục tiêu xây một nền tảng khoa học cho các phương pháp đồ thị. Họ xác định một tập nhiệm vụ tri giác cơ bản mà người đọc thực hiện khi đọc thông tin định lượng trên đồ thị, rồi xếp các nhiệm vụ đó theo mức chính xác mà con người làm được. Nguyên tắc thiết kế suy ra trực tiếp là đồ thị nên dùng những nhiệm vụ nằm càng cao trong thứ bậc càng tốt. Áp nguyên tắc này, hai tác giả kết luận rằng những dạng phổ biến như biểu đồ tròn và biểu đồ thanh chia đoạn cần tới thứ họ gọi là một cuộc phẫu thuật triệt để, vì biểu đồ tròn bắt người đọc phán đoán góc, trong khi cùng dữ liệu đó luôn trình bày được trên một thang chung để người đọc phán đoán vị trí.
Các loại biểu đồ đang bị đem ra xét trong môn này có từ trước máy tính khoảng hai thế kỷ. William Playfair thường được ghi nhận là người đưa ra biểu đồ cột và biểu đồ đường năm 1786, rồi biểu đồ tròn năm 1801, trong những công trình mà các nhà sử học về đồ hoạ thống kê coi là điểm khởi đầu của lĩnh vực. Cleveland và McGill (1984) kiểm tra đúng những dạng đó và thấy biểu đồ tròn, dạng ra đời muộn nhất trong ba dạng, lại kém chính xác nhất cho kiểu so sánh mà người ta thường dùng nó để làm.
Munzner (2014) sắp xếp mảng văn liệu này thành một khung rộng hơn trong cuốn Visualization Analysis and Design do CRC Press xuất bản, lập luận rằng chọn cách mã hoá phải đi theo phân tích nhiệm vụ của người đọc chứ không theo thói quen. Ware (2013) đưa cùng ý tưởng đó sang khoa học tri giác nói chung trong Information Visualization: Perception for Design của Morgan Kaufmann, cho rằng người thiết kế hiểu cách hệ thị giác vận hành có thể đoán trước cách mã hoá nào sẽ thất bại trước khi có người đọc nào nhìn thấy biểu đồ. Tạp chí IEEE Transactions on Visualization and Computer Graphics vẫn là một trong những nơi chính để các thứ bậc tri giác này tiếp tục được kiểm tra và điều chỉnh, bên cạnh hội nghị VIS của IEEE, diễn đàn nghiên cứu hàng đầu của ngành.
Khi được hỏi vì sao thay biểu đồ tròn bằng biểu đồ chấm (dot chart), một câu trả lời yếu nói rằng biểu đồ tròn bị coi là lỗi thời. Một câu trả lời mạnh hơn nói rằng dữ liệu là các phần của một tổng thể nên đặt được lên một thang chung, rằng phán đoán vị trí trên thang chung chính xác hơn phán đoán góc, và rằng thứ tự của năm nhóm không đọc được trên biểu đồ tròn nhưng hiện ra ngay trên biểu đồ chấm. Hai câu trả lời dẫn tới cùng một quyết định, nhưng chỉ câu thứ hai là lập luận, vì nó áp Cleveland và McGill (1984) thẳng vào năm nhóm dữ liệu của chính người viết thay vì chỉ trích một quy tắc.
Ranh giới đạo đức của việc kể chuyện bằng dữ liệu nằm ở đâu?
Trả lời thẳng: Trong COMM2501, ranh giới đó nằm ở chỗ mạch tường thuật bắt đầu chọn lọc bằng chứng thay vì đi theo bằng chứng. Kể chuyện đòi bạn phải có một luận điểm, nhưng không cho phép bạn sắp xếp lại dữ liệu cho tới khi dữ liệu nói ra đúng luận điểm ấy, dù xu hướng bạn muốn nhấn mạnh có thật.
Bóp méo không phải chuyện giả định, và tác động của nó đã được đo. Pandey và cộng sự (2015) thực hiện một phân tích thực nghiệm về những kỹ thuật bóp méo thường gặp trong trực quan hoá, kiểm tra xem các thao tác quen thuộc có thật sự làm thay đổi kết luận của người đọc hay không. Phát hiện quan trọng với bài tập của bạn là chúng có làm thay đổi. Một trục bị cắt cụt, một thang bị đảo chiều hay một tỷ lệ khung hình bị chỉnh không phải nét phong cách mà người đọc tinh ý sẽ tự trừ hao, vì chúng làm dịch chuyển phán đoán của người đọc.
Huff (1954) nêu một ý tương tự từ nhiều thập kỷ trước, và Tufte (1983) về sau hình thức hoá nó trong The Visual Display of Quantitative Information thành hệ số nói dối (lie factor), tức tỷ số giữa độ lớn của một hiệu ứng hiện trên hình và độ lớn của hiệu ứng đó trong dữ liệu gốc. Cả hai lập luận đều ra đời trước thời dashboard tương tác, và cả hai tới nay vẫn đúng. Bản thân nghiên cứu của Pandey và cộng sự được công bố ở hội nghị CHI của ACM, diễn đàn chính của ngành để kiểm tra người đọc thật sự phản ứng với biểu đồ ra sao, chứ không phải người thiết kế định cho họ đọc thế nào.
Cairo (2019) liệt kê cùng vấn đề đó từ phía người đọc trong How Charts Lie, gồm trục bị cắt cụt, biểu đồ hai trục và khung thời gian được chọn cho vừa ý, là những kỹ thuật biến một tập dữ liệu chính xác thành một biểu đồ gây hiểu lầm mà không có con số nào trong đó sai.
Kết quả của Pandey và cộng sự có tác dụng theo cả hai chiều, nên nó thuộc về một môn kể chuyện bằng dữ liệu chứ không chỉ thuộc về một môn đạo đức. Nếu bóp méo có tác dụng thật, thì mọi lựa chọn thiết kế của bạn đều là lựa chọn về mức độ người đọc sẽ tin, và bạn không thể tự nhận là trung lập với một quyết định mình đã cân nhắc rồi mới chọn.
Một sinh viên xây lập luận về chi phí đang tăng đã cắt cụt trục tung, khiến một mức tăng vừa phải trông thành kịch tính. Khi bị hỏi, bạn ấy nói xu hướng đó là thật, và nó đúng là thật. Bản sửa giữ nguyên trục đầy đủ, còn lập luận được đưa vào phần chú thích, chỉ ra rằng mức tăng 4% trên nền đó là đáng kể nếu xét biên lợi nhuận. Lập luận vẫn đứng vững, nó chỉ chuyển từ cái trục sang một câu chữ, nơi người đọc kiểm tra được.
Giai đoạn khám phá để lại món nợ gì cho biểu đồ cuối cùng?
Trả lời thẳng: Trong COMM2501, giai đoạn khám phá để lại cho biểu đồ cuối cùng một món nợ, là lời kể trung thực về những gì bạn đã loại bỏ. Phân tích khám phá bao giờ cũng kéo theo các quyết định về giá trị thiếu, điểm ngoại lai (outlier) và khoảng thời gian lấy dữ liệu, và những quyết định đó thường định hình biểu đồ mạnh hơn bảng màu rất nhiều.
Trình tự của môn đặt khám phá trước truyền đạt là có lý do. Tới lúc bạn làm biểu đồ cuối cùng, bạn đã chọn xong giữ lại những dòng dữ liệu nào, xử lý chỗ trống ra sao, và chuỗi số bắt đầu, kết thúc ở đâu. Người đọc chỉ thấy biểu đồ hoàn thiện thì không thấy được bất kỳ quyết định nào trong số đó, nên nghĩa vụ công bố thuộc về bạn chứ không thuộc về họ. Đây cũng là nguyên tắc của câu chuyện cái trục ở phần trên, chỉ áp sớm hơn một bước trong quy trình.
Segel và Heer (2010) lần theo cách báo chí dữ liệu chuyên nghiệp kết hợp biểu đồ khám phá với cấu trúc tường thuật, còn Bertin (1967) từ nhiều thập kỷ trước đã lập luận rằng một hình đồ hoạ tồn tại để trả lời một câu hỏi chứ không phải để lưu trữ dữ liệu. Cả hai cách đọc đều ủng hộ cùng một nguyên tắc mà môn này dạy, là biểu đồ khám phá và biểu đồ cuối cùng phục vụ hai người đọc khác nhau.
Một sinh viên loại hai tháng ngoại lai vì cho rằng đó là lỗi dữ liệu, và xu hướng trở nên sạch sẽ, thuyết phục hẳn. Khi trợ giảng hỏi hai tháng đó đã xảy ra chuyện gì, hoá ra một tháng là một cú sốc có thật mà câu chuyện cần giải thích chứ không nên gạt đi. Bản cuối giữ lại cả hai điểm, chú thích rõ cú sốc, và đưa ra được một khẳng định mạnh hơn vì đã tính tới cả điểm không khớp. Đó cũng là việc công bố mà Segel và Heer (2010) lẫn Bertin (1967) coi là cái giá của việc khám phá trước khi truyền đạt.
Điều gì phân biệt một câu chuyện dữ liệu với một bản báo cáo?
Trả lời thẳng: Báo cáo phủ hết tập dữ liệu và ghi nhãn trục, còn câu chuyện dữ liệu trả lời đúng một câu hỏi, chỉ chọn những biểu đồ gánh được lập luận, và đối diện với cách đọc ngược chiều mạnh nhất. Few (2006) cùng Kosara và Mackinlay (2013) đều đặt ranh giới ở đó, giữa một thứ phải dò đọc như báo cáo và một thứ nắm được ngay khi liếc qua.
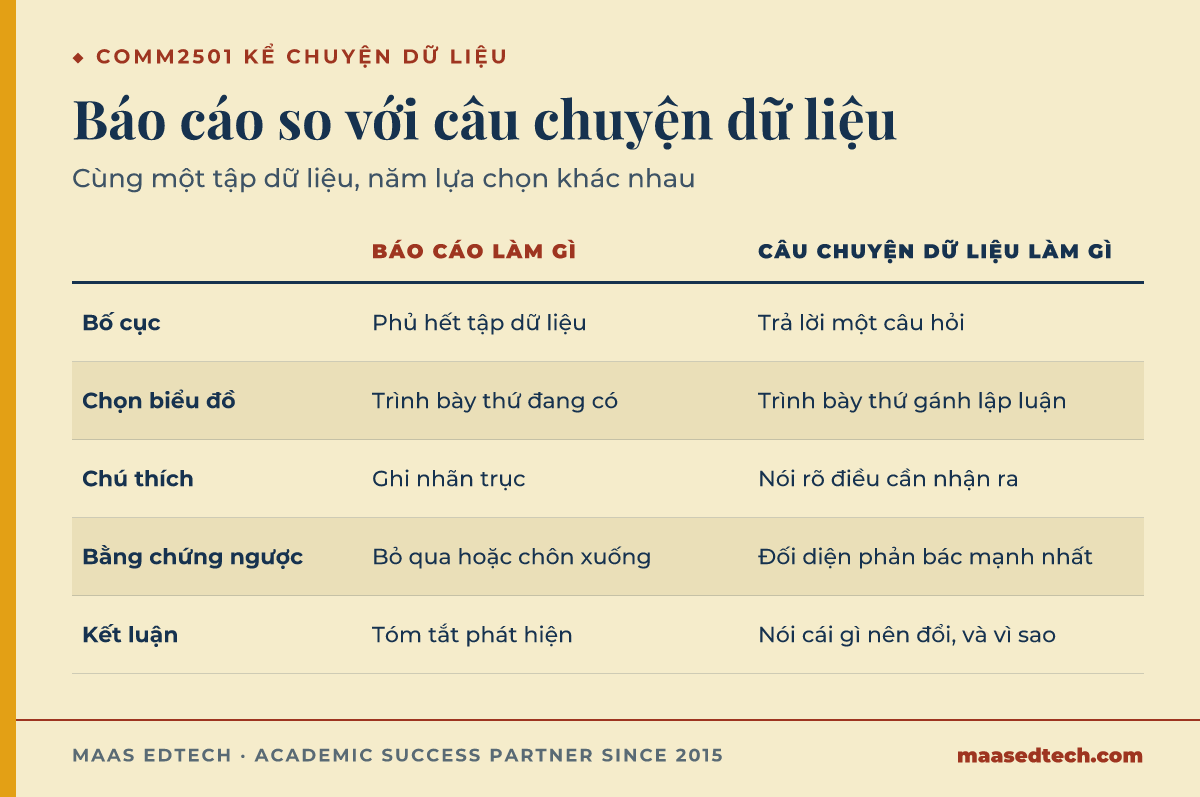
| Thành phần | Báo cáo làm gì | Câu chuyện dữ liệu làm gì |
|---|---|---|
| Bố cục | Phủ hết tập dữ liệu | Trả lời đúng một câu hỏi |
| Chọn biểu đồ | Trình bày thứ đang có | Trình bày thứ gánh lập luận |
| Chú thích | Ghi nhãn trục | Nói rõ người đọc nên nhận ra điều gì |
| Bằng chứng ngược chiều | Bỏ qua hoặc chôn xuống dưới | Đối diện với cách đọc ngược chiều mạnh nhất |
| Kết luận | Tóm tắt phát hiện | Nói điều gì nên thay đổi và dựa trên căn cứ nào |
Mô tả môn nêu mục tiêu là một câu chuyện đủ mạnh để thúc đẩy thay đổi, nghĩa là sản phẩm được chấm như một lập luận. Một lập luận chưa đối diện với phản bác mạnh nhất của nó là lập luận chưa xong, bất kể nó được dựng hình đẹp tới đâu.
Few (2006) nêu một phân biệt tương tự cho dashboard doanh nghiệp trong Information Dashboard Design, rằng một dashboard phải đọc được ngay khi liếc qua chứ không phải để dò đọc như báo cáo. Kosara và Mackinlay (2013) đưa lập luận đó thẳng sang chuyện kể chuyện bằng dữ liệu, trong bài The Next Step for Visualization đăng trên tạp chí Computer của IEEE.
Knaflic (2015) đi tới kết luận gần giống, khi khẳng định một biểu đồ chỉ xứng đáng có mặt trong bộ slide kinh doanh khi nó truyền tải được điều bà gọi là big idea, tức ý lớn gói trong một câu mà người đọc có thể nhắc lại đúng. Yau (2011) nói cùng ý đó từ một góc khác trong Visualize This, coi biểu đồ hoàn chỉnh là một lập luận về việc quan hệ nào trong dữ liệu đủ quan trọng để trình bày, chứ không phải một bản kiểm kê mọi thứ có thể trình bày.
Hai dự án cùng khai thác một bộ dữ liệu về năng suất lao động. Dự án thứ nhất trình bày xu hướng rồi kết luận rằng năng suất là vấn đề. Dự án thứ hai trình bày đúng xu hướng ấy, thừa nhận cách đọc cạnh tranh tập trung vào chất lượng việc làm và tình trạng thiếu việc làm, giải thích phần nào của dữ liệu tách được hai cách đọc, rồi mới lập luận cho kết luận của mình. Dự án thứ hai mới là dự án đứng vững được trước câu hỏi của một người không đồng tình.
Phần công cụ nên quan trọng tới mức nào?
Trả lời thẳng: Phần công cụ ít quan trọng hơn sinh viên thường nghĩ, và nó nên vô hình trong sản phẩm cuối. R và Tableau là cách bạn tạo ra sản phẩm, còn điểm số không phụ thuộc vào việc người đọc nhận ra bạn đã vất vả tới đâu. Câu hỏi được chấm là biểu đồ có đúng là biểu đồ cần dùng hay không.
Môn học đặt các công cụ vào một chuỗi bắt đầu bằng phân tích khám phá và kết thúc bằng truyền đạt. Khám phá là lúc công cụ phát huy giá trị, vì đó là lúc bạn đang tìm hiểu trong dữ liệu có gì. Tới lúc truyền đạt, câu hỏi chỉ còn là biểu đồ này có phải biểu đồ đúng hay không, và câu hỏi ấy có cùng một đáp án bất kể phần mềm nào vẽ ra.
Cả hai công cụ đều bắt nguồn từ nghiên cứu thật chứ không phải từ những thiết lập mặc định tuỳ tiện. Wilkinson (2005) trình bày ngữ pháp đồ hoạ trong cuốn sách cùng tên, mô tả biểu đồ là tổ hợp của dữ liệu, hình học và thang đo chứ không phải một khuôn mẫu cố định, và Wickham (2010) chuyển ngữ pháp đó sang R trong một bài đăng trên Journal of Computational and Graphical Statistics, cũng là lý thuyết mà gói ggplot2 của R vẫn đi theo. Tableau có nguồn gốc tương tự. Stolte, Tang và Hanrahan (2002) mô tả Polaris, một hệ thống nghiên cứu của Stanford University để truy vấn và trực quan hoá dữ liệu nhiều chiều, trên IEEE Transactions on Visualization and Computer Graphics, và Polaris về sau trở thành nền của sản phẩm thương mại này. Những điều đó tự chúng không làm tăng điểm, nhưng giải thích vì sao R và Tableau cứ đưa bạn về đúng những cách mã hoá mà Cleveland và McGill mô tả năm 1984.
Một sinh viên dành gần trọn một tuần dự án để dựng biểu đồ tương tác có bộ lọc liên kết. Biểu đồ chạy tốt, nhưng không người đọc nào từng đổi một bộ lọc. Một biểu đồ tĩnh kèm chú thích rõ ràng cũng truyền tải được đúng insight đó, và tuần ấy lẽ ra nên dành để kiểm tra xem insight có đúng hay không.
Nên làm một câu chuyện dữ liệu theo trình tự nào?
Trả lời thẳng: Hãy viết câu hỏi trước khi mở dữ liệu, khám phá riêng và giữ biểu đồ khám phá ngoài sản phẩm cuối, rồi chọn cách mã hoá theo nhiệm vụ tri giác thay vì theo mong muốn đa dạng. Sau đó viết chú thích trước khi chốt biểu đồ, vẽ bản trung thực trước dù hiệu ứng nhỏ đi, và gọi tên cách đọc ngược chiều mạnh nhất.
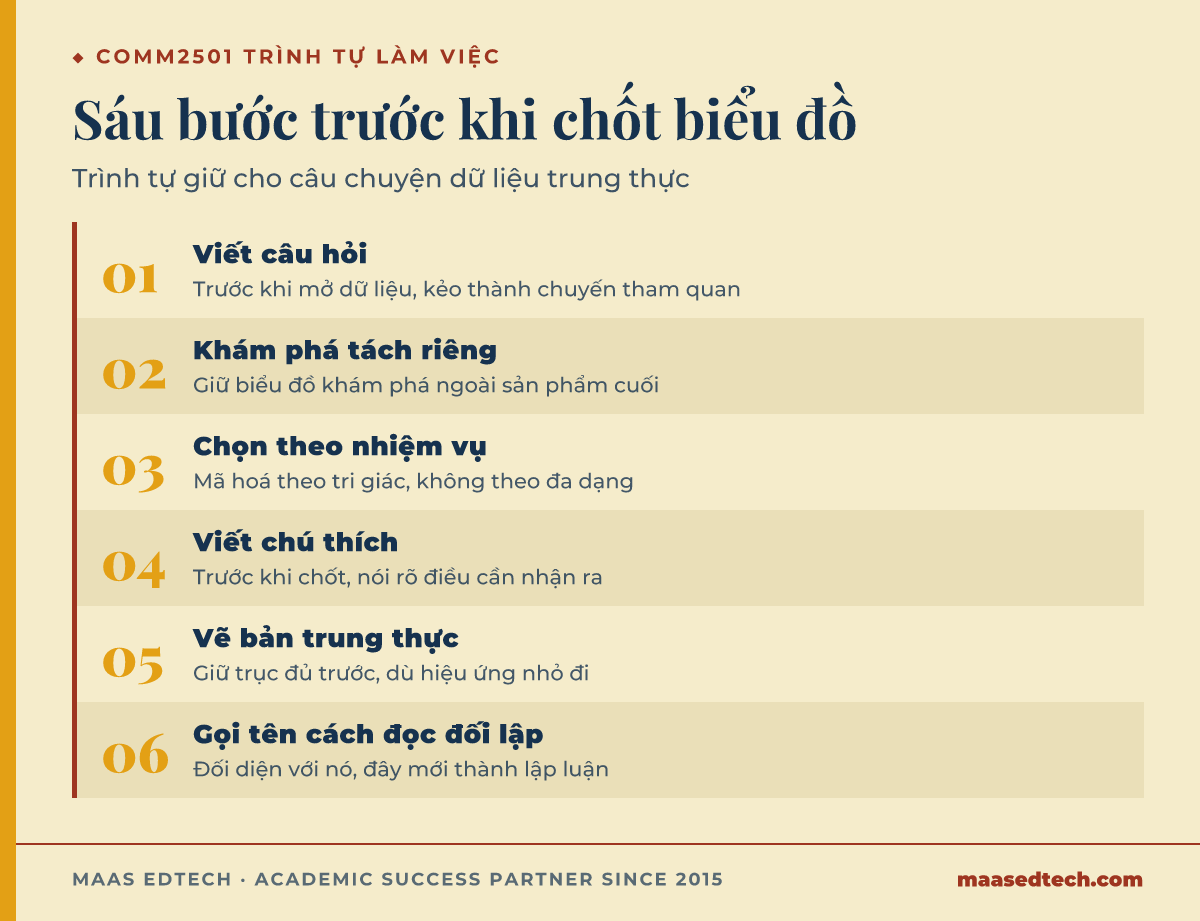
- Viết ra câu hỏi trước khi mở dữ liệu. Một câu chuyện dữ liệu không có câu hỏi sẽ thành một chuyến tham quan tập dữ liệu, đúng kiểu thất bại mà Knaflic (2015) muốn loại bỏ bằng phép thử "big idea".
- Khám phá trước, và khám phá riêng. Giữ biểu đồ khám phá ngoài sản phẩm cuối, vì chúng được dựng để giúp bạn hiểu dữ liệu chứ không phải để phục vụ người đọc, đúng sự phân tách giữa phân tích và trình bày mà Segel và Heer (2010) mô tả.
- Chọn cách mã hoá theo nhiệm vụ tri giác, đừng chọn theo mong muốn đa dạng. Nếu người đọc cần so sánh giá trị, hãy cho họ vị trí trên một thang chung, thứ bậc mà cả Cleveland và McGill (1984) lẫn Ware (2013) đều bảo vệ.
- Viết chú thích trước khi chốt biểu đồ. Nếu bạn chưa nói được người đọc nên nhận ra điều gì, biểu đồ đó chưa xong.
- Vẽ bản trung thực trước. Nếu hiệu ứng biến mất khi để trục đầy đủ, đó là một phát hiện về hiệu ứng chứ không phải vấn đề của cái trục, và đây là phép thử công bố mà Cairo (2019) lẫn Tufte (1983) cùng áp cho chuyện chỉnh trục.
- Gọi tên cách đọc ngược chiều mạnh nhất với dữ liệu của bạn rồi trả lời nó. Bước này biến một bài trình bày thành một lập luận.
Câu hỏi thường gặp
Có cần biết lập trình trước khi học môn này không?
Môn học có dạy công cụ, và sinh viên chưa có nền lập trình vẫn theo được, nhưng hãy dành thời gian cho phần thao tác ngay từ những tuần đầu để về sau phần mềm không còn giành sự chú ý với phần tư duy.
Biểu đồ càng phức tạp thì càng tốt phải không?
Không. Sự phức tạp chỉ chính đáng khi câu hỏi đòi hỏi nó. Riêng phần tương tác thì nên thêm vào khi người đọc cần tự đặt câu hỏi tiếp theo của họ, chứ không phải vì công cụ có sẵn chức năng đó. Tải nhận thức cũng có giá của nó. Miller (1956) nói thẳng về giới hạn này: "Everybody knows that there is a finite span of immediate memory and that for a lot of different kinds of test materials this span is about seven items in length" (Miller, 1956, p. 91), nghĩa là trí nhớ tức thời có giới hạn, khoảng bảy mục với nhiều loại tài liệu. Đó là một lý do khiến một dashboard với mười hai bộ lọc liên kết đòi hỏi người đọc nhiều hơn một biểu đồ tĩnh chỉ có ba.
Có được cắt cụt trục không?
Có những trường hợp chính đáng, và phép thử là việc cắt trục giúp người đọc thấy một điều có thật, hay tạo ra một ấn tượng mà dữ liệu không đỡ được, đúng phép thử mà Cairo (2019) và Tufte (1983) áp cho chuyện chỉnh trục. Nếu cắt, hãy nói rõ ngay trên biểu đồ và cho người đọc biết mốc nền.
Gặp bộ dữ liệu không đỡ được lập luận của mình thì làm sao?
Hãy đổi lập luận. Điều này nghe hiển nhiên, nhưng đây lại là chỗ các câu chuyện dữ liệu của sinh viên hay hỏng nhất, vì mạch tường thuật thường bị chốt cứng trước khi phần phân tích kịp xong.
Bài phân tích dữ liệu có nên trích tài liệu về trực quan hoá không?
Hãy theo course outline của môn. Ở chỗ phù hợp, một lựa chọn thiết kế được biện minh bằng nghiên cứu tri giác, như Cleveland và McGill (1984) cho cách mã hoá hay Knaflic (2015) cho bố cục, mạnh hơn hẳn một lựa chọn chỉ dựa vào sở thích, mà chỉ tốn một câu.
Phần tường thuật viết dài bao nhiêu là vừa?
Các bài xoay quanh một câu chuyện dữ liệu thường có phần tường thuật dài khoảng 1.500 tới 2.500 chữ, chưa tính biểu đồ, nhưng con số chính xác luôn nằm trong course outline của chính bạn chứ không nằm trong một quy tắc chung. Munzner (2014) và Few (2006) cũng kèm đúng lưu ý này mỗi khi nhắc tới số chữ.
Mentor MAAS hỗ trợ gì trong một môn như thế này?
Trả lời thẳng: Mentor MAAS làm việc cùng sinh viên chứ không làm thay, và với một câu chuyện dữ liệu, vòng góp ý hữu ích nhất thường là một lượt đọc ở vị trí người phản đối: xem một người không đồng tình với kết luận của bạn sẽ nói gì về biểu đồ này, cái trục này, năm dữ liệu bị bỏ đi này. Phần phân tích vẫn là của bạn.
Bài đã qua được lượt đọc đó thường đơn giản hơn bài chưa qua, vì những phần trang trí không đứng vững trước câu hỏi. Nếu cách làm này hữu ích với bạn, dịch vụ hỗ trợ học thuật và dịch vụ dự án dữ liệu và lập trình là hai nơi để bắt đầu.
References
Bertin, J. (1967). Sémiologie graphique: Les diagrammes, les réseaux, les cartes. Mouton/Gauthier-Villars.
Cairo, A. (2019). How charts lie: Getting smarter about visual information. W. W. Norton & Company.
Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
Few, S. (2006). Information dashboard design: The effective visual communication of data. O'Reilly Media.
Huff, D. (1954). How to lie with statistics. W. W. Norton & Company.
Knaflic, C. N. (2015). Storytelling with data: A data visualization guide for business professionals. Wiley.
Kosara, R., & Mackinlay, J. (2013). Storytelling: The next step for visualization. Computer, 46(5), 44–50. https://doi.org/10.1109/MC.2013.36
Miller, G. A. (1956). The magical number seven, plus or minus two: Some limits on our capacity for processing information. Psychological Review, 63(2), 81–97. https://doi.org/10.1037/h0043158
Munzner, T. (2014). Visualization analysis and design. CRC Press.
Pandey, A. V., Rall, K., Satterthwaite, M. L., Nov, O., & Bertini, E. (2015). How deceptive are deceptive visualizations? An empirical analysis of common distortion techniques. In Proceedings of the 33rd Annual ACM Conference on Human Factors in Computing Systems (pp. 1469–1478). ACM. https://doi.org/10.1145/2702123.2702608
Segel, E., & Heer, J. (2010). Narrative visualization: Telling stories with data. IEEE Transactions on Visualization and Computer Graphics, 16(6), 1139–1148. https://doi.org/10.1109/TVCG.2010.179
Stolte, C., Tang, D., & Hanrahan, P. (2002). Polaris: A system for query, analysis, and visualization of multidimensional relational databases. IEEE Transactions on Visualization and Computer Graphics, 8(1), 52–65. https://doi.org/10.1109/2945.981851
Tufte, E. R. (1983). The visual display of quantitative information. Graphics Press.
Ware, C. (2013). Information visualization: Perception for design (3rd ed.). Morgan Kaufmann.
Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer.
Yau, N. (2011). Visualize this: The FlowingData guide to design, visualization, and statistics. Wiley.
Tools & resources
UNSW Sydney. (2025). COMM2501: Data Visualisation and Communication. https://handbook.unsw.edu.au/undergraduate/courses/2025/COMM2501