
Trả lời thẳng: Ở COMM1190, một bài có code R chạy được, biểu đồ ghi nhãn đầy đủ và con số chính xác vẫn thường chỉ được điểm ở nhóm giữa, vì bài đó thiếu câu nói rằng doanh nghiệp nên làm gì khác đi và vì sao bằng chứng này đỡ được lời khuyên đó.
Môn Data, Insights and Decisions cố ý đặt chữ insights vào tên môn, và khoảng cách giữa kết quả chạy ra (output) với một insight thật chính là chỗ điểm số nằm.
Bài viết này giúp bạn biến kết quả phân tích của mình thành insight mà người chấm tìm kiếm, từ cách đọc chuẩn đầu ra của môn cho tới cách bố cục báo cáo và cách viết khuyến nghị dám cam kết. Bạn cũng sẽ thấy vài ví dụ bài nộp lên điểm nhờ đổi cách trình bày, cùng những chỗ du học sinh Việt hay mất điểm.
Tác giả: Ban Biên tập MAAS
Cập nhật lần cuối: 2026-08-10
Chuyên mục: business-management
COMM1190 là môn gì và nằm ở đâu trong chương trình?
Trả lời thẳng: COMM1190 Data, Insights and Decisions là môn bậc cử nhân trị giá 6 đơn vị tín chỉ của UNSW Business School tại cơ sở Kensington, mở ở cả ba kỳ giảng dạy trong năm. Môn học nối tiếp COMM1110 Evidence-based Problem Solving, dạy khám phá, trực quan hoá và phân tích dự báo trên dữ liệu kinh doanh thật bằng R, và đặc biệt chú trọng trình bày kết quả cho người không đọc code.
Các dữ kiện này lấy từ trang handbook của UNSW và thời khoá biểu chính thức của trường, nơi ghi số tín chỉ, khoa phụ trách, cơ sở học và việc môn chạy ở cả Term 1, Term 2 lẫn Term 3. Thời khoá biểu cũng cho thấy quy mô của môn, vì chỉ trong một kỳ, mỗi luồng bài giảng đã có hàng trăm sinh viên.
Một sinh viên cho rằng môn chạy ba lần một năm với lớp đông như vậy hẳn là môn tự chọn dễ lấy điểm. Trên thực tế, quy mô lớn lại hàm ý điều ngược lại. Lớp đông thì bài được một nhóm trợ giảng chấm theo cùng một bảng tiêu chí (rubric), nên tiêu chí được áp rất nhất quán, và gần như không còn chỗ để người chấm thưởng cho một thứ mà tiêu chí không nhắc tới.
Ý cuối cùng đó là điều đáng rút ra nhất từ con số sĩ số. Ở một môn quy mô như thế này, tiêu chí chấm không phải tài liệu tham khảo cho bài đánh giá, mà chính là bài đánh giá.
Chuẩn đầu ra của môn thật ra đòi hỏi những gì?
Trả lời thẳng: Chuẩn đầu ra đòi bốn thứ, và chỉ một trong số đó là phân tích. Bạn phải giải thích được một tổ chức dùng công cụ phân tích và thống kê thế nào để hiểu vấn đề, áp dụng thống kê lên tập dữ liệu thật để ra quyết định có căn cứ, trực quan hoá dữ liệu nhằm đỡ cho một lập luận, và truyền đạt khuyến nghị tới nhiều nhóm liên quan.
Hãy đọc kỹ chuẩn đầu ra thứ ba, trực quan hoá và phân tích dữ liệu để làm chỗ dựa cho lập luận. Ngay trong câu chữ, biểu đồ đã đứng ở vị trí phục vụ lập luận. Một bài mà các biểu đồ xếp thành một bộ sưu tập, cái nào cũng vẽ đúng mà không cái nào gánh phần lập luận, là bài đã đảo ngược quan hệ mà chuẩn đầu ra mô tả. Chuẩn đầu ra thứ tư sau đó nói rõ người đọc là ai, nghĩa là bạn phải viết cho một người muốn có quyết định chứ không muốn nghe về phương pháp.
Một báo cáo trình bày sáu biểu đồ, mỗi biểu đồ kèm một câu mô tả nó đang hiển thị gì. Khi được hỏi nếu khách hàng chỉ đọc được đúng một trang thì giữ lại hai biểu đồ nào, người viết chỉ ra được hai biểu đồ làm thay đổi việc khách hàng nên làm, và không bảo vệ được bốn biểu đồ còn lại. Cắt bốn biểu đồ đó đi, lập luận của bài mới lần đầu hiện ra rõ ràng.
Kết quả chạy ra khác một insight ở chỗ nào?
Trả lời thẳng: Một insight gọi tên được điều mà tổ chức chưa biết, ở dạng đủ cụ thể để hành động, kèm bằng chứng và kèm giới hạn của nó. Mọi thứ chưa tới được mức đó đều mới chỉ là kết quả chạy ra, dù con số có chính xác và biểu đồ có đẹp tới đâu, và người chấm COMM1190 phân biệt hai loại này rất rõ khi xếp bài vào các mức điểm.
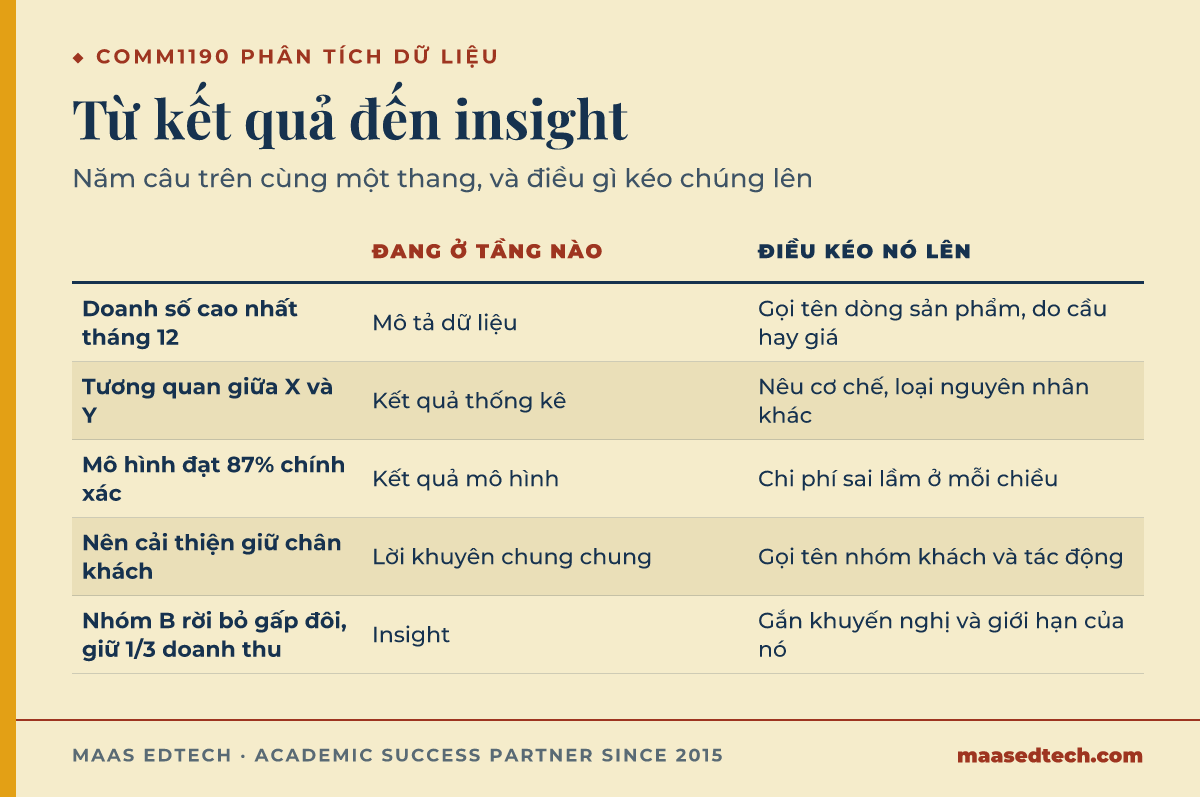
| Bài viết đang nói gì | Nó đang ở tầng nào | Điều gì kéo nó lên |
|---|---|---|
| "Doanh số cao nhất vào tháng Mười Hai." | Mô tả dữ liệu | Dòng sản phẩm nào đẩy con số đó, và do nhu cầu hay do giảm giá |
| "Có tương quan giữa X và Y." | Kết quả thống kê | Cơ chế hợp lý nào nối hai biến, và điều gì khác có thể tạo ra cùng một dạng dữ liệu |
| "Mô hình đạt độ chính xác 87%." | Kết quả mô hình | Mỗi chiều sai của mô hình gây tốn kém ra sao |
| "Công ty nên cải thiện khả năng giữ chân khách hàng." | Lời khuyên chung chung | Nhóm khách nào, dựa trên bằng chứng gì, và kỳ vọng tác động tới đâu |
| "Nhóm B rời bỏ với tỷ lệ gấp đôi và chiếm một phần ba doanh thu." | Insight | Gắn thêm khuyến nghị và mức độ không chắc chắn quanh nó |
Tách mô tả dữ liệu khỏi suy luận từ dữ liệu là toàn bộ công việc của Exploratory Data Analysis, tức phân tích khám phá dữ liệu (EDA). John Tukey (1977), nhà thống kê của Princeton University từng làm việc ở Bell Labs, coi EDA là đi tìm điều dữ liệu gợi ra chứ không phải xác nhận điều mình đã nghĩ sẵn. Ở phía trình bày, Edward Tufte (2001), giáo sư danh dự của Yale University, lập luận trong cuốn sách của ông rằng thiết kế hình ảnh tồn tại để phục vụ lập luận, nên một biểu đồ không gánh lập luận nào chỉ là đồ trang trí, dù vẽ đẹp tới đâu. Leland Wilkinson (2005), nhà thống kê từng xây dựng phần mềm SYSTAT, nhắc lại nguyên lý đó trong The Grammar of Graphics. Con số độ chính xác (accuracy) cũng đáng bị soi như vậy. Foster Provost, giáo sư New York University, cùng Tom Fawcett chỉ ra trong Data Science for Business (Provost & Fawcett, 2013) rằng trên dữ liệu kinh doanh mất cân bằng, một mô hình không bao giờ dự đoán đúng kết cục hiếm mà ai cũng quan tâm vẫn có thể đạt độ chính xác cao. Vì vậy Confusion Matrix, tức bảng đối chiếu dự đoán với thực tế, cùng các chỉ số như AUC và Root Mean Squared Error (RMSE) kể câu chuyện đầy đủ hơn một con số accuracy đơn lẻ. Một dạng nhầm lẫn họ hàng với chuyện này xảy ra ở môn 6BUS1035, nơi sinh viên gộp hệ thống business intelligence, vốn khai phá dữ liệu để tìm insight như ở COMM1190, chung với hệ thống quản trị tri thức, một ranh giới mà bài hướng dẫn phân biệt quản trị tri thức với business intelligence phân tích kỹ.
Một sinh viên báo độ chính xác mô hình khá cao trên tập dữ liệu khách hàng rời bỏ (churn) và coi như xong. Vì chỉ một phần nhỏ khách hàng thật sự rời bỏ, một mô hình đoán rằng không ai rời bỏ cũng đạt điểm gần bằng. Tới khi sinh viên đó báo thêm mô hình bắt được bao nhiêu khách rời bỏ thật, con số tụt hẳn, và bài phân tích trở nên trung thực và thú vị hơn nhiều.
Phần code R quan trọng tới đâu?
Trả lời thẳng: Code phải chạy được và tái lập được, nhưng tự nó không đưa bài lên nhóm điểm cao nhất. Code là công cụ, còn điểm đi theo những gì bạn làm được với kết quả công cụ đó tạo ra. Vì vậy người chấm thường nhìn vào phần diễn giải nhiều hơn vào độ gọn gàng của từng dòng lệnh, miễn là code không làm hỏng kết quả.
Môn học dạy R, ngôn ngữ do The R Foundation for Statistical Computing duy trì, vì đây là công cụ nguồn mở dùng được trên dữ liệu thật, chứ không phải vì kỹ năng lập trình là đối tượng được chấm. Giao diện phổ biến nhất của R là RStudio, công ty đứng sau nó đổi tên thành Posit năm 2022, và các gói sinh viên cài đặt thường lấy từ Comprehensive R Archive Network (CRAN), kho lưu trữ do chính quỹ này duy trì. Nhiều quy trình làm bài của sinh viên theo quy ước tidyverse mà Wickham và Grolemund (2017) mô tả, gồm đúng các bước Extract, Transform, Load (ETL) nằm sau phần lớn các bảng điều khiển Business Intelligence (BI). Wickham và Grolemund nói rõ mục đích của bước trực quan hoá: "A good visualisation will show you things that you did not expect, or raise new questions about the data" (Wickham & Grolemund, 2017), tức một biểu đồ tốt cho bạn thấy điều bạn không ngờ tới, hoặc đặt ra câu hỏi mới về dữ liệu, và người chấm cũng áp đúng thước đó cho biểu đồ trong bài nộp. Từ đó có hai hệ quả thực tế. Sinh viên chưa từng lập trình thường đánh giá quá cao phần điểm bị đe doạ bởi code vụng, còn sinh viên đã có nền lập trình lại hay đầu tư quá nhiều vào code gọn đẹp mà viết quá ít cho phần diễn giải. Cả hai nhóm cùng đọc sai một bảng tiêu chí, chỉ là sai theo hai hướng ngược nhau.
Hai bài nộp dùng chung một tập dữ liệu. Bài thứ nhất có code gọn, chú thích đầy đủ, chạy hiệu quả, kèm ba đoạn diễn giải. Bài thứ hai có code ở mức làm được việc, kèm hai trang giải thích dạng dữ liệu đó có ý nghĩa gì với doanh nghiệp, gồm cả những chỗ nó có thể không còn đúng. Bài thứ hai được điểm cao hơn, dù tác giả của nó mới là người lo lắng hơn về khả năng lập trình của mình.
Nên bố cục phần báo cáo thế nào?
Trả lời thẳng: Hãy mở đầu bằng phát hiện chính rồi mới chứng minh nó. Làm phân tích xong, người viết thường muốn kể lại quy trình theo đúng thứ tự thời gian, nhưng cách sắp xếp đó chôn mất câu duy nhất mà người đọc cần. Đặt phát hiện lên trước thì phần quy trình tự trở thành bằng chứng đi kèm.
Một bố cục phù hợp ở năm nhất gồm năm phần. Mở đầu là quyết định hoặc câu hỏi bạn đang xử lý và lý do nó quan trọng, viết ngắn. Tiếp theo là phát hiện chính, phát biểu thẳng trong một hoặc hai câu. Sau đó là phần bằng chứng, tức các biểu đồ và phân tích đỡ cho phát hiện đó, trong đó thành phần nào có mặt cũng phải làm một việc cụ thể. Rồi tới khuyến nghị, cụ thể tới mức ai đó có thể bắt tay làm ngay trong quý này. Cuối cùng là phần giới hạn, nói rõ dữ liệu của bạn không trả lời được điều gì và điều gì sẽ làm kết luận thay đổi.
Chuẩn đầu ra về truyền đạt cho các nhóm liên quan là lý do trật tự này quan trọng. Người đọc trong doanh nghiệp đọc đoạn đầu rồi lướt phần còn lại, nên một báo cáo tới trang thứ tư mới nêu phát hiện là báo cáo gần như chưa truyền đạt được cho ai. Cũng nên lưu ý rằng phần giới hạn là chỗ sinh viên năm nhất hay bỏ lỡ điểm dễ nhất, vì thừa nhận phân tích của mình không cho thấy được điều gì lại được người chấm đọc là có phán đoán chứ không phải là điểm yếu.
Một báo cáo mở đầu bằng khâu làm sạch dữ liệu, chuyển sang chọn biến, rồi tới dựng mô hình, và mãi tới đoạn cuối mới nêu khuyến nghị. Nội dung đã đủ, chỉ có trật tự là lộn ngược. Đưa khuyến nghị lên đầu và coi phần quy trình là bằng chứng đi kèm, bài vẫn là tài liệu đó nhưng đọc lên khác hẳn.
Sinh viên Việt Nam hay mất điểm ở đâu?
Trả lời thẳng: Sinh viên Việt thường mất điểm vì rào đón mà không nêu rõ phạm vi của khẳng định, và vì giữ giọng lịch sự trong khi đề bài đòi một lập trường. Cả hai lỗi đều lộ ra ở phần khuyến nghị, đúng chỗ người chấm kiểm xem bạn có dám cam kết vào một khẳng định bảo vệ được hay không.
Chuẩn đầu ra đòi có khuyến nghị, nên một khuyến nghị né tránh chuyện nên làm gì là khuyến nghị chưa đạt. Điểm cân bằng nằm ở một khẳng định có kèm điều kiện, nghĩa là nêu hành động, nêu bằng chứng mà hành động đó dựa vào, và nêu hoàn cảnh nào sẽ khiến nó sai. Làm như vậy không phải là rào đón mà là xác định phạm vi. Nếu hành động đó tác động tới một Key Performance Indicator (KPI), tức chỉ số hiệu quả chính mà doanh nghiệp đang theo dõi, hãy gọi tên chỉ số ấy và nối mức thay đổi kỳ vọng với Return on Investment (ROI), tức lợi tức trên khoản đầu tư.
Một đoạn kết viết rằng công ty "có lẽ nên cân nhắc xem xét cải thiện hoạt động marketing ở một số phân khúc". Khi viết lại, đoạn đó khuyến nghị chuyển ngân sách sang phân khúc có tỷ lệ chuyển đổi quan sát được cao nhất, ghi chú rằng quan sát này chỉ trải qua hai quý, và cảnh báo rằng yếu tố mùa vụ có thể giải thích một phần kết quả. Bản thứ hai cam kết vào một điều cụ thể, mà lại dễ bảo vệ hơn chứ không khó hơn.
Về thuật ngữ, hãy giữ nguyên các từ tiếng Anh cho chính xác. Correlation (tương quan), causation (quan hệ nhân quả), accuracy, precision và recall đều có nghĩa riêng, và một cách dịch lỏng sang tiếng Việt thường ngày sẽ xoá mất đúng những phân biệt mà bảng tiêu chí đang kiểm tra.
Nên chuẩn bị thế nào trong suốt kỳ học?
Trả lời thẳng: Hãy luyện phần diễn giải có chủ đích như khi luyện code, vì trong hai kỹ năng đó chỉ có code là được ôn tự nhiên qua bài tập hằng tuần. Phần diễn giải thì phải tự đặt ra thói quen riêng, nếu không tới bài đánh giá lớn bạn sẽ có nhiều biểu đồ mà rất ít câu nói được biểu đồ ấy có nghĩa gì.
Một nhịp làm việc hiệu quả là mỗi tuần, sau khi xong bài tập kỹ thuật, bạn viết thêm hai câu nói rằng một người quản lý nên làm gì khác đi vì kết quả đó. Giữ lại những câu này, vì tới giữa kỳ bạn sẽ có một kho diễn giải và nhìn rõ câu nào trong đó là rỗng. Trước bài đánh giá lớn, hãy lấy bất kỳ biểu đồ nào bạn đã vẽ và thử phát biểu insight của nó mà không mô tả nó. Nếu chưa phát biểu được thì biểu đồ ấy chưa gánh được lập luận nào.
Cấu trúc và trọng số bài đánh giá thay đổi theo từng kỳ, và căn cứ có thẩm quyền là course outline của chính bạn, do Business School công bố trước khi bắt đầu giảng dạy. Điều không thay đổi là việc bảng tiêu chí luôn quan tâm tới phần diễn giải, vì yêu cầu đó được viết thẳng vào chuẩn đầu ra chứ không nằm trong một bài cụ thể nào.
Mentor MAAS thật sự làm gì ở môn này?
Trả lời thẳng: MAAS làm việc với vai trò cố vấn học thuật, và buổi trao đổi hữu ích nhất ở một môn như thế này thường rất ngắn: bạn mang tới một biểu đồ hoặc một kết quả mô hình, còn mentor hỏi một người quản lý nên làm gì khác đi vì nó. Bạn tự viết code, tự viết báo cáo và tự nộp bài của mình.
Nếu câu trả lời cho câu hỏi đó cần hơn một câu thì phân tích chưa chạm tới đích. Từ đó, công việc diễn ra như thường lệ: mentor đọc bản nháp của bạn đối chiếu với tiêu chí của môn, kiểm xem từng biểu đồ có đang làm việc của nó không, và xem khuyến nghị của bạn đã đủ cụ thể để hành động chưa.
Câu hỏi thường gặp
COMM1190 bao nhiêu tín chỉ và mở vào kỳ nào?
Môn có sáu đơn vị tín chỉ, mở ở cả ba kỳ giảng dạy của UNSW tại cơ sở Kensington, do UNSW Business School phụ trách, cũng là nơi phụ trách COMM1110.
Chưa biết lập trình có học được không?
Được. Môn dạy R từ đầu như một công cụ phân tích, và R cũng là kỹ năng thực hành đứng sau phần lớn công việc Business Intelligence (BI). Sinh viên chưa có nền lập trình thường đánh giá quá cao phần điểm phụ thuộc vào chất lượng code.
COMM1190 liên quan gì tới COMM1110?
COMM1190 xây trực tiếp trên nền Evidence-based Problem Solving, môn giới thiệu các công cụ thống kê cơ bản như Confusion Matrix và vai trò của bằng chứng. Nếu phần đó còn chưa chắc, hãy ôn lại từ sớm thay vì đợi tới tuần nộp bài.
Đây có phải môn toán không?
Không. Đây là môn về ra quyết định có dùng các công cụ thống kê như AUC và RMSE. Bạn cần diễn giải đúng kết quả định lượng, và đó là yêu cầu khác với việc tự chứng minh ra chúng.
Môn chấm điểm thế nào?
Dạng bài và trọng số thay đổi giữa các kỳ, và course outline của chính bạn là căn cứ. Dù chia thế nào, chuẩn đầu ra vẫn khiến phần diễn giải và truyền đạt được chấm ở mọi bài.
Biểu đồ của mình trông đơn giản quá, có bị trừ điểm không?
Ít hơn bạn nghĩ nhiều, kể cả khi đặt cạnh chuẩn mà Edward Tufte và Leland Wilkinson đề ra. Một biểu đồ đơn giản gánh được lập luận sẽ tốt hơn một biểu đồ cầu kỳ không gánh gì, và sự cầu kỳ chỉ để cầu kỳ còn đi ngược lại tính rõ ràng mà chuẩn đầu ra đòi hỏi.
Bài liên quan
- ISYS3453: hướng dẫn bài phân tích dữ liệu
- Cách viết báo cáo đại học
- Hỗ trợ dự án dữ liệu và lập trình cùng MAAS
Trao đổi với mentor MAAS về môn học của bạn
References
Provost, F., & Fawcett, T. (2013). Data science for business: What you need to know about data mining and data-analytic thinking. O'Reilly Media.
Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
Wickham, H., & Grolemund, G. (2017). R for data science: Import, tidy, transform, visualize, and model data. O'Reilly Media.
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer.