
◆ Phương pháp nghiên cứu
AI cho literature review: công cụ nào giúp, ở bước nào?
Trả lời thẳng: AI cho literature review giúp tốt ở khâu sàng lọc và trích xuất dữ liệu, nhưng không đáng tin để cung cấp nguồn cho bạn. Walters và Wilder (2023) ghi nhận chatbot bịa 55% trích dẫn của GPT-3.5 và 18% của GPT-4, còn Chelli và cộng sự (2024) ghi nhận 28,6% bài báo của GPT-4 là ảo. Hãy dùng công cụ, rồi kiểm tra từng bài.
Hãy hình dung khoảnh khắc trước khi bạn dán hai mươi tài liệu do một mô hình ngôn ngữ lớn gợi ý vào bản thảo. Các cuộc kiểm toán đã công bố cho phép bạn đặt giá cho khoảnh khắc đó, và mức giá nằm đâu đó giữa khoảng bốn và mười một tài liệu không hề tồn tại. Các mục dưới đây đưa ra số liệu đã kiểm cho từng giai đoạn của một bài tổng quan, rồi ba phần phương pháp bạn có thể dùng lại: phép tính lỗi kỳ vọng, một dòng trích xuất và một chuỗi tìm kiếm ba khối.
◆ Câu hỏi 1 / 5 · Bịa tài liệu
AI cho literature review có bịa tài liệu tham khảo không?
Trả lời thẳng: Có, và tỉ lệ cao tới mức bạn không nên tin bất kỳ gợi ý nào trước khi tự tra. Theo Walters và Wilder (2023), 55% trích dẫn mà GPT-3.5 sinh ra và 18% mà GPT-4 sinh ra không hề tồn tại, còn theo Chelli và cộng sự (2024) tỉ lệ ảo dao động từ 28,6% đến 91,4%. Hãy tra từng bài trong cơ sở dữ liệu.
Walters và Wilder (2023) nhờ ChatGPT viết các bài tổng quan ngắn về 42 chủ đề, kết quả là 84 bài và 636 trích dẫn, rồi tra từng trích dẫn trong các cơ sở dữ liệu. Trong số bài có thật, 43% trích dẫn của GPT-3.5 và 24% của GPT-4 vẫn chứa lỗi đáng kể. Nhóm tác giả giải thích nguyên nhân bằng một câu: ChatGPT "về bản chất không phải công cụ xử lý thông tin mà là công cụ xử lý ngôn ngữ" (câu gốc tiếng Anh nằm ở bài của họ, phần dịch là của chúng tôi). Hiện tượng rộng hơn này có tên riêng là hallucination.
Chelli và cộng sự (2024) chạy một phép thử khó hơn với 11 systematic review đã công bố, 33 prompt và 471 tài liệu. GPT-3.5 tìm được 13 trong 109 bài mà các nhóm người đã đưa vào (11,9%), GPT-4 tìm được 15 (13,7%), còn Bard không tìm được bài nào, trong khi 91,4% của 104 bài Bard đề xuất là ảo. Nhóm tác giả kết luận rằng "it is not recommended for LLMs to be deployed as the primary or exclusive tool for conducting systematic reviews" (Chelli và cộng sự, 2024), tức là không nên dùng mô hình ngôn ngữ làm công cụ chính hay duy nhất cho một systematic review.
Ví dụ làm mẫu: 20 gợi ý đáng giá bao nhiêu. Giả sử một chatbot liệt kê 20 tài liệu. Theo tỉ lệ của Walters và Wilder, GPT-3.5 cho 20 × 0,55 = 11 bài bịa, còn lại 9 bài thật, trong đó 9 × 0,43 = 3,9 bài có lỗi, nên khoảng 5 bài sạch. GPT-4 cho 20 × 0,18 = 3,6 bài bịa, còn lại 16,4 bài thật, trong đó 16,4 × 0,24 = 3,9 bài có lỗi, nên khoảng 12 bài sạch. Đây là phép tính của chúng tôi dựa trên tỉ lệ của họ, không phải kết quả họ báo cáo, và prompt của bạn có thể cho kết quả khác.
◆ Câu hỏi 2 / 5 · Công cụ nào, bước nào
Công cụ AI cho literature review nào hợp với bước nào?
Trả lời thẳng: Hãy ghép từng công cụ AI cho literature review với đúng bước, và đặt mức tin cậy theo bằng chứng đứng sau nó. Công cụ sàng lọc và trích xuất có bài kiểm đã công bố, công cụ vẽ bản đồ chủ yếu chỉ có hướng dẫn của thư viện, và chưa nguồn nào chúng tôi đọc kiểm tra AI tổng hợp. Lời tự giới thiệu của công cụ không phải kết quả về độ chính xác.
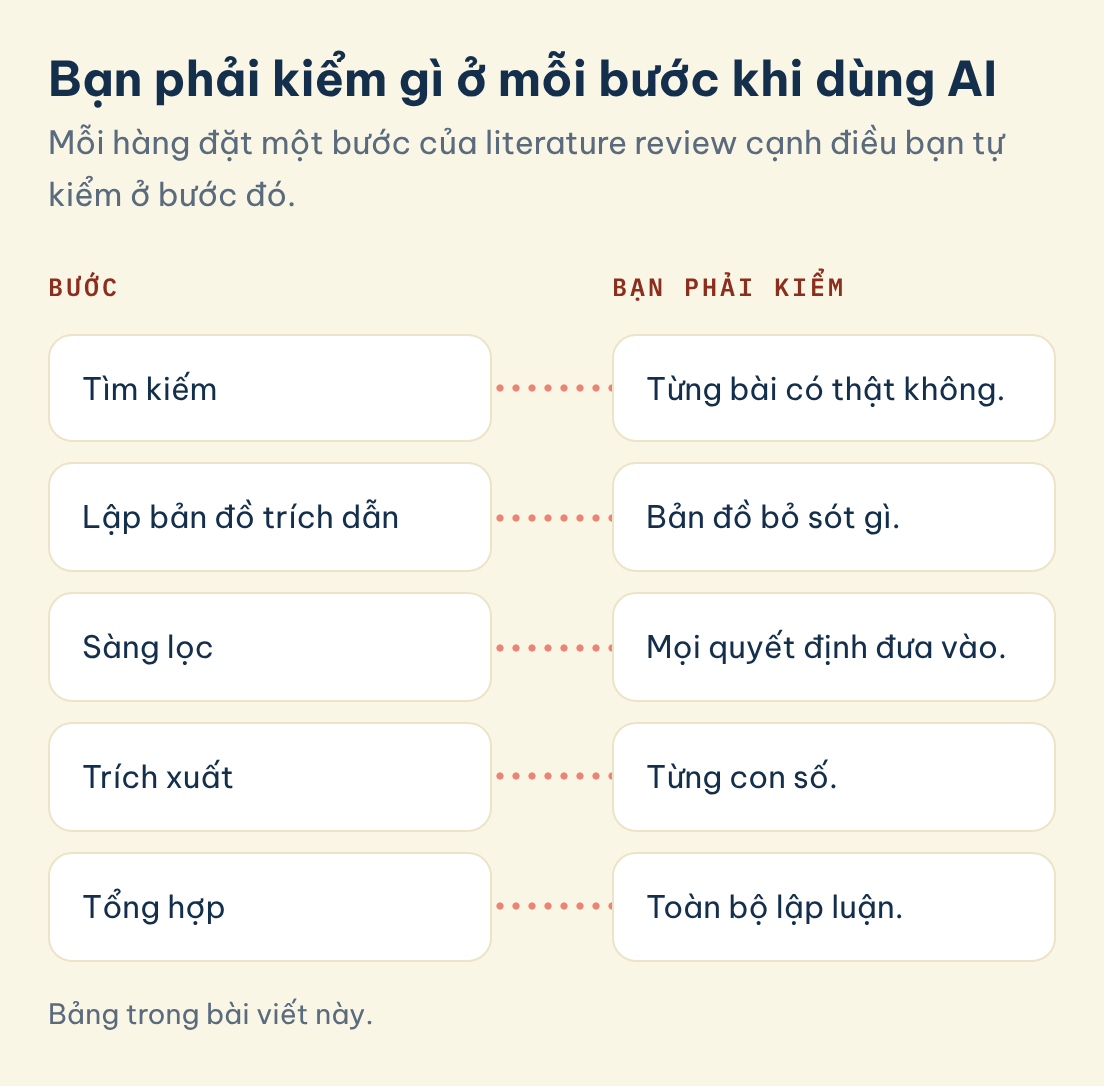
Bạn phải kiểm gì ở mỗi bước khi dùng AI
Mỗi hàng đặt một bước của literature review cạnh điều bạn tự kiểm ở bước đó.
Bước
Bạn phải kiểm
Tìm kiếm
Từng bài có thật không.
Lập bản đồ trích dẫn
Bản đồ bỏ sót gì.
Sàng lọc
Mọi quyết định đưa vào.
Trích xuất
Từng con số.
Tổng hợp
Toàn bộ lập luận.
Lưu hình này
| Bước | Công cụ ví dụ | Bằng chứng chúng tôi đọc | Bạn phải kiểm |
|---|---|---|---|
| Tìm kiếm | Semantic Scholar, Consensus, Elicit | Các cuộc kiểm toán chatbot ở trên | Từng bài có thật không |
| Lập bản đồ trích dẫn | ResearchRabbit, Litmaps | Chỉ có hướng dẫn thư viện | Bản đồ bỏ sót gì |
| Sàng lọc | Rayyan, ASReview | Bài kiểm của nhà phát triển | Mọi quyết định đưa vào |
| Trích xuất | Elicit | Một bài kiểm độc lập | Từng con số |
| Tổng hợp | Không có | Không tìm thấy | Toàn bộ lập luận |
Nguồn: danh sách công cụ từ hướng dẫn thư viện của Cambridge và Bath, cột bằng chứng lấy từ các nghiên cứu trích trong bài, đọc ngày 31 tháng 10 năm 2026.
Bằng chứng về sàng lọc đến từ chính nhà phát triển. Ouzzani và cộng sự (2016) thử nghiệm beta Rayyan trên hai bài tổng quan của Cochrane với 1.030 và 273 bản ghi, và bài lớn hơn cần nhiều vòng lặp mới tìm ra 11 thử nghiệm đã biết. Những người trả lời khảo sát cho biết tiết kiệm trung bình 40% thời gian, và 34% cho biết hơn 50%, đây là ý kiến người dùng chứ không phải kết quả đo bằng đồng hồ. van de Schoot và cộng sự (2021) cho biết active learning "có thể giúp việc rà soát hiệu quả hơn hẳn làm thủ công mà vẫn giữ chất lượng cao", dựa trên mô phỏng chính phần mềm ASReview của họ, vốn áp dụng active learning. Quy tắc dừng nằm trong bài AI sàng lọc trong systematic review hoạt động thế nào.
◆ Câu hỏi 3 / 5 · Độ chính xác khi trích xuất
AI trích xuất dữ liệu từ nghiên cứu chính xác đến đâu?
Trả lời thẳng: AI cho literature review gần bằng người ở khâu trích xuất, nhưng chưa bằng. Hilkenmeier và cộng sự (2025) so Elicit với người trên 43 nghiên cứu và 602 điểm dữ liệu: Elicit đạt độ chính xác 81,4% so với 86,7% của người, chênh lệch không có ý nghĩa thống kê. Hãy dùng nó như người rà soát thứ hai, không phải người đầu tiên.
Hilkenmeier và cộng sự (2025) chấm cả hai bên theo một chuẩn đồng thuận trong một bài tổng quan về các yếu tố tâm lý trong bệnh da liễu. Theo nhóm tác giả, sự đồng thuận giữa người và máy "có thể là một chỉ báo đáng tin cho tính đúng", vì mỗi khi Elicit và người trích xuất cùng một thông tin thì thông tin đó đúng trong 100% trường hợp.
Quy ra số lượng, 86,7% của 602 điểm là khoảng 522 giá trị đúng ở phía người, còn 81,4% là khoảng 490 ở phía Elicit, nghĩa là Elicit sai hoặc sót nhiều hơn người khoảng 32 giá trị. Khoảng cách đó chỉ chấp nhận được nếu vẫn có một người xem lại mọi chỗ hai bên bất đồng. Một bài tổng quan, một lĩnh vực và một nghiên cứu thử nghiệm ý tưởng chưa chứng minh kết quả tương tự ở ngành của bạn.
Ví dụ làm mẫu: một dòng trích xuất bạn có thể sao chép cách làm. Hãy chốt các cột trước khi bất kỳ công cụ nào chạm vào bài báo, rồi điền cùng các cột đó cho mọi nghiên cứu.
| Nghiên cứu | Mẫu | Phương pháp | Thước đo | Phát hiện |
|---|---|---|---|---|
| Hilkenmeier và cộng sự (2025) | 43 nghiên cứu, 602 điểm dữ liệu | Elicit so với trích xuất thủ công, chuẩn đồng thuận | Độ chính xác | 81,4% so với 86,7% |
Con số nào bạn không truy được về một trang của bài báo thì không thuộc về bảng này.
◆ Câu hỏi 4 / 5 · Tìm kiếm nằm ở đâu
Việc tìm kiếm nên nằm ở đâu khi bạn dùng AI?
Trả lời thẳng: Trong một cơ sở dữ liệu có tài liệu rõ ràng mà bạn chạy lại được, kèm chuỗi tìm kiếm chính xác và ngày thực hiện. Gusenbauer và Haddaway (2020) kiểm 28 hệ thống tìm kiếm học thuật và thấy chỉ một nửa đủ điều kiện dùng cho evidence synthesis mà không kèm cảnh báo nghiêm trọng. AI cho literature review chỉ thêm gợi ý vào hồ sơ đó, không thay thế nó.
Gusenbauer và Haddaway (2020) kiểm 28 hệ thống và kết luận rằng chỉ một nửa số hệ thống được phân tích và chỉ vài cơ sở dữ liệu truy cập mở có thể được khuyến nghị cho evidence synthesis mà không kèm cảnh báo đáng kể. Cochrane Handbook (Lefebvre và cộng sự, 2025) nêu rằng CENTRAL và MEDLINE, cùng Embase khi có quyền truy cập, cần được tìm cho mọi tổng quan của Cochrane, và "chiến lược tìm kiếm nên hướng tới độ nhạy cao, điều có thể làm độ chính xác tương đối thấp". Hướng dẫn thư viện của University of Cambridge (n.d.) cho biết thư viện có quyền truy cập 1.767 cơ sở dữ liệu vào lúc viết, còn University College London (n.d.) cảnh báo các trợ lý tìm kiếm AI "không cho phép tìm kiếm toàn diện hay có hệ thống" (hướng dẫn của UCL).
Ví dụ làm mẫu: chuỗi tìm kiếm ba khối. Cochrane khuyên dùng ít khái niệm và nhiều từ nối OR trong mỗi khái niệm. Với câu hỏi "Retrieval practice có cải thiện kết quả thi của sinh viên đại học không?", hãy viết: ("undergraduate*" OR "university student*" OR "college student*") AND ("retrieval practice" OR "practice test*" OR "testing effect") AND ("exam*" OR "test performance" OR "academic achievement"). Hãy nhờ chatbot gợi ý thêm từ đồng nghĩa cho mỗi khối, rồi thử từng từ trong cơ sở dữ liệu và chỉ giữ nếu số kết quả thay đổi. Mỗi lần đều ghi lại cơ sở dữ liệu, ngày, chuỗi và số kết quả. Bản đồ công cụ rộng hơn nằm trong bài công cụ AI và nghiên cứu xuyên suốt một dự án.
◆ Câu hỏi 5 / 5 · Viết phần tổng hợp
AI cho literature review có viết được phần tổng hợp không?
Trả lời thẳng: Chưa nguồn nào chúng tôi đọc kiểm tra một công cụ làm được việc này, nên bạn hãy tự viết. Tổng hợp nghĩa là so sánh các nghiên cứu và giải thích vì sao chúng khác nhau, điều đó tuỳ thuộc câu hỏi của bạn. Một đoạn trôi chảy dựng trên những bản tóm tắt chưa kiểm có thể trông như tổng hợp trong khi chẳng dựa vào đâu.
Một đoạn tổng hợp đưa ra một nhận định, đặt các nghiên cứu cạnh nhau, giải thích khác biệt và nêu điều rút ra. Dưới đây là đoạn mẫu dựng từ các cuộc kiểm toán ở trên:
Hai cuộc kiểm toán cùng hướng nhưng khác độ lớn. Walters và Wilder (2023) thấy 55% trích dẫn của GPT-3.5 và 18% của GPT-4 là bịa trong 636 trích dẫn, trong khi Chelli và cộng sự (2024) thấy hiện tượng ảo ở 39,6% và 28,6% trong 471 tài liệu. Khoảng cách của GPT-4, 18% so với 28,6%, có thể phản ánh nhiệm vụ, vì các bài tổng quan tự do về 42 chủ đề khác với việc lặp lại 11 systematic review có tiêu chí cố định, và hai nhóm cũng định nghĩa lỗi khác nhau. Cả hai cùng kết luận rằng tài liệu tham khảo cần được kiểm tra, nên mọi kết quả từ AI cho literature review chỉ vào bài tổng quan sau khi đã được xác minh.
Phương pháp là nhận định, so sánh, giải thích, hệ quả, và bạn có thể dùng lại với các nghiên cứu của mình. Các bài của chúng tôi về cách viết literature review và dùng AI có đạo đức trong literature review bàn về cấu trúc, việc được phép và việc khai báo. Phần mềm quản lý tài liệu như Zotero lo định dạng trích dẫn, đó là một việc khác, xem nên chọn phần mềm quản lý tài liệu tham khảo nào.
Câu hỏi thường gặp
Công cụ AI nào tìm được bài báo phù hợp cho literature review?
Semantic Scholar, Consensus và Elicit có thể gợi ý bài báo từ một câu hỏi. Các mô hình GPT chỉ tìm lại được 11,9% đến 13,7% số bài mà người đã đưa vào (Chelli và cộng sự, 2024), nên hãy coi chúng là gợi ý và vẫn tìm trong cơ sở dữ liệu.
AI có sàng lọc được tiêu đề và abstract cho systematic review không?
Một phần. ASReview dùng active learning và Rayyan dùng mô hình dự đoán để đưa bản ghi có khả năng phù hợp lên đầu. Bằng chứng đã công bố chủ yếu đến từ nhà phát triển (van de Schoot và cộng sự, 2021, Ouzzani và cộng sự, 2016), nên bạn vẫn tự quyết định mọi bản ghi được đưa vào.
AI trích xuất dữ liệu từ nghiên cứu chính xác đến đâu?
Trong bài kiểm độc lập duy nhất chúng tôi tìm được, Elicit đạt 81,4% so với 86,7% của người trên 602 điểm dữ liệu (Hilkenmeier và cộng sự, 2025). Hãy dùng nó như người rà soát thứ hai và kiểm lại các chỗ bất đồng.
Công cụ nào vẽ bản đồ trích dẫn giữa các bài báo?
ResearchRabbit, Connected Papers và Litmaps vẽ bản đồ từ những bài bạn chọn. Chúng được mô tả bằng hướng dẫn thư viện chứ không phải bài kiểm độ chính xác, nên hãy đối chiếu bản đồ với một bài mà bạn đã biết rõ các trích dẫn.
AI có viết được phần tổng hợp của literature review không?
Chúng tôi không tìm thấy bài kiểm nào cho thấy là có. Hãy tự viết phần so sánh và dùng đoạn mẫu ở trên làm khuôn.
Bạn muốn một chuyên gia thử lập luận literature review của mình?
AI cho literature review rút ngắn việc săn bài báo, nhưng người chấm đọc bài tổng quan để xem bạn dựng được lập luận nào từ chúng. Cố vấn học thuật MAAS ghép bạn với một chuyên gia cùng ngành, người huấn luyện bạn theo từng giai đoạn, còn bạn tự nghiên cứu và tự viết từng chữ. Dịch vụ không gắn mục tiêu điểm và không hoàn tiền theo kết quả, và nếu chưa hợp thì MAAS sắp xếp đổi chuyên gia. Buổi tư vấn 20 phút là miễn phí.
Bài hướng dẫn liên quan
- Công cụ AI và nghiên cứu nào giúp ở từng giai đoạn của một dự án?: bản đồ đầy đủ mà bài này thu hẹp lại
- AI sàng lọc trong systematic review hoạt động thế nào?: chi tiết đằng sau bước sàng lọc
- Dùng AI có đạo đức trong literature review như thế nào?: chỗ nào sự hỗ trợ kết thúc và vi phạm bắt đầu
- Viết literature review như thế nào?: biến nguồn thành lập luận
- Nên dùng phần mềm quản lý tài liệu tham khảo nào cho luận văn?: so sánh Zotero, Mendeley, EndNote và JabRef
Tài liệu tham khảo
- Chelli, M., Descamps, J., Lavoué, V., Trojani, C., Azar, M., Deckert, M., Raynier, J.-L., Clowez, G., Boileau, P., & Ruetsch-Chelli, C. (2024). Hallucination rates and reference accuracy of ChatGPT and Bard for systematic reviews: Comparative analysis. Journal of Medical Internet Research, 26, Article e53164. https://doi.org/10.2196/53164
- Gusenbauer, M., & Haddaway, N. R. (2020). Which academic search systems are suitable for systematic reviews or meta-analyses? Evaluating retrieval qualities of Google Scholar, PubMed, and 26 other resources. Research Synthesis Methods, 11(2), 181–217. https://doi.org/10.1002/jrsm.1378
- Hilkenmeier, F., Pelzer, M., Stierle, C. M. G., & Fink-Lamotte, J. (2025). Evaluating the AI tool "Elicit" as a semi-automated second reviewer for data extraction in systematic reviews: A proof-of-concept. Social Science Computer Review. https://doi.org/10.1177/08944393251404052
- Lefebvre, C., Glanville, J., Briscoe, S., Featherstone, R., Littlewood, A., Metzendorf, M.-I., Noel-Storr, A., Paynter, R., Rader, T., Thomas, J., & Wieland, L. S. (2025). Chapter 4: Searching for and selecting studies. In J. P. T. Higgins, J. Thomas, J. Chandler, M. Cumpston, T. Li, M. J. Page, & V. A. Welch (Eds.), Cochrane handbook for systematic reviews of interventions (Version 6.5.1). Cochrane. https://www.cochrane.org/authors/handbooks-and-manuals/handbook/current/chapter-04
- Ouzzani, M., Hammady, H., Fedorowicz, Z., & Elmagarmid, A. (2016). Rayyan: A web and mobile app for systematic reviews. Systematic Reviews, 5, Article 210. https://doi.org/10.1186/s13643-016-0384-4
- University College London. (n.d.). AI and GenAI tools for searching and assisting with research. https://library-guides.ucl.ac.uk/generative-ai/genai-search-tools
- University of Cambridge. (n.d.). AI tools to support your research. https://libguides.cam.ac.uk/AI/tools
- van de Schoot, R., de Bruin, J., Schram, R., Zahedi, P., de Boer, J., Weijdema, F., Kramer, B., Huijts, M., Hoogerwerf, M., Ferdinands, G., Harkema, A., Willemsen, J., Ma, Y., Fang, Q., Hindriks, S., Tummers, L., & Oberski, D. L. (2021). An open source machine learning framework for efficient and transparent systematic reviews. Nature Machine Intelligence, 3(2), 125–133. https://doi.org/10.1038/s42256-020-00287-7
- Walters, W. H., & Wilder, E. I. (2023). Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, Article 14045. https://doi.org/10.1038/s41598-023-41032-5
Bài viết này thuộc chuỗi MAAS Journal dành cho sinh viên. MAAS là đối tác hỗ trợ học thuật: chuyên gia hướng dẫn sinh viên qua từng giai đoạn công việc của chính các bạn, và chúng tôi không làm thay bài được chấm điểm của sinh viên.
Buổi tư vấn miễn phí 20 phút là một cuộc trao đổi về hoàn cảnh của bạn và bài literature review của bạn.
Đặt lịch tư vấn miễn phí ▸