
Để dùng AI sàng lọc nghiên cứu cho một tổng quan hệ thống (systematic review), bạn để công cụ học máy xếp hạng các tiêu đề và tóm tắt mà lượt tìm kiếm trả về, đọc trước những bản ghi nhiều khả năng liên quan nhất, còn quyết định nhận hay loại từng nghiên cứu vẫn do hai người rà soát đưa ra. Bài viết này giúp bạn chọn công cụ phù hợp, hiểu AI sàng chính xác tới đâu, dựng một quy trình sàng lọc không phá chuẩn của Cochrane và PRISMA, và báo cáo cách dùng AI sao cho phản biện của tạp chí Scopus Q1/Q2 tin vào tổng quan của bạn.
Với nhà nghiên cứu Việt và người dùng tiếng Anh như ngôn ngữ thứ hai (ESL) đang làm tổng quan hệ thống hay meta-analysis lần đầu, các công cụ này có thể rút nhiều tuần sàng tay xuống còn vài ngày. Điều đó chỉ đúng khi công cụ giúp tăng tốc một quy trình minh bạch, bám chuẩn, chứ không thay phán đoán của con người. Bài trả lời bảy câu hỏi mà nhà nghiên cứu Việt hay hỏi cố vấn công bố của MAAS nhất về chuyện này.
Tác giả: Ban Biên tập MAAS
Cập nhật lần cuối: 2026-06-21
Chuyên mục: research-methods
Sàng lọc bằng AI thực chất làm gì trong một tổng quan hệ thống?
Trả lời trực tiếp: Công cụ đọc tiêu đề và tóm tắt mà lượt tìm kiếm trả về, rồi dự đoán khả năng liên quan của từng bản ghi, nên bạn xem những nghiên cứu triển vọng nhất trước và chốt tập nghiên cứu sớm hơn. Nó hỗ trợ ở chặng sàng tiêu đề và tóm tắt, chứ không thiết kế đề cương (protocol), không đánh giá chất lượng nghiên cứu, cũng không tự quyết bài nào đủ điều kiện.
Bằng chứng: O'Mara-Eves và cộng sự (2015), trong một tổng quan hệ thống về các cách tiếp cận khai phá văn bản (text mining), cho thấy tự động hoá khâu nhận diện nghiên cứu có thể giảm đáng kể khối lượng sàng lọc mà vẫn giữ độ bao phủ (recall) cao. Nhóm tác giả đặt các phương pháp này ở vai trò hỗ trợ ra quyết định chứ không thay thế người rà soát. Về sau, Marshall và Wallace (2019) viết một hướng dẫn thực hành và gom các công cụ đã đủ độ chín thành hai việc mà người rà soát giao cho máy, là ưu tiên những bản ghi liên quan và giảm số bản ghi phải đọc bằng tay.
Ví dụ: Một học viên cao học người Việt được MAAS đồng hành có lượt tìm kiếm trả về hơn 4.000 bản ghi, và học viên đó mặc định rằng mình phải đọc tay từng tóm tắt. Cố vấn đặt lại vấn đề, rằng một công cụ học chủ động (active learning) sẽ đẩy các nghiên cứu nhiều khả năng liên quan lên sớm để bạn ấy dừng lại khi không còn bài liên quan mới. Cách đó rút khoảng ba tuần đọc, theo ước tính, xuống còn chừng năm ngày.
Người rà soát thực sự dùng những công cụ AI nào?
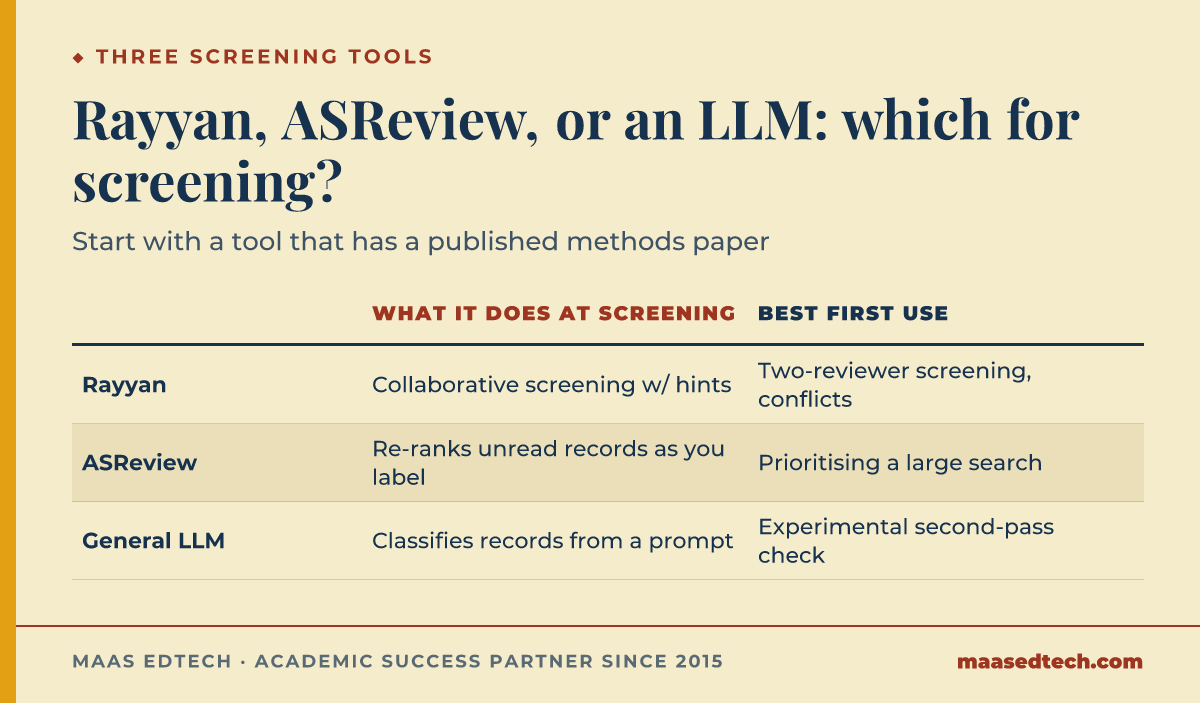
Trả lời trực tiếp: Các nhóm tổng hợp bằng chứng chủ yếu dùng vài công cụ đã có chỗ đứng. Rayyan cho phép nhiều người sàng chung tiêu đề và tóm tắt, có gợi ý mức liên quan. ASReview dùng học chủ động để xếp lại bản ghi khi bạn gán nhãn. Mô hình ngôn ngữ lớn đa dụng thì mới, ít được kiểm chứng hơn. Hãy bắt đầu với công cụ có bài báo phương pháp và quy trình minh bạch.
Bằng chứng: Ouzzani và cộng sự (2016) giới thiệu Rayyan là một ứng dụng web và di động miễn phí, được dựng để tăng tốc vòng sàng tiêu đề và tóm tắt ban đầu bằng bán tự động hoá. Van de Schoot và cộng sự (2021) mô tả ASReview là một khung mã nguồn mở, trong đó cơ chế học chủ động xếp lại chồng bản ghi chưa sàng mỗi khi người rà soát gán nhãn cho một bản ghi, và nhóm phát triển cho thấy cách này tìm ra nghiên cứu liên quan sớm hơn hẳn so với đọc theo thứ tự ngẫu nhiên.
Ví dụ: Hai đồng tác giả được MAAS đồng hành chia việc cho nhau. Một người sàng trên Rayyan để dùng tính năng che kết quả giữa hai người (blinding) và xử lý bất đồng, người còn lại đưa đúng bộ bản ghi đó qua ASReview để xác nhận không có nghiên cứu liên quan nào nằm ở cuối hàng đợi. Phần trùng khớp giữa hai lượt cho họ đủ tự tin trước khi khoá tập nghiên cứu được đưa vào.
| Loại công cụ | Làm gì ở khâu sàng lọc | Dùng lần đầu hợp nhất khi nào |
|---|---|---|
| Rayyan | Nhiều người cùng sàng tiêu đề và tóm tắt, kèm gợi ý mức liên quan và chế độ che kết quả | Sàng hai người kèm quy trình xử lý bất đồng |
| ASReview | Học chủ động, xếp lại các bản ghi chưa đọc theo nhãn bạn gán | Ưu tiên một lượt tìm kiếm lớn để tìm ra nghiên cứu liên quan sớm |
| Mô hình ngôn ngữ lớn đa dụng (ví dụ GPT-4) | Phân loại một bản ghi thành nhận hoặc loại từ một câu lệnh (prompt) | Lượt kiểm thử nghiệm ở vòng hai, không phải người sàng duy nhất |
AI sàng tiêu đề và tóm tắt chính xác đến đâu?
Trả lời trực tiếp: Khi dùng để xếp ưu tiên, AI giữ độ bao phủ cao và cắt đáng kể khối lượng đọc, vì bạn đọc tới lúc không còn bài liên quan. Nếu để máy tự loại mà không ai xem lại, độ chính xác kém tin cậy hơn nhiều và phụ thuộc vào chủ đề cùng độ cân bằng dữ liệu. Cách an toàn là giữ bao phủ cao và để người xác nhận mọi ca bị loại.
Bằng chứng: O'Mara-Eves và cộng sự (2015) ghi nhận mức tiết kiệm công sức tiềm năng lớn khi tự động hoá đóng vai xếp ưu tiên thay vì tự loại, đồng thời lưu ý rằng hiệu năng thay đổi theo từng tổng quan và độ bao phủ phải được bảo vệ. Khraisha và cộng sự (2024) đánh giá GPT-4 như một người sàng độc lập và thấy hiệu năng của mô hình tụt dần qua các chặng sau khi hiệu chỉnh cho mức đồng thuận ngẫu nhiên và độ mất cân bằng của tập dữ liệu, dao động từ không đáng kể tới trung bình tuỳ theo có bao nhiêu bản ghi thực sự liên quan.
Ví dụ: Một nghiên cứu sinh người Việt muốn để mô hình ngôn ngữ tự động loại bản ghi. Cố vấn MAAS chỉ cho nghiên cứu sinh đó thấy vấn đề mất cân bằng dữ liệu. Khi chỉ một nhúm trong 3.000 bản ghi là liên quan, một mô hình loại mạnh tay trông có vẻ rất chính xác nhưng vẫn có thể đánh rơi đúng vài nghiên cứu quan trọng nhất, nên họ chỉ dùng AI để xếp hạng và tự mắt xác nhận từng trường hợp bị loại.
Một mô hình ngôn ngữ lớn như GPT-4 có tự sàng được nghiên cứu không?
Trả lời trực tiếp: Chưa, và làm vậy chưa an toàn. Mô hình ngôn ngữ lớn phân loại được tóm tắt, đôi khi ngang người rà soát ở những tác vụ có cấu trúc rõ, nhưng kết quả nhạy với cách viết câu lệnh và với độ mất cân bằng dữ liệu, và mô hình có thể loại một nghiên cứu liên quan bằng giọng rất chắc chắn. Hãy coi nó là ý kiến thứ hai, đừng để nó sàng một mình.
Bằng chứng: Khraisha và cộng sự (2024) thực hiện một đánh giá có đăng ký trước theo kiểu không có người trong vòng lặp (human-out-of-the-loop), và thấy GPT-4 rất nhạy với cách thiết kế câu lệnh và với độ mất cân bằng dữ liệu, còn con số chính xác nổi bật ban đầu tụt xuống sau khi tính tới mức đồng thuận ngẫu nhiên. Một lần loại nhầm nghĩa là thiếu một nghiên cứu, và thiếu nghiên cứu làm lệch phần tổng hợp của bạn. Vì vậy Page và cộng sự (2021), trong tuyên bố PRISMA 2020, vẫn đòi hỏi con người đứng ra quyết định việc chọn nghiên cứu.
Ví dụ: Một khách hàng của dịch vụ Cố vấn Công bố MAAS thử GPT-4 trên 200 tóm tắt mà chị ấy đã tự sàng trước đó. Mô hình đồng ý ở phần lớn trường hợp nhưng loại mất ba nghiên cứu chị ấy đã giữ, trong đó hai bài là trung tâm của meta-analysis. Mô hình có ích ở chỗ nêu ra những chỗ bất đồng để kiểm lại, chứ không có ích ở khâu quyết định cuối cùng.
Dùng AI sàng lọc thế nào mà không phá chuẩn tổng quan hệ thống?
Trả lời trực tiếp: Hãy giữ hai người rà soát độc lập ở chặng sàng tiêu đề và tóm tắt, dùng AI để xếp ưu tiên và làm lộ những chỗ hai người chấm khác nhau, giải quyết bất đồng bằng thảo luận, và không bao giờ để mô hình là lý do duy nhất khiến một nghiên cứu bị loại. AI đổi thứ tự bạn đọc, không đổi độ chặt chẽ của cách bạn quyết định.
Bằng chứng: Trong Cochrane Handbook, Higgins và cộng sự (2024) khuyến nghị hai người rà soát sàng bản ghi độc lập với nhau để giảm nguy cơ loại nhầm những nghiên cứu đủ điều kiện. Page và cộng sự (2021) yêu cầu tác giả nói rõ quy trình chọn nghiên cứu trong PRISMA 2020, gồm số người đã sàng mỗi bản ghi và có dùng công cụ tự động hoá hay không, nên một quy trình có AI hỗ trợ phải báo cáo được chứ không được giấu đi.
Ví dụ: Một nhóm nghiên cứu người Việt do MAAS đồng hành giữ nguyên thiết kế hai người rà soát nhưng thêm ASReview để định thứ tự đọc, và chỉ dừng sau một chuỗi bản ghi không liên quan liên tiếp có độ dài ấn định từ trước. Mọi nghiên cứu bị loại vẫn có một lý do do người rà soát ghi lại, đúng thứ mà phản biện về phương pháp của một tạp chí Q1 chờ đợi.
Báo cáo cách dùng công cụ AI thế nào để phản biện tin tổng quan của bạn?
Trả lời trực tiếp: Hãy nói rõ bạn dùng công cụ nào, ở chặng nào, cho mục đích gì, và con người kiểm soát ra sao. Nêu tên phần mềm và phiên bản, mô tả AI đã xếp ưu tiên hay đã phân loại bản ghi, xác nhận hai người rà soát mới là người quyết định điều kiện chọn, và giải thích cách bạn giữ độ bao phủ. Báo cáo minh bạch biến chuyện dùng AI thành điểm mạnh.
Bằng chứng: Page và cộng sự (2021) viết trong bảng kiểm báo cáo của PRISMA 2020 rằng tác giả cần nói rõ "how many reviewers screened each record and each report retrieved, whether they worked independently, and if applicable, details of automation tools used in the process" (Page et al., 2021), tức có bao nhiêu người rà soát đã sàng mỗi bản ghi và mỗi báo cáo lấy về, họ có làm độc lập không, và nếu có thì chi tiết về công cụ tự động hoá đã dùng. Marshall và Wallace (2019) nhấn mạnh rằng công cụ phải được mô tả đủ chi tiết để người đọc phán đoán được ảnh hưởng của nó lên tính đầy đủ của kết quả, vì tự động hoá không được ghi lại sẽ làm mất lòng tin vào chính lượt tìm kiếm.
Ví dụ: Một tác giả được MAAS đồng hành viết đúng hai câu giản dị trong phần phương pháp. Câu thứ nhất nêu công cụ và phiên bản dùng để xếp ưu tiên sàng lọc, câu thứ hai xác nhận hai người rà soát đã quyết định độc lập về điều kiện chọn và bất đồng do người thứ ba xử lý. Đoạn ngắn và thật thà đó trả lời trước đúng câu hỏi mà phản biện hẳn sẽ nêu nếu không thấy nó.
Nhà nghiên cứu Việt và người học tiếng Anh dùng AI sàng lọc để có công bố đầu tiên thế nào?
Trả lời trực tiếp: Hãy dùng AI để gỡ rào cản khối lượng vốn làm chậm người làm tổng quan lần đầu chưa quen tiếng Anh, đừng dùng nó để thay phần suy nghĩ. Để công cụ xếp thứ tự đọc cho bạn dồn thời gian vào nghiên cứu đáng đọc, soạn tiêu chí chọn thật kỹ từ trước, và ghi chép để báo cáo từ ngày đầu. Kết quả là một tổng quan bảo vệ được, đủ để bạn tự tin nộp.
Bằng chứng: Van de Schoot và cộng sự (2021) cho thấy công cụ học chủ động tìm ra nghiên cứu liên quan sớm, nên người rà soát dừng sớm hơn mà không phải hy sinh độ bao phủ, đúng mức hiệu quả mà một người làm một mình hay một nhóm nhỏ chưa quen tiếng Anh đang cần. Cả Cochrane Handbook của Higgins và cộng sự (2024) lẫn PRISMA 2020 của Page và cộng sự (2021) đều đặt độ tin cậy vào một quy trình chọn nghiên cứu minh bạch do con người dẫn dắt. Vì vậy một nhà nghiên cứu không nói tiếng Anh bản ngữ mà ghi chép đầy đủ quy trình có AI hỗ trợ và do người kiểm soát sẽ cạnh tranh bằng độ chặt chẽ, chứ không phải bằng độ trôi chảy của tiếng mẹ đẻ.
Ví dụ: Một cố vấn MAAS hướng dẫn một sinh viên đại học người Việt dựng một tổng quan hệ thống cho hồ sơ xin học bổng theo mô hình chạy theo từng giai đoạn. Giai đoạn đầu chốt tiêu chí chọn và từ khoá tìm kiếm, giai đoạn giữa dùng ASReview để định thứ tự sàng lọc trong khi hai người sàng quyết định điều kiện chọn, còn giai đoạn cuối là bản viết hoàn chỉnh theo đúng PRISMA. Sinh viên đó giữ vai tác giả xuyên suốt, còn cố vấn góp ý chứ không làm hộ.
Câu hỏi thường gặp
Dùng AI để sàng lọc nghiên cứu có bị coi là vi phạm liêm chính học thuật không?
Không, nếu bạn khai báo và con người vẫn kiểm soát. Dùng phần mềm để xếp thứ tự các tóm tắt bạn sẽ đọc là một cách tăng hiệu quả được chấp nhận, và các hướng dẫn báo cáo còn yêu cầu bạn mô tả mọi công cụ tự động hoá đã dùng. Nó chỉ thành vấn đề khi bạn giấu đi, hoặc để mô hình quyết định điều kiện chọn mà không ai kiểm lại.
AI có thay được người rà soát thứ hai không?
Không. Hướng dẫn phương pháp vẫn đòi hai người rà soát độc lập, vì chỉ một người sàng, dù là người hay mô hình, đều làm tăng nguy cơ loại nhầm nghiên cứu đủ điều kiện. AI nêu ra được những chỗ bất đồng, nhưng tự nó không đáp ứng chuẩn hai người rà soát.
Người làm tổng quan lần đầu nên bắt đầu với công cụ nào?
Phần lớn người mới bắt đầu với Rayyan để sàng tiêu đề và tóm tắt cùng đồng nghiệp, rồi thêm ASReview khi lượt tìm kiếm lớn và học chủ động có thể đẩy nghiên cứu liên quan lên sớm. Cả hai đều có bài báo phương pháp đã công bố, nên dễ trích dẫn và dễ báo cáo.
Tạp chí có từ chối một tổng quan dùng AI sàng lọc không?
Không phải vì bản thân chuyện dùng AI, miễn là bạn báo cáo đầy đủ và con người vẫn quyết định điều kiện chọn. Phản biện phản ứng rất xấu với tự động hoá không được ghi lại, hoặc với việc AI tự loại mà không ai kiểm, nên yếu tố quyết định là tính minh bạch và độ bao phủ, chứ không phải công cụ.
AI sàng lọc thực sự tiết kiệm bao nhiêu thời gian?
Mức tiết kiệm thay đổi theo chủ đề và quy mô tìm kiếm, nhưng công cụ xếp ưu tiên có thể cắt đáng kể một khối lượng sàng lọc lớn bằng cách cho bạn dừng lại khi không còn bài liên quan hiện ra. Phần tiết kiệm đến từ việc đọc ít tóm tắt không liên quan hơn, chứ không đến từ việc bỏ qua quyết định của con người với những bài nằm ở ranh giới.
MAAS có hỗ trợ tôi chạy một tổng quan hệ thống có AI hỗ trợ không?
Có. Cố vấn Công bố của MAAS đồng hành cùng nhà nghiên cứu Việt qua các phần xây tiêu chí chọn, chọn công cụ, dựng quy trình sàng lọc giữ được độ bao phủ, và báo cáo theo chuẩn PRISMA, theo mô hình chạy từng giai đoạn. Bạn có thể đặt lịch tư vấn qua trang liên hệ.
Sẵn sàng chạy một tổng quan hệ thống chặt chẽ có AI hỗ trợ?
Một tổng quan hệ thống được đánh giá ở chỗ phản biện có tin rằng bạn đã tìm và chọn nghiên cứu một cách công bằng hay không, và AI sàng lọc chỉ giúp được khi nằm trong một quy trình minh bạch do con người dẫn dắt. Cố vấn Công bố của MAAS đi cùng bạn qua năm giai đoạn, từ đóng khung câu hỏi nghiên cứu tới phản hồi bình duyệt, và tuyến quốc tế của dịch vụ thường gồm 26 buổi làm việc 1-1 trong khoảng 4 tới 10 tháng. Mỗi cố vấn đều có nhiều bài Q1 hoặc Q2 đứng tên chính mình, và 23% chuyên gia của MAAS có học vị Tiến sĩ. Bạn đặt một buổi tư vấn miễn phí 15 phút, rồi MAAS ghép cố vấn trong vòng 48 giờ khi mạng lưới đã có người phù hợp với lĩnh vực của bạn. Nếu chưa có, MAAS mở một đợt tuyển riêng cho hồ sơ của bạn, và việc này thường mất khoảng hai tuần. Nếu cố vấn được ghép chưa hợp với lĩnh vực hoặc tạp chí bạn nhắm, bạn có thể đề nghị đổi cố vấn. Bạn vẫn là tác giả ở mọi bước, còn quyết định nhận đăng thuộc về ban biên tập của tạp chí.
Đặt lịch tư vấn Cố vấn Công bố cùng MAAS Academic Mentoring →
Bài liên quan
- Thiết kế một tổng quan hệ thống trong khoa học sức khoẻ thế nào?, dựng đề cương mà lượt sàng lọc của bạn chạy bên trong
- Dùng AI có đạo đức trong phần tổng quan tài liệu như thế nào?, giữ việc dùng AI minh bạch và có ghi chép
- Làm sao để một nghiên cứu AI y tế tái lập được cho tạp chí Q1?, chia sẻ mã và thiết lập để quy trình AI chạy lại được
- Làm một nghiên cứu tổng hợp meta-analysis lần đầu thế nào?, bước tổng hợp sau khi sàng lọc xong
- Xác định khoảng trống nghiên cứu cho bài báo của mình thế nào?, đóng khung câu hỏi cho tổng quan của bạn
- Dịch vụ Cố vấn Công bố, các bậc dịch vụ hỗ trợ Scopus Q1/Q2
- Trung tâm tài nguyên Công bố Scopus, lộ trình công bố đầy đủ
- Gặp gỡ chuyên gia MAAS, đội ngũ cố vấn cấp Tiến sĩ đứng sau phần tư vấn của chúng tôi
References
- Higgins, J. P. T., Thomas, J., Chandler, J., Cumpston, M., Li, T., Page, M. J., & Welch, V. A. (Eds.). (2024). Cochrane handbook for systematic reviews of interventions (Version 6.5). Cochrane. Retrieved June 21, 2026, from https://www.cochrane.org/handbook
- Khraisha, Q., Put, S., Kappenberg, J., Warraitch, A., & Hadfield, K. (2024). Can large language models replace humans in systematic reviews? Evaluating GPT-4's efficacy in screening and extracting data from peer-reviewed and grey literature in multiple languages. Research Synthesis Methods, 15(4), 616–626. https://doi.org/10.1002/jrsm.1715
- Marshall, I. J., & Wallace, B. C. (2019). Toward systematic review automation: A practical guide to using machine learning tools in research synthesis. Systematic Reviews, 8, Article 163. https://doi.org/10.1186/s13643-019-1074-9
- O'Mara-Eves, A., Thomas, J., McNaught, J., Miwa, M., & Ananiadou, S. (2015). Using text mining for study identification in systematic reviews: A systematic review of current approaches. Systematic Reviews, 4, Article 5. https://doi.org/10.1186/2046-4053-4-5
- Ouzzani, M., Hammady, H., Fedorowicz, Z., & Elmagarmid, A. (2016). Rayyan—a web and mobile app for systematic reviews. Systematic Reviews, 5, Article 210. https://doi.org/10.1186/s13643-016-0384-4
- Page, M. J., McKenzie, J. E., Bossuyt, P. M., Boutron, I., Hoffmann, T. C., Mulrow, C. D., Shamseer, L., Tetzlaff, J. M., Akl, E. A., Brennan, S. E., Chou, R., Glanville, J., Grimshaw, J. M., Hróbjartsson, A., Lalu, M. M., Li, T., Loder, E. W., Mayo-Wilson, E., McDonald, S. ... Moher, D. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, Article n71. https://doi.org/10.1136/bmj.n71
- Van de Schoot, R., de Bruin, J., Schram, R., Zahedi, P., de Boer, J., Weijdema, F., Kramer, B., Huijts, M., Hoogerwerf, M., Ferdinands, G., Harkema, A., Willemsen, J., Ma, Y., Fang, Q., Hindriks, S., Tummers, L., & Oberski, D. L. (2021). An open source machine learning framework for efficient and transparent systematic reviews. Nature Machine Intelligence, 3(2), 125–133. https://doi.org/10.1038/s42256-020-00287-7
Bài viết này thuộc chuỗi MAAS Journal dành cho học viên cao học và nhà nghiên cứu người Việt đang học tập ở nước ngoài. Cố vấn Công bố của MAAS là một đối tác cố vấn, chúng tôi hướng dẫn tác giả theo mô hình chạy từng giai đoạn với nhận xét phát triển từ các cố vấn cấp Tiến sĩ đã công bố trên Scopus. Chúng tôi không viết hộ, không nộp hộ, và không bảo đảm bài được nhận đăng thay cho tác giả.