
Nhiều người đọc bảng SPSS thấy Std. Error cạnh Std. Deviation mà không phân biệt được, dù việc chọn con số nào ảnh hưởng đến cách người chấm đọc bài.
Cập nhật lần cuối: 2026-09-19
Chuyên mục: research-methods
Sai số chuẩn (standard error) là gì?
Trả lời thẳng: Sai số chuẩn (standard error, viết tắt SE) là độ lệch chuẩn của phân phối lấy mẫu (sampling distribution) của một thống kê, thường gặp nhất là trung bình mẫu. Con số này cho biết mức dao động của thống kê đó nếu quá trình lấy mẫu được lặp lại nhiều lần trên cùng một tổng thể.
Bằng chứng: OpenStax (2020) định nghĩa sai số chuẩn của trung bình mẫu là căn bậc hai của phương sai của phân phối lấy mẫu, ký hiệu σ_x̄. Çetinkaya-Rundel và Hardin (2020) viết lại công thức này theo hướng ước lượng, gọi SE là thước đo biến động của một thống kê mẫu qua nhiều lần lấy mẫu lặp lại. Illowsky và Dean (n.d.) mô tả cùng khái niệm trong bối cảnh định lý giới hạn trung tâm (central limit theorem), nơi trung bình của nhiều mẫu có cùng cỡ mẫu tự phân bố quanh trung bình tổng thể theo một quy luật riêng, và SE chính là độ lệch chuẩn của quy luật phân bố đó.
Ví dụ: Nếu bạn lấy 100 mẫu khác nhau, mỗi mẫu 30 sinh viên, rồi tính điểm trung bình của từng mẫu, 100 con số trung bình đó sẽ không giống hệt nhau. Sai số chuẩn đo mức các con số trung bình này dao động quanh trung bình thật của tổng thể, còn độ lệch chuẩn (SD) trong một mẫu đo mức điểm của từng sinh viên trong mẫu đó phân tán ra sao.
Công thức tính sai số chuẩn như thế nào?
Trả lời thẳng: Khi biết độ lệch chuẩn của tổng thể (σ), công thức là SE = σ chia cho căn bậc hai của cỡ mẫu n. Hiếm khi biết σ thật, nên người ta thay bằng độ lệch chuẩn của mẫu (s), công thức trở thành SE xấp xỉ s chia cho căn bậc hai của n, áp dụng khi cỡ mẫu đủ lớn và dữ liệu không lệch quá mạnh.
Bằng chứng: OpenStax (2020) trình bày công thức gốc SE = σ/√n cho trường hợp biết độ lệch chuẩn tổng thể. Çetinkaya-Rundel và Hardin (2020) viết công thức ước lượng SE ≈ s/√n khi σ không biết, và đây là công thức được dùng phổ biến hơn trong phân tích dữ liệu khảo sát thực tế.
Ví dụ: OpenStax (2020) đưa ví dụ với σ bằng 15 và cỡ mẫu n bằng 25, sai số chuẩn tính ra bằng 15 chia cho căn bậc hai của 25, tức bằng 3. Illowsky và Dean (n.d.) đưa một ví dụ khác về thu nhập hộ gia đình, với σ khoảng 4.180 đô la và cỡ mẫu n bằng 100, sai số chuẩn tính ra khoảng 418 đô la. Cả hai ví dụ đều cho thấy sai số chuẩn nhỏ hơn nhiều so với độ lệch chuẩn gốc, vì phép chia cho căn bậc hai của n luôn kéo con số xuống.
Sai số chuẩn khác độ lệch chuẩn ở điểm nào?
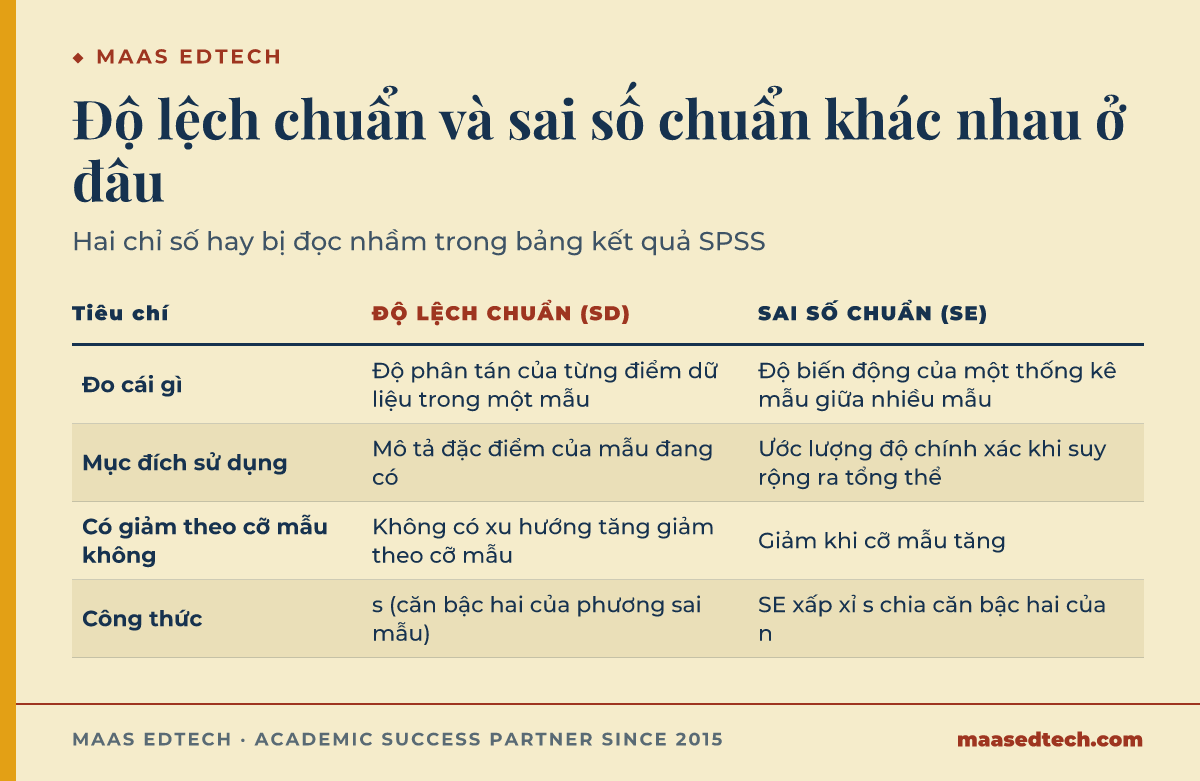
Trả lời thẳng: Độ lệch chuẩn phản ánh mức phân tán của từng điểm dữ liệu trong một mẫu, còn sai số chuẩn phản ánh mức biến động của một thống kê mẫu, chẳng hạn trung bình, khi lấy nhiều mẫu từ cùng một tổng thể. Nói cách khác, chỉ số đầu cho biết từng người trong mẫu khác nhau ra sao, còn chỉ số sau cho biết trung bình sẽ dao động bao nhiêu nếu lặp lại việc lấy mẫu.
Bằng chứng: Altman và Bland (2005) viết rằng "we can estimate how much sample means will vary from the standard deviation of this sampling distribution, which we call the standard error (SE) of the estimate of the mean" (Altman & Bland, 2005, tr. 903). Frost (2022) phân biệt rõ ràng SD mô tả độ biến thiên của các điểm dữ liệu cá thể trong một mẫu, còn SE mô tả độ biến thiên của một thống kê mẫu, chẳng hạn trung bình mẫu, giữa các mẫu khác nhau lấy từ cùng tổng thể. Andrade (2020) nhấn mạnh cùng luận điểm trong bối cảnh khoa học y sinh, cho rằng nhầm lẫn giữa hai chỉ số này là lỗi phổ biến khi báo cáo kết quả nghiên cứu.
| Tiêu chí | Độ lệch chuẩn (SD) | Sai số chuẩn (SE) |
|---|---|---|
| Đo cái gì | Độ phân tán của từng điểm dữ liệu trong một mẫu | Độ biến động của một thống kê mẫu, ví dụ trung bình, giữa nhiều mẫu |
| Mục đích sử dụng | Mô tả đặc điểm của mẫu đang có | Ước lượng độ chính xác của thống kê mẫu khi suy rộng ra tổng thể |
| Có giảm theo cỡ mẫu không | Không có xu hướng tăng giảm theo cỡ mẫu | Giảm khi cỡ mẫu tăng, vì chia cho căn bậc hai của n |
| Công thức | s (căn bậc hai của phương sai mẫu) | SE ≈ s/√n |
Ví dụ: Nếu bạn khảo sát chi tiêu sinh viên và độ lệch chuẩn của mẫu là 500.000 đồng, con số đó nói lên mức chênh lệch chi tiêu giữa các sinh viên trong mẫu, không phụ thuộc vào việc bạn khảo sát bao nhiêu người. Nhưng nếu bạn tăng cỡ mẫu từ 100 lên 400 người, sai số chuẩn của trung bình chi tiêu sẽ giảm đi một nửa, vì SE tỉ lệ nghịch với căn bậc hai của cỡ mẫu chứ không phải tỉ lệ nghịch trực tiếp với cỡ mẫu (Frost, 2022). Dữ liệu sơ cấp và thứ cấp khác nhau ở điểm nào là bước bạn cần làm rõ trước khi thu thập mẫu, vì cách thu thập ảnh hưởng đến cỡ mẫu bạn có thể đạt được.
Khi nào nên báo cáo độ lệch chuẩn, khi nào nên báo cáo sai số chuẩn?
Trả lời thẳng: Độ lệch chuẩn nên báo cáo khi bạn muốn mô tả đặc điểm của mẫu dữ liệu đang có, ví dụ mức đồng đều của điểm số trong một lớp. Sai số chuẩn nên dùng khi bạn muốn ước lượng độ chính xác của một thống kê để suy luận về tổng thể, chẳng hạn khi tính khoảng tin cậy. Nhiều tác giả báo cáo nhầm sai số chuẩn như thể đó là thống kê mô tả mẫu.
Bằng chứng: Andrade (2020) chỉ ra rằng sai số chuẩn của trung bình (SEM) không phải là một thống kê mô tả, mà là một bước trung gian để tính khoảng tin cậy, và việc nhiều tác giả trong khoa học cơ bản báo cáo SEM thay vì SD khi mô tả mẫu là một sai lầm thường gặp. Frost (2022) cũng ghi nhận SD là lựa chọn đúng khi mục đích là mô tả sự phân tán trong mẫu, còn SE phục vụ mục đích suy luận thống kê. Altman và Bland (2005) đồng thuận rằng việc lựa chọn nhầm giữa SD và SE làm sai lệch cách người đọc hình dung độ tin cậy của kết quả.
Ví dụ: Nếu phần mô tả mẫu của luận văn viết "điểm trung bình là 7,2, SEM là 0,3", người đọc dễ hiểu nhầm là điểm số của sinh viên trong mẫu khá đồng đều, trong khi con số 0,3 chỉ nói về độ chính xác của ước lượng trung bình, không nói gì về độ phân tán điểm số thật sự. Cách viết đúng cho phần mô tả mẫu là dùng SD, còn SE để dành cho phần tính khoảng tin cậy hoặc kiểm định giả thuyết.
Sai số chuẩn dùng để làm gì trong khoảng tin cậy và kiểm định giả thuyết?
Trả lời thẳng: Sai số chuẩn là thành phần cốt lõi để tính khoảng tin cậy của một ước lượng. Với mẫu đủ lớn, khoảng tin cậy 95% xấp xỉ bằng trung bình mẫu cộng trừ 1,96 lần sai số chuẩn. Khi cỡ mẫu nhỏ, người ta dùng phân phối t thay vì phân phối chuẩn để tính khoảng tin cậy, vì độ lệch chuẩn mẫu ước lượng độ lệch chuẩn tổng thể kém chính xác hơn khi mẫu nhỏ.
Bằng chứng: Çetinkaya-Rundel và Hardin (2020) trình bày công thức khoảng tin cậy dựa trên điểm ước lượng cộng trừ một giá trị tới hạn nhân với sai số chuẩn, và với mẫu lớn giá trị tới hạn xấp xỉ 1,96 cho khoảng tin cậy 95%. Altman và Bland (2005) đưa ra cùng công thức trong bối cảnh nghiên cứu y sinh, nhấn mạnh khoảng cộng trừ 1,96 lần SE quanh trung bình cho phần lớn trường hợp mẫu lớn. Çetinkaya-Rundel và Hardin (2020) cũng giải thích lý do dùng phân phối t khi mẫu nhỏ, vì thông tin về độ lệch chuẩn tổng thể σ bị thiếu và phải ước lượng qua s, khiến độ bất định tăng lên so với khi biết chắc σ.
Ví dụ: Nếu một nghiên cứu có trung bình mẫu là 82 điểm và sai số chuẩn là 4, khoảng tin cậy 95% xấp xỉ từ 74,2 đến 89,8 điểm, tính bằng 82 cộng trừ 1,96 nhân 4. Nếu cỡ mẫu của nghiên cứu đó chỉ có 15 quan sát, người phân tích cần dùng giá trị tới hạn từ phân phối t thay vì 1,96, vì phân phối t có đuôi rộng hơn để bù cho độ bất định của mẫu nhỏ. Trước khi chọn kiểm định, hãy xác định rõ tổng thể mà bạn muốn suy luận tới, vì sai số chuẩn chỉ có ý nghĩa khi mẫu được rút ra từ đúng tổng thể đó.
Cách đọc sai số chuẩn trong SPSS
Trả lời thẳng: Trong SPSS, để lấy sai số chuẩn của trung bình, vào Analyze, chọn Descriptive Statistics, chọn Descriptives, mở mục Options rồi tick vào ô S.E. mean. Kết quả xuất hiện trong bảng đầu ra Descriptives, thường đứng cạnh cột Std. Deviation. Đường dẫn menu này giữ nguyên qua nhiều phiên bản SPSS gần đây, chỉ khác nhau nhỏ ở tên nút bấm giữa các bản cập nhật.
Bằng chứng: Thao tác trên là mô tả thực tế giao diện SPSS nên không cần trích dẫn học thuật, nhưng đường dẫn menu có thể thay đổi nhẹ giữa các phiên bản SPSS.
Ví dụ: Khi bạn xem bảng Descriptives trong SPSS và thấy Std. Deviation là 12,4 cùng Std. Error Mean là 1,8 cho một biến có 47 quan sát, con số 12,4 nói lên độ phân tán điểm số giữa 47 người trong mẫu, còn 1,8 nói lên mức chính xác của trung bình mẫu nếu dùng để ước lượng cho tổng thể. Đọc đúng cột Sig. và các kiểm định liên quan là bước tiếp theo sau khi đã hiểu rõ SE, vì nhiều kiểm định thống kê dùng SE làm một phần của công thức tính giá trị kiểm định.
Câu hỏi thường gặp
Sai số chuẩn có luôn nhỏ hơn độ lệch chuẩn không?
Có, SE luôn nhỏ hơn hoặc bằng SD, và chỉ bằng nhau khi cỡ mẫu n bằng 1. Vì công thức SE bằng SD chia cho căn bậc hai của cỡ mẫu n, và với n từ 1 trở lên căn bậc hai của n luôn từ 1 trở lên, nên phép chia này luôn giữ hoặc kéo con số xuống, không bao giờ làm nó lớn hơn.
Cỡ mẫu nhỏ thì sai số chuẩn tính thế nào?
Công thức tính SE vẫn giữ nguyên là độ lệch chuẩn mẫu chia cho căn bậc hai của cỡ mẫu. Điều thay đổi nằm ở bước tính khoảng tin cậy hoặc kiểm định giả thuyết: mẫu nhỏ cần giá trị tới hạn từ phân phối t thay vì phân phối chuẩn z, vì độ bất định trong ước lượng lúc này lớn hơn.
Vì sao sai số chuẩn giảm khi cỡ mẫu tăng?
Vì SE tỉ lệ nghịch với căn bậc hai của cỡ mẫu, không phải tỉ lệ nghịch trực tiếp với cỡ mẫu. Mẫu càng lớn, trung bình mẫu càng ổn định qua nhiều lần lấy mẫu lặp lại, nên độ biến động của trung bình mẫu, tức sai số chuẩn, càng nhỏ.
Độ lệch chuẩn có thay đổi khi cỡ mẫu tăng không?
Không có xu hướng tăng giảm theo cỡ mẫu một cách hệ thống như sai số chuẩn. Độ lệch chuẩn phản ánh mức phân tán thật của dữ liệu trong tổng thể, nên khi mẫu đủ lớn để đại diện tốt cho tổng thể, độ lệch chuẩn của mẫu sẽ ổn định quanh một giá trị chứ không giảm dần theo cỡ mẫu.
Sai số chuẩn nằm trong bảng kết quả kiểm định t và ANOVA của SPSS ở đâu?
Trong bảng Group Statistics của kiểm định t hai mẫu độc lập, SPSS xuất Std. Error Mean cho từng nhóm. Trong bảng hệ số hồi quy hoặc bảng so sánh trung bình khác, sai số chuẩn thường đi kèm để dùng tính khoảng tin cậy của hệ số hoặc của chênh lệch trung bình.
Nên báo cáo SD hay SE trong phần mô tả mẫu của luận văn?
Nên báo cáo độ lệch chuẩn (SD) trong phần mô tả mẫu, vì đây mới là con số mô tả đúng mức phân tán của dữ liệu bạn đang có. Sai số chuẩn để dành cho phần tính khoảng tin cậy hoặc trình bày kết quả kiểm định giả thuyết, nơi mục đích là suy luận về tổng thể chứ không phải mô tả mẫu.
Nên làm gì tiếp theo
Đọc tiếp:
- Độ lệch chuẩn trong SPSS
- SPSS là gì
- Đối tượng nghiên cứu là gì
- Dữ liệu sơ cấp và thứ cấp khác nhau ở điểm nào
Đang chạy phân tích SPSS hoặc Python cho một chương luận văn và cần người đúng chuyên ngành hướng dẫn bạn chọn kiểm định, tự chạy phân tích và đọc đúng kết quả? Xem dịch vụ hướng dẫn chạy SPSS và Python, hoặc đặt lịch tư vấn miễn phí 15 phút tại đây để trao đổi trước khi bắt tay vào chạy số liệu.
References
- Altman, D. G., & Bland, J. M. (2005). Standard deviations and standard errors. BMJ, 331(7521), 903. https://doi.org/10.1136/bmj.331.7521.903
- Andrade, C. (2020). Understanding the difference between standard deviation and standard error of the mean, and knowing when to use which. Indian Journal of Psychological Medicine, 42(4), 409-410. https://doi.org/10.1177/0253717620933419
- Çetinkaya-Rundel, M., & Hardin, J. (2020). Introduction to modern statistics (2nd ed.). OpenIntro. https://openintro-ims2.netlify.app/
- Frost, J. (2022). Difference between standard deviation and standard error [Blog post]. Statistics By Jim. https://statisticsbyjim.com/hypothesis-testing/standard-error-mean/
- Illowsky, B., & Dean, S. (n.d.). Introductory business statistics. Statistics LibreTexts. https://stats.libretexts.org/Bookshelves/Applied_Statistics/Introductory_Business_Statistics_(OpenStax)
- OpenStax. (2020). Introductory statistics. OpenStax. https://openstax.org/books/introductory-statistics/pages/7-1-the-central-limit-theorem-for-sample-means-averages