
Turnitin phát hiện được một phần văn bản do ChatGPT và các công cụ AI khác tạo ra, nhưng không ổn định, và kết quả nó đưa ra chỉ là một xác suất chứ không phải bằng chứng. Bài viết này giúp bạn hiểu phần mềm phát hiện văn bản AI làm được gì và không làm được gì, vì sao người viết tiếng Anh như ngôn ngữ thứ hai dễ bị gắn cờ oan hơn, và nên làm gì để bảo vệ bài mình tự viết nếu một ngày nó bị gắn cờ.
Nhiều sinh viên gõ câu hỏi này lúc 2 giờ sáng, khi đang lo công cụ sẽ bắt được bài mình. Câu trả lời thật phức tạp hơn cả hai luồng ý kiến "AI không thể bị phát hiện" và "chắc chắn bị bắt", nhưng với sinh viên tự làm bài thì lại đáng yên tâm hơn.
Tác giả: Ban Biên tập MAAS
Cập nhật lần cuối: 2026-06-29
Chuyên mục: academic-integrity
Turnitin có thật sự phát hiện được văn bản do AI tạo không?
Trả lời trực tiếp: Được một phần, và không ổn định. Chỉ số AI-writing của Turnitin ước lượng bao nhiêu phần trăm tài liệu có khả năng do AI tạo, tách riêng khỏi điểm tương đồng. Công cụ gắn cờ đúng một số văn bản AI nhưng để lọt những văn bản khác, và nguy hiểm hơn là có lúc gắn cờ cả bài do người thật viết. Kết quả là một xác suất, không đủ để kết luận.
Bằng chứng: Weber-Wulff và cộng sự (2023) kiểm thử độc lập nhiều công cụ phát hiện văn bản AI và thấy độ chính xác của chúng không đồng đều, lại giảm mạnh khi văn bản chỉ được chỉnh sửa nhẹ hoặc paraphrase (viết lại bằng từ khác). Nhóm tác giả kết luận thẳng rằng "the available detection tools are neither accurate nor reliable and have a main bias towards classifying the output as human-written rather than detecting AI-generated text" (Weber-Wulff và cộng sự, 2023), nghĩa là các công cụ hiện có vừa không chính xác vừa không đáng tin, và nghiêng về xếp văn bản vào loại do người viết hơn là bắt đúng văn bản do AI tạo. Chính các nhà cung cấp công cụ cũng báo cáo tỷ lệ false positive (gắn cờ nhầm bài của người thật) lớn hơn không, nên một cờ báo chỉ được xem là tín hiệu để xem xét thêm chứ không phải phán quyết.
Ví dụ: Một sinh viên ngành Kinh doanh người Việt tại University of Manchester tự viết essay của mình nhưng vẫn có một đoạn bị gắn nhãn "có khả năng là AI". Cố vấn MAAS giải thích với bạn ấy rằng nhãn đó là một ước lượng thống kê chứ không phải bằng chứng, rồi giúp bạn ấy tập hợp lịch sử các bản nháp để cho thấy bài là do chính mình viết. Khi đó cờ báo là một cáo buộc bạn ấy có thể trả lời, không phải một bản án đã tuyên.
Cơ chế phát hiện AI của Turnitin thực ra hoạt động thế nào?
Trả lời trực tiếp: Công cụ đo mức độ dễ đoán của câu chữ, chứ không so khớp bài của bạn với nguồn nào. Tín hiệu chủ yếu gồm perplexity, tức mỗi lựa chọn từ bất ngờ tới đâu, và burstiness, tức độ dài và độ phức tạp của câu thay đổi nhiều hay ít. Văn bản AI thường mượt và đều, nên bài quá đồng đều dễ bị chấm là "giống AI", dù người thật hoàn toàn có thể viết như vậy.
Mối liên hệ giữa các tín hiệu này với AI chỉ là tương quan, không phải dấu vân tay.
Bằng chứng: Liang và cộng sự (2023) chỉ ra rằng các phương pháp phát hiện dựa trên những chỉ số ngôn ngữ mang tính xác suất như trên, chứ không dựa trên hồ sơ nào ghi lại những gì một công cụ AI đã tạo ra. Vì vậy mọi công cụ phát hiện lớn đều chỉ báo một khả năng và đều cảnh báo không nên dùng điểm số đó một mình. Cũng vì tín hiệu mang tính thống kê, bất cứ điều gì làm văn bản của người thật đồng đều hơn, như biên tập kỹ, dùng cấu trúc câu đơn giản hay sửa ngữ pháp bằng công cụ nhiều lần, đều có thể đẩy điểm lên.
Ví dụ: Một sinh viên ngành Kỹ thuật người Việt tại UNSW quen viết bằng những câu ngắn, sạch và nhất quán, vì đó là phong cách anh được rèn luyện từ lâu như chuẩn mực của tiếng Anh học thuật tốt. Công cụ lại đọc sự đồng đều ấy thành dấu hiệu của máy. Không có chữ nào trong bài do AI tạo ra, chỉ là phong cách cẩn thận của anh trùng với đúng mẫu hình mà công cụ chấm điểm cao, và cơ chế này được phân tích trong bài vì sao bài bạn tự viết vẫn bị gắn cờ AI.
Công cụ phát hiện AI chính xác đến đâu, và ai bị chấm sai nhiều nhất?
Trả lời trực tiếp: Độ chính xác không đều, và lỗi dồn nặng nhất vào người viết tiếng Anh như ngôn ngữ thứ hai. Văn bản của nhóm này trung bình đồng đều hơn về từ vựng và cấu trúc, nên bị gắn cờ AI thường xuyên hơn hẳn bài của người bản ngữ. Người khó phản biện bằng tiếng Anh trôi chảy nhất lại dễ bị cáo buộc oan nhất, nên điểm công cụ không thể đứng một mình.
Bằng chứng: Liang và cộng sự (2023), trong một nghiên cứu thực hiện tại Stanford, cho thấy nhiều công cụ phát hiện AI phổ biến xếp nhầm bài viết của người không phải bản ngữ tiếng Anh vào loại do AI tạo với tỷ lệ cao đáng kinh ngạc, trong khi rất hiếm khi xếp nhầm bài của người bản ngữ. Nhóm tác giả kết luận các công cụ này mang thiên kiến và không đáng tin nếu được dùng làm bằng chứng duy nhất. Khi kiểm thử trên nhiều công cụ và nhiều điều kiện khác nhau, Weber-Wulff và cộng sự (2023) cũng đi tới cùng một nhận định về độ chính xác.
Ví dụ: Hai sinh viên Việt học cùng một trường đại học ở Úc nộp hai bài essay trung thực như nhau. Bạn viết câu dài hơn, dùng tiếng Anh tự nhiên kiểu người bản ngữ hơn thì qua công cụ, còn bạn viết theo phong cách cẩn thận, đều đặn như mình được dạy thì bị gắn cờ. Hai bạn có cùng mức liêm chính, chỉ khác nhau ở bề mặt câu chữ, và công cụ thì chỉ nhìn thấy bề mặt ấy.
"Humanise" văn bản AI hay tìm cách qua mặt công cụ có bao giờ hiệu quả không?
Trả lời trực tiếp: Không, và MAAS sẽ không giúp bạn làm điều đó. Các công cụ quảng cáo khả năng "humanise", tức làm văn bản AI trông như người viết để né phát hiện, vốn không đáng tin. Quan trọng hơn, cố tình nguỵ trang bài do AI tạo là vi phạm liêm chính học thuật, bất kể bạn dùng công cụ nào. Điều này khác hẳn với bảo vệ một bài trung thực bị gắn cờ oan.
Nếu bị phát hiện, hành vi né tránh còn bị xem là tình tiết tăng nặng, biến một trường hợp đang ở vùng ranh giới thành một vi phạm nghiêm trọng. Cách giữ lằn ranh này rõ ràng nhất là tự viết bài của mình, vì khi đó không còn gì cần nguỵ trang.
Bằng chứng: Perkins (2023) lưu ý rằng các chính sách liêm chính định nghĩa vi phạm theo hành vi, tức nộp một bài không thật sự do mình làm hoặc khai sai cách bài được tạo ra, chứ không theo phần mềm nào đã được dùng. Vì công cụ phát hiện không đáng tin ở cả hai chiều, câu "công cụ kiểm tra đã cho qua" không bao giờ là lời bào chữa rằng vi phạm đã không xảy ra.
Ví dụ: Từng có một sinh viên Việt nhờ cố vấn MAAS "làm cho văn bản AI qua được công cụ phát hiện của trường". Cố vấn từ chối và giải thích lý do, rồi đề xuất một lựa chọn thật sự khác, là đồng hành để bạn ấy tự viết bài theo quy trình Outline → Draft → Final, tức đi từ dàn ý tới bản nháp rồi bản hoàn chỉnh, để bài thật sự là của bạn ấy và không công cụ nào còn là mối đe doạ. Bạn ấy chọn con đường đó và nộp bài với sự tự tin.
Phải làm gì nếu bài bạn tự viết bị gắn cờ là AI?
Trả lời trực tiếp: Hãy giữ bình tĩnh, đừng nhận điều mình không làm, và bắt đầu gom bằng chứng. Tập hợp lịch sử phiên bản bản nháp, dàn ý, ghi chú và các nguồn bạn đã chú thích, rồi xin một buổi gặp, đề nghị nhà trường nêu rõ công cụ đã báo gì và chính sách của trường nói gì về cách xử lý dựa trên điểm công cụ. Một quá trình viết được lưu lại là phản chứng mạnh nhất.
Quá trình viết có sức nặng vì nó cho thấy bài hình thành dần qua thời gian trong tay bạn, điều công cụ phát hiện không nhìn thấy.
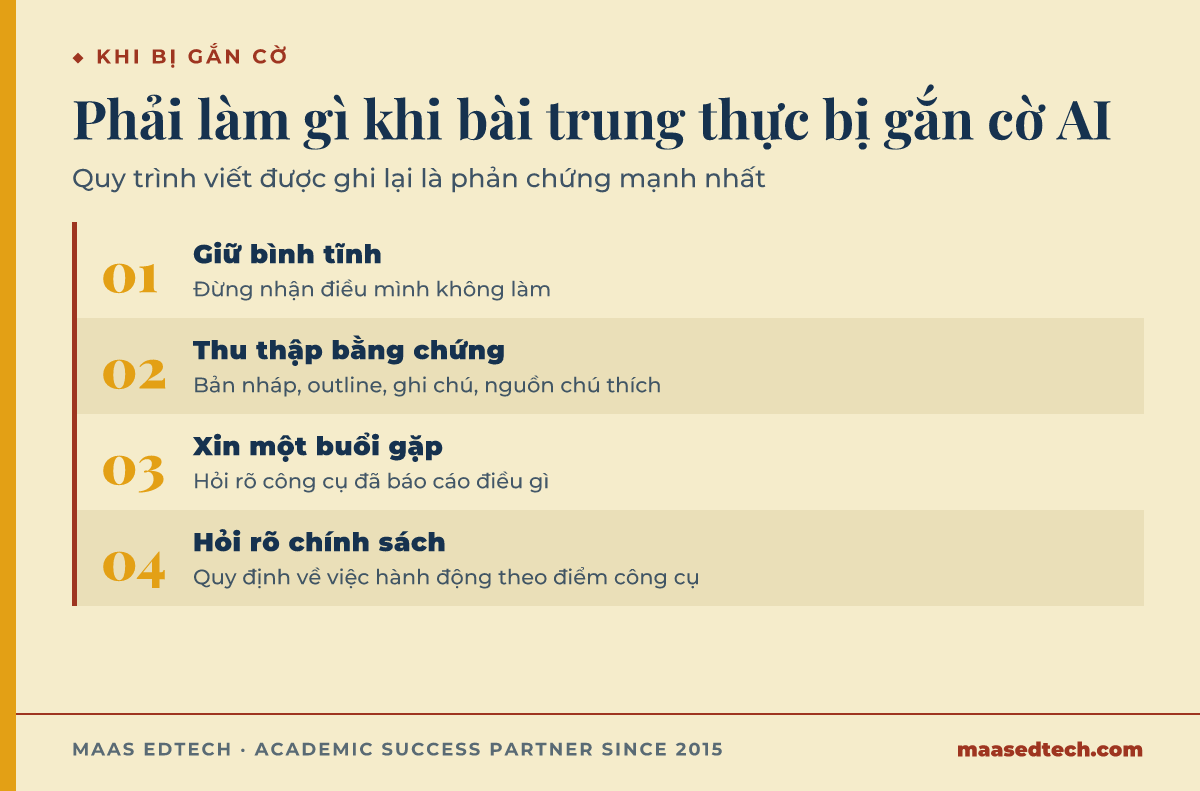
Bằng chứng: Phần lớn quy trình xử lý vi phạm ở các trường đại học đòi hỏi bằng chứng bổ trợ ngoài một điểm số duy nhất từ công cụ, và nhiều trường đã ra khuyến cáo rõ rằng kết quả phát hiện AI không đủ tin cậy để làm bằng chứng duy nhất. Hồ sơ quá trình viết của bạn, gồm các bản nháp có dấu thời gian, các lượt chỉnh sửa và ghi chú, được công nhận là biện pháp bảo vệ chính vì đó là thứ công cụ không nhìn thấy.
Ví dụ: Một học viên sau đại học người Việt tại University of Glasgow thấy tiếng Anh của mình chưa đủ mạnh để phản biện sau khi bị gắn cờ AI. Cố vấn MAAS giúp anh trình bày lịch sử phiên bản của tài liệu, cho thấy nhiều tuần chỉnh sửa từng chút một, kèm theo dàn ý anh viết tay. Trước dấu vết soạn thảo đó, hội đồng xét liêm chính kết luận anh không vi phạm, và chính bản ghi quá trình đã nói thay cho anh.
Cách an toàn duy nhất đáng tin là gì?
Trả lời trực tiếp: Tự viết bài và giữ lại bằng chứng rằng bạn đã tự viết. Hãy soạn trong công cụ có lưu lịch sử phiên bản, giữ dàn ý và ghi chú, để giọng văn tự nhiên thay đổi, và chỉ dùng AI khi trường cho phép, theo cách bạn sẵn sàng khai báo công khai. Các bước này không nhằm qua mặt công cụ, mà để lại một dấu vết trung thực để nếu có cờ thì dễ trả lời.
Bằng chứng: Vì công cụ phát hiện không đáng tin ở cả hai chiều, cả né tránh lẫn cố làm vừa lòng chúng đều không phải chiến lược bền vững. Weber-Wulff và cộng sự (2023) cho thấy chính giới hạn này, và từ đó biện pháp bảo vệ lâu dài là quyền tác giả thật kèm một quá trình viết được ghi lại, cũng là điều mà một buổi viva (bảo vệ vấn đáp) hay một hội đồng liêm chính rốt cuộc sẽ kiểm tra. Văn bản do người thật viết tự nhiên có nhịp thay đổi, trái ngược với sự đồng đều phẳng lặng mà công cụ chấm điểm cao.
Ví dụ: Sau một lần hú vía, một sinh viên ngành Marketing người Việt tại RMIT áp dụng thói quen mà cố vấn MAAS gợi ý, gồm chỉ soạn bài trong tài liệu có theo dõi phiên bản, giữ lại mọi dàn ý, và đọc to từng đoạn để giọng văn của chính mình hiện ra. Các bài nộp sau đó của cô đều có dấu vết tác giả rõ ràng, và cô không còn sợ bấm nút nộp bài nữa.
Câu hỏi thường gặp
Turnitin có phát hiện được riêng ChatGPT không?
Chỉ số AI của Turnitin ước lượng khả năng một văn bản do AI tạo nói chung, chứ không gọi tên một công cụ cụ thể nào. Nó bắt được một số văn bản AI, bỏ sót một số khác, và đôi khi gắn cờ bài do người thật viết, nên kết quả của nó là một ước lượng cần được xem xét thêm, không bao giờ là bằng chứng đủ khi đứng một mình.
Điểm AI cao có phải bằng chứng tôi vi phạm liêm chính không?
Không, vì chỉ số AI là một xác suất dựa trên mẫu hình thống kê, và công cụ này được biết là xếp nhầm cả bài trung thực, nhất là bài của người không phải bản ngữ tiếng Anh. Điểm cao là một cáo buộc, và một quy trình công bằng đòi hỏi phải có bằng chứng bổ trợ trước khi xử lý.
Công cụ paraphrase có giấu được văn bản AI khỏi công cụ phát hiện không?
Bạn không nên trông vào cách này, vì nguỵ trang văn bản do AI tạo tự nó đã là vi phạm liêm chính, và các công cụ paraphrase thường sinh ra những câu văn gượng gạo mà người chấm vẫn nhận ra. Không có cách an toàn nào để nộp bài do máy tạo như thể đó là bài của mình.
Vì sao bài tôi tự viết vẫn bị gắn cờ AI?
Thường là vì bài rõ ràng, đều đặn và có cấu trúc dễ đoán, đúng mẫu hình thống kê mà công cụ gắn với AI, và cũng là mẫu hình mà người viết tiếng Anh như ngôn ngữ thứ hai, khi viết cẩn thận, tạo ra thường xuyên hơn. Bài vì sao bài bạn tự viết vẫn bị gắn cờ AI giải thích cơ chế này chi tiết hơn.
MAAS có giúp được nếu tôi bị cáo buộc oan không?
Có, dịch vụ Kiểm tra liêm chính học thuật cùng cố vấn MAAS có thể giúp bạn đọc hiểu báo cáo, tập hợp bằng chứng về quá trình viết và chuẩn bị cho buổi làm việc về liêm chính. Mọi hỗ trợ đều nhằm bảo vệ chính bài trung thực của bạn, không bao giờ nhằm nguỵ trang nội dung do máy tạo.
Tài nguyên liên quan
- Vì sao bài bạn tự viết bị gắn cờ là do AI tạo?: bài đi kèm, phân tích hiện tượng công cụ phát hiện AI gắn cờ nhầm
- Điểm tương đồng Turnitin bao nhiêu là an toàn để nộp?: một báo cáo 18% có đáng lo không, và cách đọc báo cáo tương đồng theo từng đoạn trùng khớp
- Similarity score và AI score khác nhau thế nào?: hai chỉ số tương đồng và AI đo những thứ khác nhau ra sao, và vì sao cần đọc cả hai
- Làm thế nào để dùng AI có đạo đức trong học thuật?: ranh giới giữa cách dùng được phép và bị cấm, theo từng loại bài tập
- Làm thế nào để khai báo cách dùng AI trong bài research paper ở đại học?: biến cách dùng AI được phép thành một lời khai báo rõ ràng
- Dịch vụ Kiểm tra liêm chính học thuật: diễn giải báo cáo tương đồng và báo cáo phát hiện AI, kèm rà soát bài của chính bạn trước khi nộp
Bị gắn cờ AI trên bài bạn tự viết? Đặt lịch tư vấn miễn phí để cố vấn MAAS giúp bạn gom bằng chứng và chuẩn bị phần phản hồi, với mục đích bảo vệ chính bài trung thực của bạn.
References
- Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). GPT detectors are biased against non-native English writers. Patterns, 4(7), 100779. https://doi.org/10.1016/j.patter.2023.100779
- Perkins, M. (2023). Academic integrity considerations of AI large language models in the post-pandemic era: ChatGPT and beyond. Journal of University Teaching & Learning Practice, 20(2). https://doi.org/10.53761/1.20.02.07
- Weber-Wulff, D., Anohina-Naumeca, A., Bjelobaba, S., Foltýnek, T., Guerrero-Dib, J., Popoola, O., Šigut, P., & Waddington, L. (2023). Testing of detection tools for AI-generated text. International Journal for Educational Integrity, 19, 26. https://doi.org/10.1007/s40979-023-00146-z
Bài viết mang tính hướng dẫn về liêm chính học thuật và không thay thế cho bài tự làm của bạn hay chính sách của nhà trường. MAAS đồng hành để sinh viên tạo ra bài thật sự của mình theo mô hình Outline → Draft → Final. MAAS không viết, không nộp và không nguỵ trang bài thay cho sinh viên.