
Sinh viên có biến phụ thuộc chỉ hai giá trị, như đậu hoặc rớt, thường bối rối khi SPSS trả về một bảng kết quả khác hẳn hồi quy tuyến tính quen thuộc.
Cập nhật lần cuối: 2026-09-17
Chuyên mục: research-methods
Hồi quy logistic là gì, và khác hồi quy tuyến tính ở điểm nào?
Trả lời thẳng: Mô hình hồi quy logistic nhị phân dự đoán xác suất một quan sát rơi vào một trong hai nhóm của biến phụ thuộc, dựa trên một hoặc nhiều biến độc lập. Khác hồi quy tuyến tính OLS, hồi quy logistic không giả định phần dư phân phối chuẩn hay phương sai đồng nhất, vì biến phụ thuộc chỉ nhận hai giá trị chứ không phải một thang liên tục.
Bằng chứng: Laerd Statistics (n.d.) mô tả kỹ thuật này áp dụng cho trường hợp biến kết quả chỉ có hai giá trị loại trừ lẫn nhau, và việc phân tích ước lượng khả năng thuộc về từng giá trị đó dựa trên các yếu tố liên quan. Nếu biến phụ thuộc là biến đếm, Laerd Statistics (n.d.) khuyến nghị dùng hồi quy Poisson thay vì logistic, còn khi biến phụ thuộc có nhiều hơn hai nhóm không thứ tự thì cần hồi quy logistic đa thức. University of California, Los Angeles, Office of Advanced Research Computing (OARC) Statistical Methods and Data Analytics (n.d.) chỉ ra rằng khi biến phụ thuộc nhị phân, mô hình xác suất tuyến tính dựng bằng hồi quy OLS vi phạm giả định phương sai sai số đồng nhất và giả định chuẩn hoá phần dư, khiến sai số chuẩn và kiểm định giả thuyết không còn hợp lệ.
Ví dụ: Nếu đề tài của bạn đo "sinh viên có bỏ học hay không" bằng hai giá trị 1 và 0, chạy Linear Regression trên biến này sẽ cho ra những dự đoán xác suất nhỏ hơn 0 hoặc lớn hơn 1, một kết quả vô nghĩa về mặt xác suất. Nếu bạn chưa chắc dữ liệu của mình là định lượng hay định tính trước khi chọn mô hình, SPSS là gì giải thích các nhóm phân tích SPSS thường gặp và khi nào một biến được coi là định tính.
Trước khi chạy, dữ liệu cần đáp ứng những giả định nào?
Trả lời thẳng: Laerd Statistics (n.d.) đưa ra bảy giả định cần kiểm tra trước khi kết quả hồi quy logistic đáng tin cậy, phần lõi gồm thang đo nhị phân của biến phụ thuộc, tính độc lập giữa các quan sát, và quan hệ tuyến tính với logit của biến phụ thuộc. CASRAI bổ sung điểm kiểm tra thực hành như không đa cộng tuyến và đủ số case trên mỗi biến dự báo.
Bằng chứng: Laerd Statistics (n.d.) nêu bảy giả định, trong đó bốn giả định đầu là biến phụ thuộc đo trên thang nhị phân, có một hoặc nhiều biến độc lập liên tục hoặc phân loại, các quan sát độc lập và các nhóm của biến phụ thuộc loại trừ lẫn nhau và bao trùm hết trường hợp, và có quan hệ tuyến tính giữa biến độc lập liên tục với logit-transform của biến phụ thuộc, kiểm bằng thủ tục Box-Tidwell. CASRAI Editorial Board (2026) liệt kê thêm việc kiểm tra không đa cộng tuyến nghiêm trọng, lưu ý SPSS không in VIF trực tiếp cho hồi quy logistic nên phải chạy proxy qua hồi quy tuyến tính để xem VIF, cùng với việc kiểm tra outlier ảnh hưởng lớn bằng Cook's distance và leverage. Newcastle University IT Service (n.d.) nói thêm rằng hồi quy logistic không dựa trên giả định phân phối theo nghĩa như các thủ tục khác, nhưng nghiệm sẽ ổn định hơn nếu biến dự báo có phân phối đa biến gần chuẩn, và biến phụ thuộc phải thực sự nhị phân, thường mã hoá 1 là có và 0 là không.
Ví dụ: Nếu đề tài của bạn đo lặp lại nhiều lần trên cùng một đối tượng, chẳng hạn khảo sát cùng một nhóm sinh viên ở nhiều thời điểm, giả định độc lập quan sát bị vi phạm và kết quả hồi quy logistic thông thường không còn đáng tin. Cách kiểm tra dữ liệu của bạn là dữ liệu tự thu thập hay dữ liệu lấy lại từ nguồn đã công bố cũng ảnh hưởng tới việc bạn có kiểm soát được thiết kế lấy mẫu hay không, xem thêm ở dữ liệu sơ cấp và thứ cấp khác nhau ở điểm nào.
Cỡ mẫu bao nhiêu là đủ để chạy hồi quy logistic?
Trả lời thẳng: Một quy tắc kinh nghiệm phổ biến trong tài liệu phương pháp thống kê là cần ít nhất mười sự kiện, tức case ở nhóm nhỏ hơn của biến phụ thuộc, trên mỗi biến dự báo đưa vào mô hình. Ít hơn mức này, các hệ số hồi quy trở nên không ổn định và sai số chuẩn bị phóng đại, ngay cả khi SPSS vẫn chạy ra kết quả mà không báo lỗi.
Bằng chứng: CASRAI Editorial Board (2026) mô tả quy tắc mười sự kiện trên mỗi biến dự báo là một quy tắc kinh nghiệm được trích dẫn rộng rãi trong tài liệu phương pháp, dù đây là quy tắc kinh nghiệm chứ không phải một ngưỡng cứng. University of California, Los Angeles, Office of Advanced Research Computing (OARC) Statistical Methods and Data Analytics (n.d.) lưu ý cả mô hình logit và probit cần nhiều case hơn hồi quy OLS vì dùng ước lượng hợp lý cực đại, và khi biến kết quả hiếm gặp, dù bộ dữ liệu tổng thể lớn thì việc ước lượng mô hình logit vẫn có thể khó khăn. Cùng nguồn này cũng khuyến nghị kiểm tra ô trống hoặc ô có ít quan sát bằng bảng chéo giữa biến dự báo phân loại và biến phụ thuộc trước khi chạy mô hình, vì ô có quá ít case có thể khiến mô hình không ổn định hoặc không chạy được.
Ví dụ: Nếu đề tài của bạn muốn đưa năm biến dự báo vào mô hình và nhóm sinh viên bỏ học chỉ có 30 trường hợp trong tổng mẫu 400, tỷ lệ sáu sự kiện trên mỗi biến dự báo là dưới ngưỡng khuyến nghị, và kết quả cần được diễn giải thận trọng hơn thay vì trích dẫn Exp(B) như một con số chắc chắn.
Các bước chạy hồi quy logistic nhị phân trong SPSS là gì?
Trả lời thẳng: Đường dẫn menu trong SPSS là Analyze, Regression, rồi Binary Logistic. Biến phân loại phải đưa vào hộp Categorical Covariates thay vì để SPSS tự nhận diện, mục Method mặc định là Enter cho mô hình đã xác định trước, và trong Options cần tự tick Hosmer-Lemeshow goodness-of-fit cùng CI for exp(B) vì cả hai không bật mặc định trong hộp thoại gốc.
Bằng chứng: CASRAI Editorial Board (2026) mô tả biến phụ thuộc phải mã hoá đúng hai giá trị, và SPSS coi giá trị lớn hơn là sự kiện được dự đoán nên cần kiểm tra giá trị nào trước khi diễn giải chiều tác động. Nếu một biến dự báo là biến phân loại, phải bấm vào nút Categorical và đưa nó vào danh sách Categorical Covariates, vì SPSS không tự nhận diện biến phân loại từ hộp Covariates, và bỏ qua bước này khiến một biến mã hoá 1, 2, 3 bị xử lý như thang đo liên tục. Trong hộp thoại Categorical, người dùng cần tự đặt nhóm tham chiếu là First hoặc Last thay vì chấp nhận mặc định mà không kiểm tra, vì mọi Exp(B) của biến đó được báo cáo tương đối so với nhóm tham chiếu đã chọn. Về mục Method, CASRAI Editorial Board (2026) giải thích Enter đưa toàn bộ biến dự báo vào một khối, phù hợp cho mô hình khẳng định đã xác định trước, trong khi các tuỳ chọn stepwise như Forward LR hay Backward LR để SPSS tự thêm hoặc bớt biến dựa trên ý nghĩa thống kê, một công cụ chọn biến theo dữ liệu chứ không phải một kiểm định giả thuyết, và đa số reviewer phương pháp kỳ vọng dùng Enter trừ khi phân tích rõ ràng mang tính khám phá. Trong mục Options, CASRAI Editorial Board (2026) và spssfocus.com đều nhắc cần tick Hosmer-Lemeshow goodness-of-fit và CI for exp(B), vì cả hai không bật mặc định nhưng cần thiết cho một báo cáo đầy đủ.
Ví dụ: Nếu biến độc lập của bạn là loại hình cư trú với ba giá trị ký túc xá, trọ ngoài và ở cùng gia đình, quên đưa biến này vào Categorical Covariates sẽ khiến SPSS coi bước nhảy từ ký túc xá sang trọ ngoài bằng bước nhảy từ trọ ngoài sang ở cùng gia đình về mặt số học, một giả định sai với dữ liệu phân loại không thứ tự.
Đọc bảng kết quả SPSS thế nào cho đúng, gồm Omnibus, Hosmer-Lemeshow và Exp(B)?
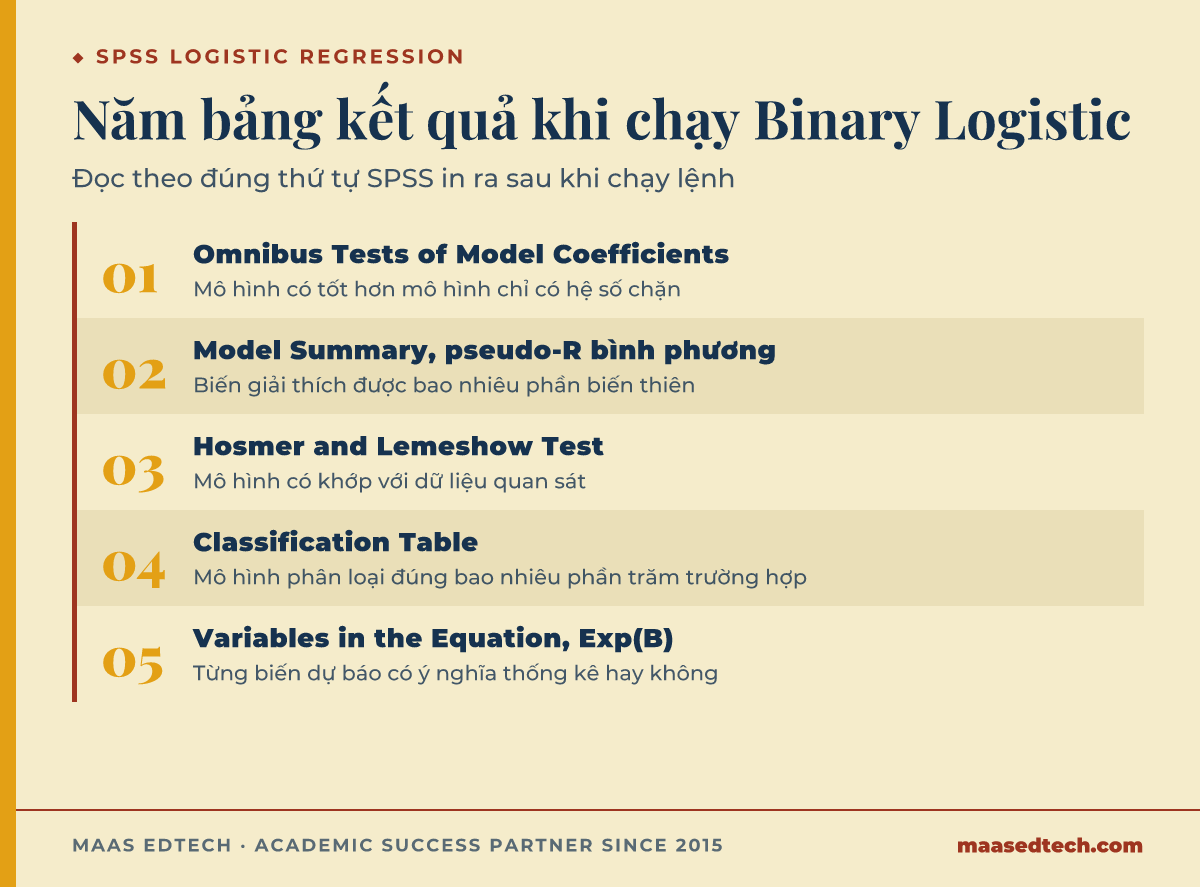
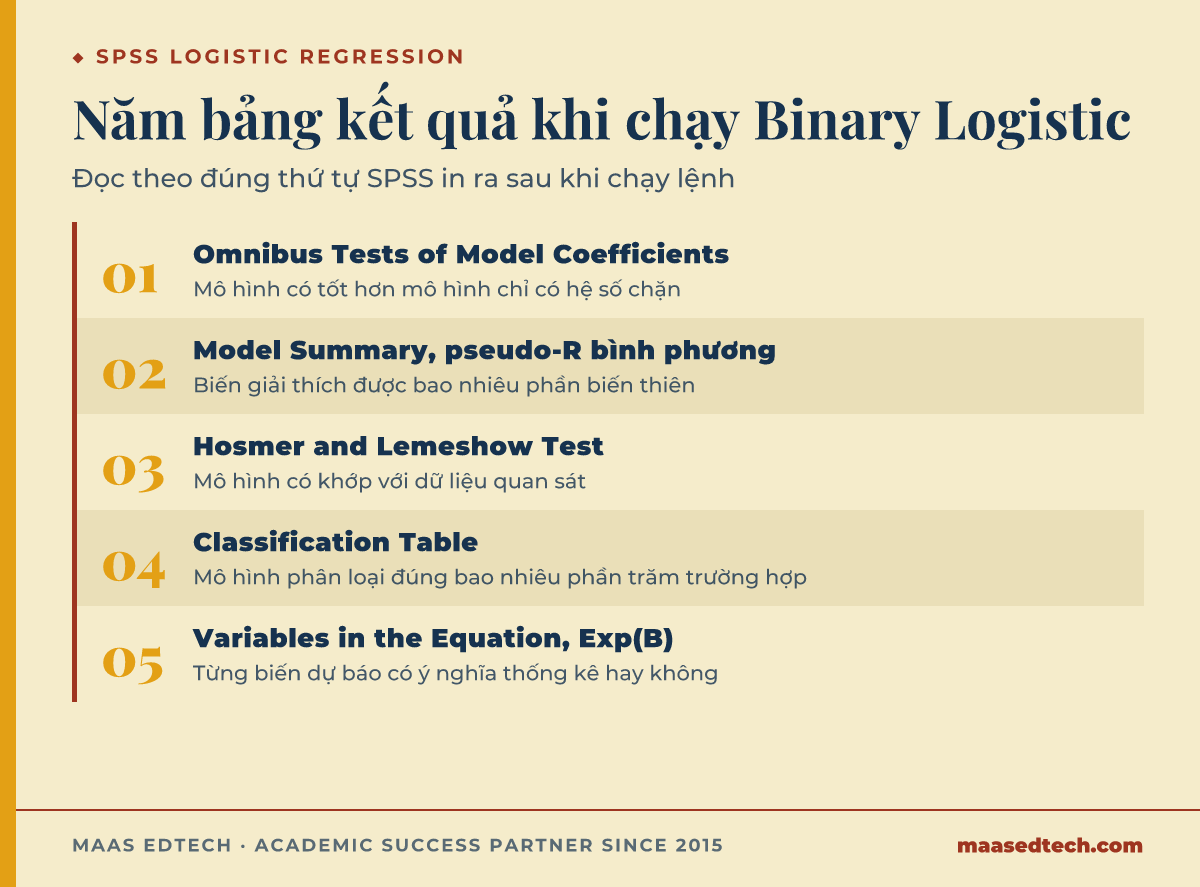
Trả lời thẳng: Có năm bảng kết quả cần đọc khi chạy Binary Logistic, và mỗi bảng trả lời một câu hỏi khác nhau nên không thể chỉ đọc một bảng rồi kết luận toàn bộ mô hình. Lỗi hay gặp nhất khi đọc cột cuối là nhầm Exp(B), một tỷ số chênh, thành tỷ số rủi ro, trong khi hai đại lượng này chỉ quy đổi được sang nhau khi biết thêm tỷ lệ nền của nhóm tham chiếu.
Bằng chứng: CASRAI Editorial Board (2026) liệt kê năm bảng cần đọc gồm kiểm định omnibus chi-square, bảng Model Summary với các giá trị pseudo-R bình phương, bảng Hosmer-Lemeshow vốn chỉ xuất hiện khi bạn đã tick ở Options, bảng phân loại, và cuối cùng là bảng Variables in the Equation. Cùng nguồn này viết thẳng "Exp(B) is an odds ratio, not a risk ratio" (CASRAI Editorial Board, 2026), và gọi việc báo cáo Exp(B) như tỷ số rủi ro, hay chỉ trích cột Exp(B) mà bỏ qua các chỉ số phù hợp mô hình phía trên, là sai lầm diễn giải phổ biến nhất trong hồi quy logistic. Trong bảng Variables in the Equation, University of California, Los Angeles, Office of Advanced Research Computing (OARC) Statistical Methods and Data Analytics (n.d.) mô tả mỗi hệ số hồi quy đi kèm sai số chuẩn, giá trị kiểm định Wald với bậc tự do và giá trị p ở cột Sig., cùng hệ số đã lấy hàm mũ là Exp(B). spssfocus.com (2025) minh hoạ bằng một ví dụ số cụ thể của trang này trên bộ dữ liệu Pima Indians Diabetes với 768 bệnh nhân nữ, biến huyết áp có hệ số B là 0,030, Exp(B) là 1,030, khoảng tin cậy 95% từ 1,017 đến 1,044, và vì khoảng tin cậy này không chứa giá trị 1 nên biến huyết áp được kết luận có tác động có ý nghĩa thống kê tới biến kết quả tiểu đường. Cùng ví dụ này ghi nhận kiểm định omnibus của khối biến có chi-square 21,615 với bậc tự do 1 và p nhỏ hơn 0,01, kiểm định Wald cho biến huyết áp là 20,580 với bậc tự do 1 và Sig. bằng 0,000.
| Bảng kết quả SPSS | Câu hỏi bảng đó trả lời |
|---|---|
| Omnibus Tests of Model Coefficients | Mô hình với các biến dự báo có tốt hơn mô hình chỉ có hệ số chặn hay không |
| Model Summary (pseudo-R bình phương) | Các biến dự báo hữu ích tới đâu trong việc dự đoán biến kết quả |
| Hosmer and Lemeshow Test | Mô hình có khớp với dữ liệu quan sát hay không |
| Classification Table | Mô hình phân loại đúng bao nhiêu phần trăm trường hợp |
| Variables in the Equation | Từng biến dự báo có ý nghĩa thống kê và tác động mạnh yếu ra sao |
Ví dụ: Nếu bảng Omnibus cho kết quả có ý nghĩa thống kê nhưng bạn chỉ dừng ở đó mà không tick Hosmer-Lemeshow trong Options, bạn sẽ không biết liệu mô hình có thật sự khớp với dữ liệu quan sát hay không, vì hai kiểm định này trả lời hai câu hỏi khác nhau chứ không thay thế cho nhau. Cách viết cột Sig. của các bảng kiểm định này theo chuẩn APA cho phần kết quả luận văn được trình bày ở Sig. trong SPSS là gì, một cách đọc áp dụng nguyên vẹn cho bảng kết quả của hồi quy logistic.
Nagelkerke R bình phương và Cox & Snell R bình phương nghĩa là gì, đọc bao nhiêu là tốt?
Trả lời thẳng: Với biến phụ thuộc phân loại, không có một chỉ số R bình phương duy nhất như trong hồi quy tuyến tính, nên SPSS tính các chỉ số xấp xỉ là Cox and Snell R bình phương và Nagelkerke R bình phương. Các pseudo-R bình phương này không đo độ phù hợp mà cho biết mức độ hữu ích của biến giải thích, gần với độ lớn hiệu ứng hơn là độ phù hợp.
Bằng chứng: IBM (2025) mô tả IBM SPSS Statistics cung cấp ba chỉ số cho hồi quy logistic, gồm Cox and Snell R bình phương dựa trên log likelihood so với mô hình cơ sở nhưng có giá trị lý thuyết tối đa nhỏ hơn 1 ngay cả với một mô hình hoàn hảo, Nagelkerke R bình phương là bản điều chỉnh của Cox and Snell co giãn để phủ đủ khoảng từ 0 đến 1, và McFadden R bình phương dựa trên log-likelihood kernel của mô hình chỉ có hệ số chặn so với mô hình đầy đủ. Bewick, Cheek và Ball (2005) nói rõ các pseudo-R bình phương không đo độ phù hợp của mô hình mà cho biết mức độ hữu ích của các biến giải thích trong việc dự đoán biến kết quả, có thể coi là thước đo độ lớn hiệu ứng hơn là độ phù hợp, và minh hoạ bằng hai ví dụ trong cùng bài tổng quan: một mô hình có Cox and Snell R bình phương là 0,44 và Nagelkerke R bình phương là 0,59 được kết luận hữu ích trong việc dự đoán tử vong, còn một mô hình khác dù kiểm định Hosmer-Lemeshow cho kết quả phù hợp tốt với chi-square 7,325, bậc tự do 8 và p bằng 0,502, Nagelkerke R bình phương chỉ đạt 0,17 và tác giả kết luận mô hình không hữu ích lắm trong việc dự đoán dù các biến độc lập có ý nghĩa thống kê. University of California, Los Angeles, Office of Advanced Research Computing (OARC) Statistical Methods and Data Analytics (n.d.) nhấn mạnh các pseudo-R bình phương không được so sánh giữa hai mô hình khác biến kết quả hoặc khác bộ dữ liệu theo cách diễn giải như R bình phương của hồi quy tuyến tính, mà chỉ có ý nghĩa khi so sánh các mô hình cùng loại, cùng dữ liệu và cùng biến kết quả.
Ví dụ: Nếu luận văn của bạn báo cáo Hosmer-Lemeshow không có ý nghĩa thống kê nhưng Nagelkerke R bình phương chỉ ở mức 0,15, đừng vội kết luận mô hình sai, vì hai số này trả lời hai câu hỏi khác nhau, một cho biết mô hình có khớp dữ liệu hay không và một cho biết các biến dự báo hữu ích tới đâu trong việc dự đoán biến kết quả. Trước khi đưa biến tổng hợp từ một thang đo Likert nhiều câu hỏi vào mô hình hồi quy logistic làm biến dự báo, bạn cần kiểm tra độ tin cậy của thang đo đó trước, xem thêm ở kiểm định Cronbach's alpha là gì và alpha bao nhiêu là đạt.
Câu hỏi thường gặp
Mô hình hồi quy logistic là gì?
Đây là một mô hình thống kê ước lượng khả năng một trường hợp rơi vào nhóm nào trong số hai nhóm của biến kết quả, dựa trên các yếu tố đưa vào làm biến độc lập. Điểm khác biệt với hồi quy tuyến tính là biến kết quả chỉ có hai giá trị, nên đầu ra là một xác suất nằm giữa 0 và 1 chứ không phải một con số liên tục.
Exp(B) trong SPSS có phải là tỷ số rủi ro không?
Không nên đọc lẫn hai đại lượng này. Exp(B) là tỷ số chênh, tức odds ratio, không phải tỷ số rủi ro, tức risk ratio. Đây là sai lầm diễn giải phổ biến nhất khi đọc bảng Variables in the Equation. Hai đại lượng chỉ quy đổi được cho nhau khi biết tỷ lệ nền của nhóm tham chiếu, và chỉ xấp xỉ nhau khi sự kiện đang xét là hiếm gặp.
Hosmer-Lemeshow có ý nghĩa thống kê, tức p nhỏ hơn 0,05, nghĩa là mô hình tốt hay xấu?
Nghĩa là mô hình chưa khớp tốt với dữ liệu quan sát. Ngược lại, giá trị p lớn hơn 0,05 nghĩa là chưa có bằng chứng mô hình khớp kém với dữ liệu, chứ không phải bằng chứng chứng minh mô hình khớp tốt, vì kiểm định này còn nhạy với cỡ mẫu và cách chia nhóm khi tính toán. Kiểm định này không bật mặc định trong SPSS nên cần tự tick ở mục Options.
Nagelkerke R bình phương thấp có nghĩa là mô hình sai không?
Không nhất thiết. Một mô hình vẫn có thể khớp tốt với dữ liệu theo kiểm định Hosmer-Lemeshow trong khi Nagelkerke R bình phương thấp, vì hai chỉ số này đo hai khía cạnh khác nhau của mô hình. Nagelkerke R bình phương thấp cho thấy các biến dự báo chỉ hữu ích ở mức hạn chế trong việc dự đoán biến kết quả, tức độ lớn hiệu ứng nhỏ, chứ không đồng nghĩa mô hình bị sai kỹ thuật.
Khi nào nên dùng Method Enter thay vì stepwise trong SPSS?
Dùng Enter khi bạn đã xác định trước tập biến dự báo dựa trên khung lý thuyết hoặc nghiên cứu trước đó, đây là lựa chọn phù hợp cho phần lớn luận văn có mô hình khẳng định. Các tuỳ chọn stepwise chỉ nên dùng khi phân tích của bạn mang tính khám phá và bạn cần nêu rõ trong phần phương pháp rằng đây là cách chọn biến theo dữ liệu chứ không phải một kiểm định giả thuyết đã định trước.
MAAS hỗ trợ gì cho sinh viên đang chạy hồi quy logistic trong SPSS?
Chuyên gia MAAS hướng dẫn bạn kiểm tra giả định của dữ liệu, tự chạy mô hình hồi quy logistic trong SPSS và tự đọc các bảng Omnibus, Hosmer-Lemeshow và Exp(B), để bạn hiểu và bảo vệ được phân tích của mình theo mục tiêu điểm đã thống nhất. Buổi tư vấn đầu tiên kéo dài 15 phút và không tính phí. Xem thêm tại dịch vụ hướng dẫn chạy SPSS và Python, hoặc đặt lịch tại đây.
References
- Bewick, V., Cheek, L., & Ball, J. (2005). Statistics review 14: Logistic regression. Critical Care, 9(1), 112-118. https://doi.org/10.1186/cc3045
- CASRAI Editorial Board. (2026, August 29). Binary logistic regression in SPSS: Procedure and output. Retrieved September 17, 2026, from https://www.casrai.org/guides/binary-logistic-regression-in-spss
- IBM. (2025, January 15). Pseudo R square [SPSS Statistics 30.0 documentation]. Retrieved September 17, 2026, from https://www.ibm.com/docs/en/spss-statistics/30.0.0?topic=model-pseudo-r-square
- Laerd Statistics. (n.d.). How to perform a binomial logistic regression in SPSS Statistics. Retrieved September 17, 2026, from https://statistics.laerd.com/spss-tutorials/binomial-logistic-regression-using-spss-statistics.php
- Newcastle University IT Service. (n.d.). Binary logistic regression. Retrieved September 17, 2026, from https://services.ncl.ac.uk/itservice/research/dataanalysis/advancedmodelling/regressionanalysis/binarylogisticregression/
- spssfocus.com. (2025, October 11). Logistic regression in SPSS. Retrieved September 17, 2026, from https://spssfocus.com/logistic-regression-in-spss/
- University of California, Los Angeles, Office of Advanced Research Computing (OARC) Statistical Methods and Data Analytics. (n.d.). Logit regression | SPSS data analysis examples. Retrieved September 17, 2026, from https://stats.oarc.ucla.edu/spss/dae/logit-regression/
- University of California, Los Angeles, Office of Advanced Research Computing (OARC) Statistical Methods and Data Analytics. (n.d.). FAQ: What are pseudo R-squareds?. Retrieved September 17, 2026, from https://stats.oarc.ucla.edu/other/mult-pkg/faq/general/faq-what-are-pseudo-r-squareds/