
◆ Phương pháp nghiên cứu
Kiểm định chi bình phương SPSS: đọc bảng kết quả thế nào?
Trả lời thẳng: Kiểm định chi bình phương SPSS kiểm tra xem hai biến định tính có độc lập với nhau hay không, và bạn đọc dòng Pearson Chi-Square khi không quá 20% số ô có tần số kỳ vọng dưới 5 và không ô nào dưới 1. Nếu bảng 2×2 có ô dưới 5, hãy đọc dòng Fisher's Exact Test, rồi báo thêm Cramér's V để người đọc biết mối liên hệ mạnh đến đâu.
Bài này đi qua một bảng 2×2 có thật, lấy từ một thử nghiệm lâm sàng 25 bệnh nhân, và cho thấy cùng một bảng ấy cho p = 0,027, 0,070 hoặc 0,047 tuỳ dòng bạn chọn đọc. Sau đó bài trả lời câu hỏi mà phần lớn bảng kết quả trong luận văn né tránh: khi nào dòng Pearson đáng tin và khi nào không.
◆ Câu hỏi 1 / 8 · Kiểm định chi bình phương SPSS kiểm tra điều gì
Kiểm định chi bình phương SPSS kiểm tra điều gì, và dùng khi nào?
Trả lời thẳng: Kiểm định chi bình phương trong SPSS so sánh số đếm quan sát được với số đếm ta kỳ vọng nếu hai biến không liên quan gì đến nhau. Bạn dùng nó khi cả hai biến đều là biến định tính, mỗi đối tượng chỉ xuất hiện một lần trong bảng, và dữ liệu là số người chứ không phải phần trăm.
Kiểm định chi bình phương làm việc trên một bảng chéo, tức bảng đếm số đối tượng rơi vào từng tổ hợp của hai biến, chẳng hạn giới tính theo kết quả thi. Kim (2017) mô tả rằng kiểm định này và kiểm định Fisher cùng đánh giá tính độc lập giữa hai biến khi các nhóm so sánh là độc lập và không tương quan với nhau. Giả thuyết không là hai biến độc lập, còn giả thuyết đối là chúng có liên hệ.
Điều kiện đầu tiên dễ bị bỏ qua là tính độc lập của các quan sát. Jeong (2017) nhắc rằng nếu mỗi đối tượng không chỉ xuất hiện một lần, chẳng hạn cùng một người được hỏi trước và sau một khoá học, ta chuyển sang kiểm định McNemar chứ không chạy chi bình phương. Lỗi này tưởng hiếm nhưng vẫn có thật: Wu và cộng sự (2011) ghi nhận 10 bài năm 1998 và 12 bài năm 2008 dùng chi bình phương cho bảng bốn ô ghép cặp, và phần sau cho bạn xem con số ấy nằm ở đâu trong bức tranh chung.
Điều kiện thứ hai liên quan đến cỡ mẫu, và điều kiện này cần tính toán chứ không nhìn bảng là biết. Các phần sau sẽ quay lại nó, vì đó là nơi hầu hết lỗi nằm.
◆ Câu hỏi 2 / 8 · Các bài đã xuất bản dùng sai chi bình phương ở m
Các bài đã xuất bản dùng sai chi bình phương ở mức nào?
Trả lời thẳng: Có ba khảo sát mở toàn văn cho thấy lỗi này phổ biến trong cả bài báo lẫn luận án y khoa. Ở 62 luận án của Viện Ung thư Quốc gia Cairo, 50 luận án dùng chi bình phương và 44 lần dùng bị coi là sai. Ở các tạp chí Trung Quốc, tỉ lệ bảng chéo có lỗi giảm từ 48,3% xuống 32,3% nhưng chưa về 0.
| Nghiên cứu | Đối tượng khảo sát | Kết quả liên quan đến chi bình phương |
|---|---|---|
| Fong và cộng sự (2008) | Các nghiên cứu công bố năm 2008 và năm 2003 trong mẫu khảo sát của họ | 34 nghiên cứu (57%) và 46 nghiên cứu (62%) dùng chi bình phương hoặc Fisher. Trong số kiểm lại được, 82% (22 nghiên cứu) và 67% (28 nghiên cứu) có ít nhất một lần dùng chưa đạt |
| Allam và cộng sự (2017) | 62 luận án y khoa (MD) tại Viện Ung thư Quốc gia Cairo, bảo vệ 2009 đến 2013 | 50 luận án dùng chi bình phương, ghi nhận 44 lần dùng sai, trong đó 15 lần có tần số kỳ vọng dưới 1 và 18 lần có hơn 25% số ô dưới 5 |
| Wu và cộng sự (2011) | 1.335 bài năm 1998 và 1.578 bài năm 2008 của 10 tạp chí y khoa Trung Quốc | Trong số 319 bài (1998) và 523 bài (2008) dùng bảng chéo, 48,3% rồi 32,3% có lỗi. Thiếu hiệu chỉnh liên tục hoặc Fisher khi cần: 52 bài (16,3%) rồi 53 bài (10,1%) |
Nguồn: Fong và cộng sự (2008, tr. 42 và 47), Allam và cộng sự (2017) và Wu và cộng sự (2011).
Cần đọc ba kết quả này đúng độ nặng của chúng. Fong và cộng sự (2008, tr. 47) xét riêng các lần dùng chi bình phương và thấy 6 trên 20 lần ở năm 2008 (30,0%) cùng 7 trên 15 lần ở năm 2003 (46,7%) không thoả hai điều kiện về tần số kỳ vọng. Allam và cộng sự (2017, tr. 231) kết luận chung về luận án rằng "Statistical methods were appropriate in only 13 studies (24.5%)". Đối tượng của cả ba nghiên cứu là y khoa, không phải luận văn kinh tế hay giáo dục, và mỗi nghiên cứu đặt ngưỡng lỗi hơi khác nhau, nên hãy dùng chúng như dấu hiệu cho thấy lỗi có thật chứ không phải tỉ lệ áp được cho bài của bạn.
◆ Câu hỏi 3 / 8 · Chạy Crosstabs trong SPSS thế nào để có đủ số cầ
Chạy Crosstabs trong SPSS thế nào để có đủ số cần đọc?
Trả lời thẳng: Bạn chạy kiểm định chi bình phương trong SPSS bằng lệnh Crosstabs, và cần bật ba nhóm tuỳ chọn ngay từ đầu: Chi-square, Phi and Cramér's V và tần số kỳ vọng ở mục Cells. Nếu chỉ bấm OK với cài đặt mặc định, bạn sẽ không có đủ số để biết kết quả Pearson có đáng tin hay không.
- Vào Analyze > Descriptive Statistics > Crosstabs, đưa biến nguyên nhân hoặc biến nhóm vào ô Row(s) và biến kết quả vào ô Column(s).
- Bấm Statistics, tích Chi-square và Phi and Cramér's V, rồi Continue.
- Bấm Cells, tích Observed và Expected, thêm Row hoặc Column trong mục Percentages nếu muốn báo tỉ lệ, rồi Continue.
- Bấm OK, và đọc bảng Crosstabulation trước bảng Chi-Square Tests, vì bảng đầu cho bạn thấy từng ô quan sát và kỳ vọng.
Mỗi hàng của dữ liệu phải là một đối tượng, hai cột là hai biến đã mã hoá. Nếu bạn chỉ có sẵn bảng đếm, hãy dùng Weight Cases theo cột tần số trước khi chạy. Đừng nhập phần trăm vào ô, vì kiểm định dựa trên số người và phần trăm làm mất thông tin về cỡ mẫu. Nếu thao tác chạy thống kê mô tả còn lạ, hãy xem cách chạy thống kê mô tả trong SPSS trước, và nếu bạn chưa chắc biến của mình thuộc loại nào thì các loại thang đo trong SPSS sẽ giúp bạn chọn đúng biến cho hai ô Row và Column.
◆ Câu hỏi 4 / 8 · Tính tay một bảng 2×2: Pearson
Tính tay một bảng 2×2: Pearson, Yates và Fisher khác nhau ra sao?
Trả lời thẳng: Với cùng một bảng 2×2 của 25 bệnh nhân, Pearson cho p = 0,027, hiệu chỉnh liên tục Yates cho p = 0,070 và Fisher cho p = 0,047. Ba con số nằm hai phía của 0,05, dù mọi tần số kỳ vọng đều từ 5 trở lên, nên việc chọn dòng nào để đọc có thể đổi kết luận.
Fong và cộng sự (2008, tr. 43) dùng một thử nghiệm ngẫu nhiên có đối chứng làm ví dụ: 12 bệnh nhân đau cột sống cổ được chiếu súng hồng ngoại và 13 bệnh nhân dùng giả dược, rồi ghi nhận có cải thiện đau hay không.
| Súng hồng ngoại | Giả dược | Tổng | |
|---|---|---|---|
| Cải thiện đau | 9 | 4 | 13 |
| Không cải thiện | 3 | 9 | 12 |
| Tổng | 12 | 13 | 25 |
Nguồn: Fong và cộng sự (2008, bảng 1, tr. 43).
Tần số kỳ vọng của một ô bằng tổng hàng nhân tổng cột chia cho cỡ mẫu. Ô trái trên là 13 × 12 / 25 = 6,24, ô phải trên là 13 × 13 / 25 = 6,76, ô trái dưới là 12 × 12 / 25 = 5,76 và ô phải dưới là 12 × 13 / 25 = 6,24. Ô nhỏ nhất vẫn là 5,76, tức không ô nào dưới 5. Cộng bốn giá trị (O − E)² / E, gồm 1,221 + 1,127 + 1,323 + 1,221, ta được χ² = 4,891 với một bậc tự do, ứng với p = 0,027. Bỏ 0,5 khỏi mỗi độ lệch |O − E| trước khi bình phương, đó là hiệu chỉnh liên tục của Yates, thì χ² giảm xuống 3,279 và p tăng lên 0,070.
Về dòng Yates, chính Fong và cộng sự (2008, tr. 43) viết rằng "the correction alters the conclusion from significance to insignificance if we operate at 5% level of significance". Kiểm định chính xác của Fisher tính xác suất trực tiếp từ tất cả các bảng có cùng tổng hàng và tổng cột, và cho p = 0,047, trùng với giá trị Fong và cộng sự công bố. Lý do bạn thấy Pearson và Fisher lệch nhau ở bảng nhỏ là Pearson chỉ xấp xỉ, còn Fisher tính đúng.
Kết luận thực hành: bài này không kêu gọi chọn dòng cho ra p đẹp nhất, mà đòi bạn quyết định trước khi chạy xem mình báo dòng nào và giải thích vì sao.
◆ Câu hỏi 5 / 8 · Đọc bảng Chi-Square Tests và Symmetric Measures
Đọc bảng Chi-Square Tests và Symmetric Measures từng dòng thế nào?
Trả lời thẳng: Bạn đọc từ chú thích ở cuối bảng Chi-Square Tests trước, vì đó là nơi SPSS cho biết bao nhiêu ô có tần số kỳ vọng dưới 5. Sau đó chọn dòng phù hợp: Pearson khi chú thích ghi 0 ô, Fisher khi bảng 2×2 có ô dưới 5, rồi đọc Cramér's V ở bảng Symmetric Measures để biết độ mạnh.
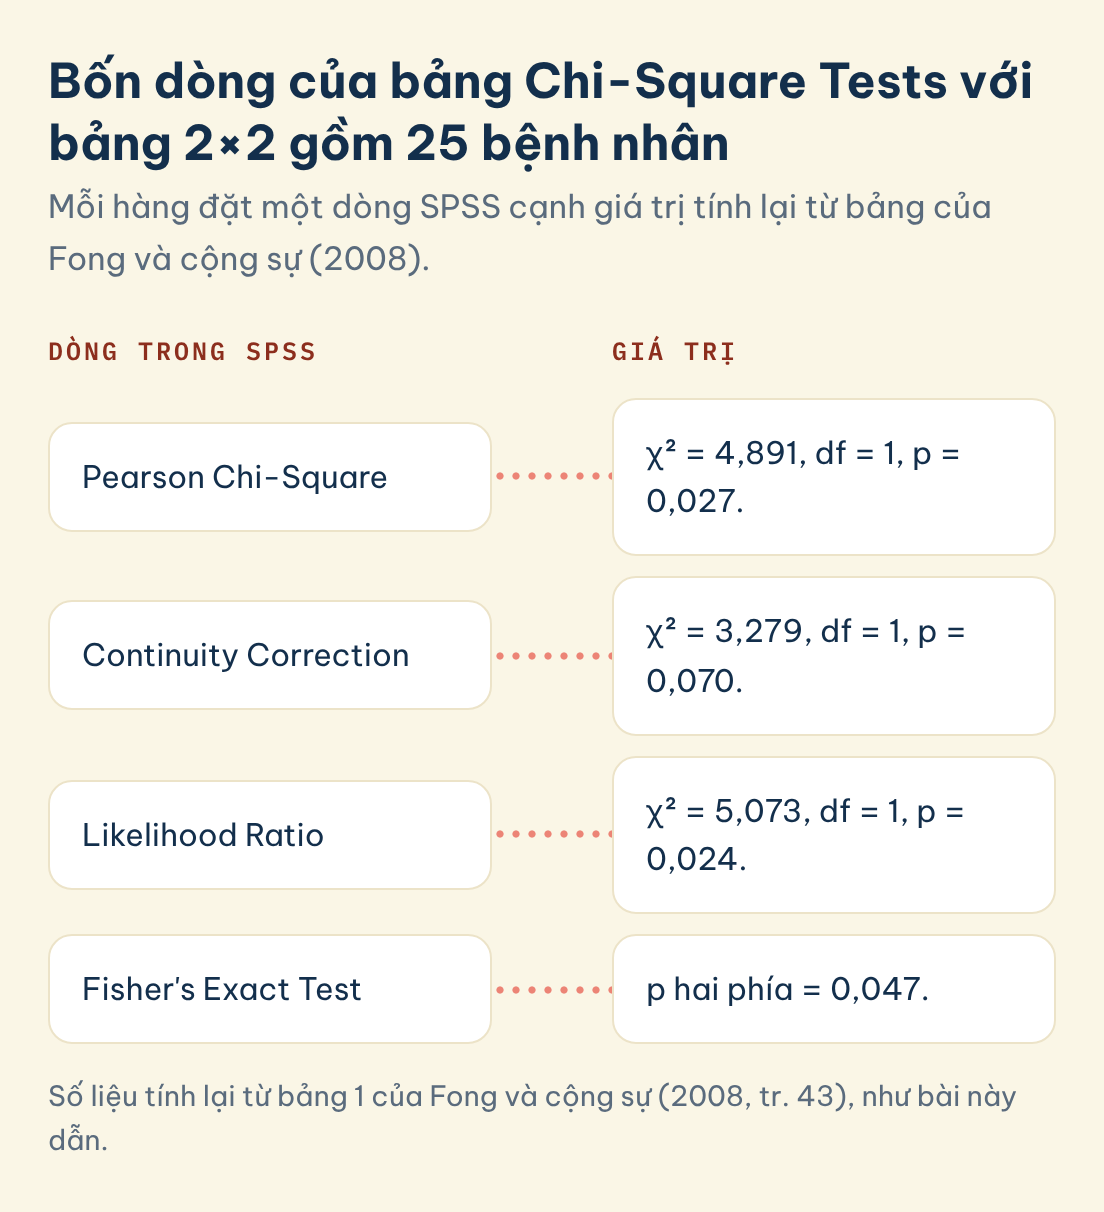
Với bảng thử nghiệm ở mục trước, các dòng của bảng Chi-Square Tests phải khớp với số đã tính tay. Mọi số dưới đây do bài này tính lại, và ba giá trị p khớp với giá trị Fong và cộng sự (2008, tr. 43) công bố.
| Dòng trong SPSS | Dùng khi nào | Giá trị với bảng 25 bệnh nhân |
|---|---|---|
| Pearson Chi-Square | Mọi tần số kỳ vọng đủ lớn | χ² = 4,891, df = 1, p = 0,027 |
| Continuity Correction | Chỉ có ở bảng 2×2, hiệu chỉnh Yates | χ² = 3,279, df = 1, p = 0,070 |
| Likelihood Ratio | Một dạng kiểm định khác cho cùng giả thuyết | χ² = 5,073, df = 1, p = 0,024 |
| Fisher's Exact Test | Bảng 2×2 nhỏ hoặc có ô kỳ vọng dưới 5 | p hai phía = 0,047 |
Nguồn: số liệu tính lại từ bảng 1 của Fong và cộng sự (2008, tr. 43). Khi nhập đúng bảng này, dòng tương ứng trong SPSS phải ra cùng con số.
Bốn dòng của bảng Chi-Square Tests với bảng 2×2 gồm 25 bệnh nhân
Mỗi hàng đặt một dòng SPSS cạnh giá trị tính lại từ bảng của Fong và cộng sự (2008).
Dòng trong SPSS
Giá trị
Pearson Chi-Square
χ² = 4,891, df = 1, p = 0,027.
Continuity Correction
χ² = 3,279, df = 1, p = 0,070.
Likelihood Ratio
χ² = 5,073, df = 1, p = 0,024.
Fisher's Exact Test
p hai phía = 0,047.
Lưu hình này
Chú thích dưới bảng có dạng "0 cells (0,0%) have expected count less than 5. The minimum expected count is 5,76". Van Auken và Kebschull (2021) nêu rằng kết quả CROSSTAB của SPSS đưa ra đúng dòng chú thích này, ví dụ với một bảng 2×3 họ ghi nhận giá trị kỳ vọng nhỏ nhất là 1,32. Ở bảng ví dụ, chú thích cho phép đọc Pearson, và kết quả có ý nghĩa thống kê ở mức 0,05 nhưng nằm sát ranh giới.
Cramér's V nằm ở bảng Symmetric Measures. Công thức là căn bậc hai của χ² chia cho n nhân k, trong đó k là số nhỏ hơn giữa số hàng trừ 1 và số cột trừ 1. Với bảng 2×2, k bằng 1 và V trùng với hệ số phi: căn của 4,891 / 25 cho 0,442. Kim (2017) đưa bảng ngưỡng cho V theo k: với k bằng 1, mức nhỏ là 0,10, vừa là 0,30 và lớn là 0,50, nên 0,442 nằm giữa mức vừa và mức lớn. Tỉ số chênh của bảng là 9 × 9 / (4 × 3) = 6,75. Nếu thấy cột Sig. hiện .000, bài Sig. trong SPSS là gì giải thích cách báo p < 0,001.
◆ Câu hỏi 6 / 8 · Khi tần số kỳ vọng dưới 5 thì dùng Fisher hay gộ
Khi tần số kỳ vọng dưới 5 thì dùng Fisher hay gộp nhóm?
Trả lời thẳng: Khi chú thích báo có ô kỳ vọng dưới 5, bạn không được báo dòng Pearson như thể nó đúng. Với bảng 2×2, hãy báo dòng Fisher. Với bảng lớn hơn, hãy gộp những nhóm gần nghĩa nhau nếu việc gộp có lý do chuyên môn, hoặc dùng kiểm định chính xác mà bản SPSS của bạn hỗ trợ.
Quy tắc phổ biến, mà Kroonenberg và Verbeek (2018) trích lại từ Cochran, là chấp nhận mức kỳ vọng tối thiểu bằng 1 nếu chỉ có tương đối ít ô dưới 5, chẳng hạn 1 ô trên 5 ô trở lên hoặc 2 ô trên 10 ô trở lên. Dạng phổ biến hơn trong giáo trình là không quá 20% số ô dưới 5 và không ô nào dưới 1. Van Auken và Kebschull (2021, tr. 2) dẫn lại nhận xét của chính Cochran rằng "numbers 10 and 5 appear to have been arbitrarily chosen", nghĩa là con số 5 là một quy ước tiện dụng chứ không phải ranh giới tự nhiên.
Để thấy hậu quả, hãy lấy một bảng giả định do bài này dựng, không phải dữ liệu của nghiên cứu nào. Hai mươi sinh viên được chia thành nhóm có luyện đề và nhóm không luyện đề: nhóm đầu có 1 người chưa đạt và 9 người đạt, nhóm sau có 6 người chưa đạt và 4 người đạt. Tần số kỳ vọng là 3,5 và 6,5 ở cả hai hàng, tức 2 trên 4 ô (50%) nằm dưới 5. Pearson cho χ² = 5,495 và p = 0,019, Likelihood Ratio cho p = 0,015, còn Yates cho p = 0,061 và Fisher cho p = 0,057. Trên bảng này, hai dòng đầu báo có ý nghĩa còn hai dòng sau thì không, và chính hai dòng sau là hai dòng đáng tin.
Có một bẫy ngược mà Jeong (2017) chỉ ra: nhiều người nhầm tần số quan sát với tần số kỳ vọng, thấy số 3 trong bảng đếm liền bỏ chi bình phương để chuyển sang Fisher. Chỉ sau khi tính tần số kỳ vọng của mọi ô ta mới quyết định được, và Fisher cũng có điều kiện riêng của nó, nên không phải thuốc chữa mọi bảng.
◆ Câu hỏi 7 / 8 · Viết kết quả kiểm định chi bình phương vào luận
Viết kết quả kiểm định chi bình phương vào luận văn thế nào?
Trả lời thẳng: Một câu báo cáo đủ gồm giá trị χ², bậc tự do, cỡ mẫu, giá trị p và độ lớn hiệu ứng, kèm tỉ lệ phần trăm ở từng nhóm. Với bảng 25 bệnh nhân, bạn viết rõ rằng điều kiện tần số kỳ vọng được thoả và nêu luôn Fisher như phép kiểm tra độ vững của kết luận.
Một cách viết cho bảng ở trên là: "Tỉ lệ cải thiện đau ở nhóm súng hồng ngoại (75,0%) cao hơn nhóm giả dược (30,8%), χ²(1, N = 25) = 4,89, p = 0,027, φ = 0,44. Kiểm định chính xác Fisher cho p = 0,047, còn hiệu chỉnh Yates cho p = 0,070, nên kết luận ở mức 0,05 cần được diễn giải thận trọng với cỡ mẫu 25." Câu cuối quan trọng hơn vẻ ngoài của nó, vì người chấm có thể tự tính lại và sẽ thấy ngay khi bạn chọn dòng một cách có lợi.
Bạn cũng nên ghi rõ bảng chéo gốc, tần số kỳ vọng nhỏ nhất và phần mềm cùng phiên bản đã dùng. Một chi tiết nhỏ nhưng thường bị bỏ sót là chi bình phương chỉ trả lời "có liên hệ hay không", còn câu hỏi "liên hệ giữa nhóm nào với nhóm nào" ở bảng lớn hơn 2×2 cần thêm so sánh từng cặp có hiệu chỉnh mức ý nghĩa. Wu và cộng sự (2011) đếm được 82 bài năm 1998 (25,7%) và 74 bài năm 2008 (14,2%) trong nhóm bảng chéo không điều chỉnh mức ý nghĩa khi so sánh nhiều lần. Nếu biến kết quả của bạn là điểm số liên tục chứ không phải nhóm, hãy cân nhắc kiểm định t trong SPSS hoặc kiểm định phi tham số trong SPSS, vì khi đó chi bình phương không phải công cụ phù hợp.
Câu hỏi thường gặp
Kiểm định chi bình phương và kiểm định Fisher khác nhau thế nào?
Chi bình phương tính p bằng một phép xấp xỉ cần mẫu đủ lớn, còn Fisher tính p chính xác từ các bảng có cùng tổng hàng và tổng cột. SPSS tự in dòng Fisher cho bảng 2×2, còn bảng lớn hơn thường cần thêm tuỳ chọn kiểm định chính xác.
Chú thích "expected count less than 5" trong SPSS có nghĩa là gì?
Nó cho biết bao nhiêu ô của bảng có tần số kỳ vọng thấp hơn 5 và giá trị kỳ vọng nhỏ nhất là bao nhiêu. Nếu tỉ lệ ô dưới 5 vượt 20% hoặc có ô dưới 1, dòng Pearson không còn đáng tin để báo.
Tôi nhập phần trăm thay cho số người vào Crosstabs được không?
Không. Kiểm định dùng số đếm, và phần trăm xoá mất thông tin về cỡ mẫu mà p phụ thuộc vào. Nếu chỉ có phần trăm, hãy quy ngược về số người từ cỡ mẫu từng nhóm trước khi chạy.
Cùng một người trả lời trước và sau thì chạy chi bình phương được không?
Không, vì hai lần đo của một người không độc lập với nhau. Với bảng 2×2 ghép cặp, kiểm định phù hợp là McNemar, như Jeong (2017) nêu.
Cramér's V bằng 0,25 là mạnh hay yếu?
Còn tuỳ k. Ở bảng 2×2, 0,25 nằm giữa mức nhỏ và mức vừa, còn ở bảng có k bằng 4, 0,25 đã là mức lớn theo bảng ngưỡng của Kim (2017).
Chuyên gia MAAS có làm thay phần phân tích SPSS của tôi không?
Không. Chuyên gia đi cùng bạn qua cách chạy và cách đọc kết quả trên dữ liệu của chính bạn, còn bạn giữ dữ liệu, chọn dòng cần báo và tự viết phần kết luận.
◆ Câu hỏi 8 / 8 · Cần ai đó soi lại bảng Crosstabs trước khi bạn n
Cần ai đó soi lại bảng Crosstabs trước khi bạn nộp chương kết quả?
Nhiều lỗi ở phần này chỉ lộ ra khi có người cùng nhìn vào đúng tệp dữ liệu và đúng bảng đầu ra, chẳng hạn một ô kỳ vọng rơi xuống 3,5 mà chú thích bị bỏ qua. Nếu muốn có người xem lại cách bạn mã hoá biến, chọn dòng cần báo và viết câu kết quả, dịch vụ hỗ trợ phân tích dữ liệu SPSS và Python của MAAS cho phép bạn làm việc với một chuyên gia thống kê trên chính dữ liệu của mình.
Bạn vẫn là người sở hữu dữ liệu, quyết định kiểm định nào phù hợp với thiết kế nghiên cứu và chịu trách nhiệm về kết luận trong bài nộp. Chuyên gia chỉ giúp bạn hiểu vì sao một dòng được chọn thay cho dòng kia, để khi hội đồng hỏi bạn trả lời được bằng chính lập luận của mình.
Bài liên quan
Bốn bài dưới đây nằm cùng chuỗi thao tác SPSS với bài này, nên đọc bài nào khớp với bước bạn đang kẹt thay vì đọc tuần tự.
- Sig. trong SPSS là gì?: giải thích cách đọc cột Sig. và cách báo p-value theo chuẩn APA, kèm trường hợp Sig. hiện .000
- Kiểm định t trong SPSS: dùng khi biến kết quả là thang đo liên tục và bạn so sánh hai nhóm thay vì hai biến định tính
- Kiểm định phi tham số trong SPSS: các lựa chọn khi dữ liệu không đạt giả định của kiểm định tham số
- Biến độc lập và biến phụ thuộc trong SPSS: giúp bạn đặt đúng biến vào ô Row và Column trước khi chạy Crosstabs
Tài liệu tham khảo
- Allam, R. M., Noaman, M. K., Moneer, M. M., & Elattar, I. A. (2017). Assessment of statistical methodologies and pitfalls of dissertations carried out at National Cancer Institute, Cairo University. Asian Pacific Journal of Cancer Prevention, 18(1), 231–237. https://doi.org/10.22034/APJCP.2017.18.1.231
- Fong, D. Y. T., Lee, C. F., & Lau, S. P. (2008). Contingency table analysis in obstetrics and gynaecology. Hong Kong Journal of Gynaecology, Obstetrics and Midwifery, 8(1), 42–50. https://hkjgom.org/home/article/view/84
- Jeong, H. J. (2017). Rethinking the assumptions of chi-squared and Fisher's exact tests. Biometrics & Biostatistics International Journal, 6(1). https://doi.org/10.15406/bbij.2017.06.00159
- Kim, H.-Y. (2017). Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test. Restorative Dentistry & Endodontics, 42(2), 152–155. https://doi.org/10.5395/rde.2017.42.2.152
- Kroonenberg, P. M., & Verbeek, A. (2018). The tale of Cochran's rule: My contingency table has so many expected values smaller than 5, what am I to do? The American Statistician, 72(2), 175–183. https://doi.org/10.1080/00031305.2017.1286260
- Van Auken, R. M., & Kebschull, S. A. (2021). Type I error convergence of three hypothesis tests for small RxC contingency tables. RMS: Research in Mathematics & Statistics, 8(1), Article 1934959. https://doi.org/10.1080/27658449.2021.1934959
- Wu, S., Jin, Z., Wei, X., Gao, Q., Lu, J., Ma, X., Wu, C., He, Q., Wu, M., Wang, R., Xu, J., & He, J. (2011). Misuse of statistical methods in 10 leading Chinese medical journals in 1998 and 2008. The Scientific World Journal, 11, 2106–2114. https://doi.org/10.1100/2011/139494
Buổi tư vấn miễn phí 20 phút là một cuộc trao đổi về việc bạn đang ở đâu với bài của mình.
Đặt lịch tư vấn miễn phí ▸