
Công cụ phát hiện văn AI không có một mức chính xác chung cho mọi trường hợp, và chúng sai nhiều nhất với người viết bằng ngôn ngữ thứ hai, nhóm mà nghiên cứu được trích nhiều nhất ghi nhận tỉ lệ dương tính giả trung bình tới 61,22%. Con số do công cụ trả về lại thường bị đọc như một phán quyết, trong khi một lời buộc tội oan có thể dẫn tới phiên điều trần kỷ luật học thuật hoặc một hồ sơ bị ghi vết, và Vanderbilt University đã tự kiểm tra công cụ của mình rồi tắt hẳn nó đi.
Bài viết này tập hợp bằng chứng bình duyệt để bạn biết những công cụ đó sai thường tới mức nào, vì sao người viết đa ngữ chịu rủi ro nặng nhất, và nên làm gì nếu essay hay assignment của mình bị gắn cờ.
Tác giả: Ban Biên tập MAAS
Cập nhật lần cuối: 2026-08-28
Chuyên mục: academic-integrity
Có một tỉ lệ dương tính giả chung cho mọi công cụ phát hiện AI không?
Trả lời trực tiếp: Không có một con số độ chính xác duy nhất cho các công cụ phát hiện văn AI, bởi tỉ lệ dương tính giả dao động rộng tuỳ công cụ, tuỳ mẫu văn bản và tuỳ thiết lập. Dương tính giả là khi công cụ gán nhãn AI cho đoạn văn do chính con người viết. Hiện tượng đó có thật, không hiếm, và rơi nặng nhất lên sinh viên không viết bằng tiếng mẹ đẻ.
Điều đầu tiên các nghiên cứu cho thấy là chúng không đồng ý với nhau, và chính sự bất đồng ấy mới là phát hiện chứ không phải một cước chú bên lề. Vài đánh giá báo cáo mức sai cao tới ngưỡng khiến một công cụ không còn dùng được để chấm bài, còn ít nhất một khảo sát quy mô lớn lại báo cáo không có ca sai nào trên mẫu của họ. Như Elkhatat và cộng sự (2023) cùng Gosling và cộng sự (2024) cho thấy, cả hai kết quả cùng đúng được, vì chúng thử những sản phẩm khác nhau, trên những loại văn bản khác nhau, với những ngưỡng khác nhau. Công cụ nào chỉnh để gần như không bao giờ bỏ lọt văn AI thì sẽ gắn cờ oan nhiều văn người hơn, còn công cụ chỉnh theo hướng gần như không bao giờ buộc tội oan thì lại để lọt nhiều văn AI hơn. Đánh đổi đó nằm sẵn trong cách các sản phẩm này vận hành, nên một chỉ số nghe rất yên tâm, nhất là chỉ số do chính nhà cung cấp trích ra, nói được rất ít về trường hợp cụ thể đang nằm trước mặt bạn.
Cũng vì đánh đổi đó mà câu hỏi hữu ích không phải là công cụ phát hiện AI chính xác đến đâu nói chung. Câu hỏi đáng hỏi là loại công cụ này đọc nhầm loại người viết này thường xuyên tới mức nào, và ở đó thì bằng chứng sắc nét hơn hẳn.
Người viết đa ngữ bị công cụ đọc nhầm thường tới mức nào?
Trả lời trực tiếp: Nghiên cứu được trích nhiều nhất thử bảy công cụ phát hiện GPT trên 91 bài luận TOEFL của người không phải bản ngữ và 88 bài của học sinh lớp tám ở Mỹ. Với bài người bản ngữ, kết quả chính xác. Nhóm còn lại có tỉ lệ dương tính giả trung bình 61,22%, trong đó 19,78% bị cả bảy công cụ gắn cờ và 97,8% bị ít nhất một công cụ.
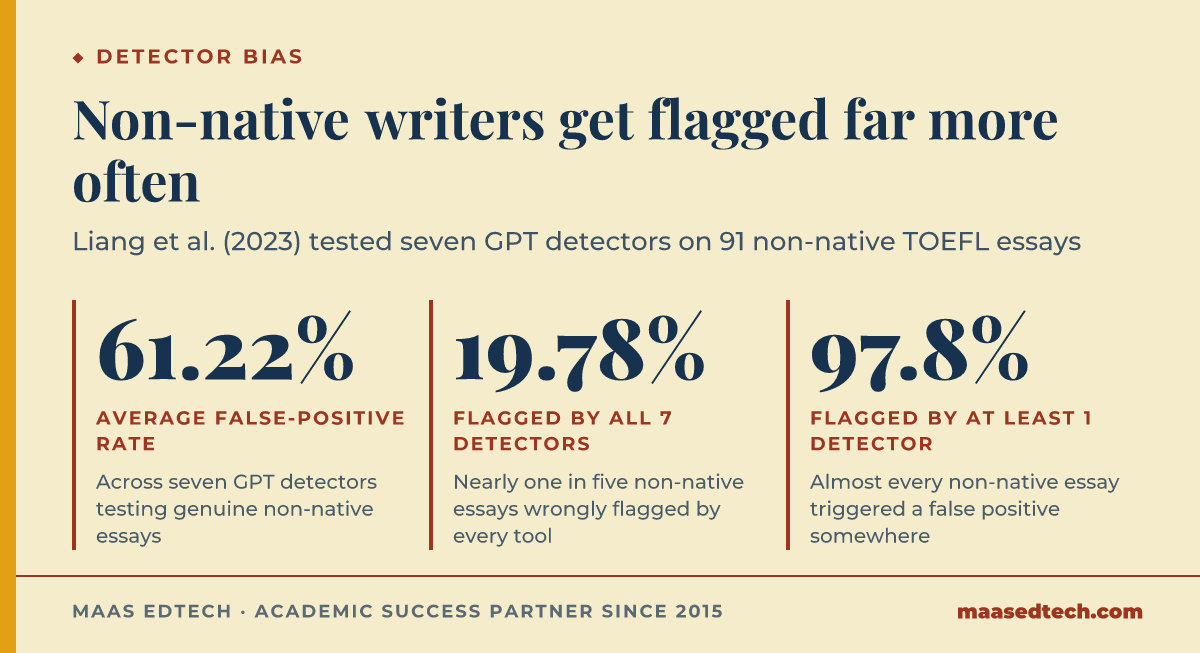
Trong công trình được trích dẫn nhiều nhất về câu hỏi này, Liang và cộng sự (2023) đem bảy bộ phát hiện GPT phổ biến ra thử trên 91 bài luận TOEFL do người học tiếng Anh như ngôn ngữ thứ hai viết và 88 bài luận do học sinh lớp tám ở Mỹ viết. Ở nhóm bản ngữ, các công cụ gần như không sai. Ở nhóm còn lại, toàn bộ bài đều do người thật viết, vậy mà tỉ lệ báo nhầm trung bình lên tới 61,22%. Theo Liang và cộng sự (2023), gần một phần năm số bài đó, chính xác là 19,78%, bị cả bảy công cụ cùng lúc kết luận là văn máy, và 97,8% dính cờ của ít nhất một công cụ.
Cơ chế đằng sau cho thấy đây không phải một trục trặc ngẫu nhiên. Nhiều công cụ chấm một đoạn văn theo perplexity, tức thước đo mức độ bất ngờ hay đa dạng của các lựa chọn từ. Liang và cộng sự (2023) giải thích rằng người viết bằng ngôn ngữ thứ hai thường dùng vốn từ và cấu trúc câu hẹp hơn, dễ đoán hơn, nên perplexity thấp, và công cụ đọc mức thấp đó thành dấu hiệu của máy. Nói cách khác, chính đặc điểm dùng để tố văn AI cũng là đặc điểm của một người đang viết cẩn thận bằng thứ tiếng mình chưa thật thuần thục. Nhóm sinh viên ít có khả năng chịu đựng một cáo buộc kỷ luật nhất lại là nhóm bị công cụ nghi ngờ nhiều nhất.
Nhà nghiên cứu và thesis của họ có gặp cùng vấn đề đó không?
Trả lời trực tiếp: Giray (2024) tìm thấy đúng thiên lệch ấy ở giới học giả khắp thế giới, khi dương tính giả dồn về người không bản ngữ và người có lối viết riêng biệt. Hậu quả ở bậc này là chất vấn treo lên thesis, dissertation hoặc bản thảo, chứ không phải điểm bị chặn trần. Nhà nghiên cứu sợ bị gắn cờ hay tự làm phẳng giọng văn, mà cách đó chỉ khiến điểm số xấu thêm.
Bằng chứng phía trên lấy từ bài luận, nhưng nhóm phơi nhiễm không chỉ có sinh viên đại học. Giray (2024) khảo sát trải nghiệm của các học giả tại nhiều cơ sở trên thế giới và thấy cùng một độ lệch, khi báo nhầm dồn về phía người không nói tiếng Anh bản ngữ và về phía những nhà nghiên cứu có văn phong riêng biệt. Ở bậc đó, hậu quả không còn là một mức điểm bị chặn trần. Nó là một câu chất vấn gắn vào thesis, vào bản thảo hoặc vào hồ sơ nghiên cứu, do một hội đồng hay một tổng biên tập phán xử, và người phán xử ấy có khi chưa hề có quy trình thành văn nào để xử lý một điểm số đang bị phản đối.
Mức phơi nhiễm còn rộng hơn nhóm du học sinh mà cuộc tranh luận này hay nhắc tới. Các chương trình thạc sĩ và tiến sĩ ở Đài Loan, Hàn Quốc, Nhật Bản và Hồng Kông đều giảng dạy, thi cử và công bố bằng tiếng Anh, nên học viên viết toàn bộ văn bản học thuật chính thức bằng ngôn ngữ thứ hai trong khi sinh hoạt hằng ngày bằng một thứ tiếng khác. Mọi cơ chế trong kết quả của Liang và cộng sự (2023) áp vào họ đầy đủ.
Giray (2024) còn chỉ ra một cái giá mà thống kê độ chính xác không đo được. Nhà nghiên cứu lo bị gắn cờ bắt đầu tự làm phẳng giọng văn của mình, đơn giản hoá từ vựng và cấu trúc để trông bớt khả nghi. Đó lại đúng là thay đổi mà Liang và cộng sự (2023) chứng minh là làm điểm của công cụ tệ hơn chứ không tốt lên, nên phản ứng phòng thủ này nuôi lớn chính vấn đề nó định giải quyết.
Tỉ lệ dương tính giả một phần trăm có thật sự nhỏ không?
Trả lời trực tiếp: Turnitin công bố tỉ lệ dương tính giả khoảng 1% cho bộ phát hiện AI của họ. Vanderbilt University chỉ ra rằng với chừng 75.000 bài trường đã nộp qua hệ thống đó trong năm trước, con số ấy hàm ý khoảng 750 bài do sinh viên thật sự viết bị gắn nhãn AI oan, và đây chính là lý do trường kết luận công cụ không đủ tin cậy rồi tắt nó đi.
Dữ liệu ở cấp cơ sở đào tạo nói cùng một điều nhưng ở quy mô lớn hơn. Khi Turnitin ra mắt bộ phát hiện AI, họ công bố tỉ lệ báo nhầm vào khoảng một phần trăm. Vanderbilt University ghi lại nguyên văn rằng "at the time of launch, Turnitin claimed that its detection tool had a 1% false positive rate" (Vanderbilt University, 2023), tức vào thời điểm ra mắt, Turnitin tuyên bố công cụ của mình có tỉ lệ dương tính giả 1%. Trường chỉ ra điều đó có nghĩa gì với một cơ sở đào tạo có thật, khi họ đã gửi khoảng 75.000 bài qua hệ thống này trong năm học trước, nên một phần trăm báo nhầm tương đương chừng 750 bài viết thật của sinh viên bị quy là văn máy. Vanderbilt University (2023) kết luận công cụ chưa đủ tin cậy để dùng cho đánh giá học tập và đã vô hiệu hoá nó. Một tỉ lệ nghe có vẻ nhỏ lập tức biến thành hàng trăm con người cụ thể khi nó gặp một khoá sinh viên thật, và từng người trong số đó phải tự chứng minh một điều không xảy ra, dưới áp lực.
Vanderbilt không phải cơ sở duy nhất lùi lại trước việc phát hiện AI tự động trong giai đoạn này, và hướng dẫn mà Vanderbilt University (2023) công bố đến nay vẫn là một trong những phát biểu rõ ràng nhất về lý do một tỉ lệ lỗi trông thấp trên giấy vẫn có thể không chấp nhận được trên thực tế.
Turnitin từ đó đã đổi cách hiển thị. Từ ngày 8 tháng Bảy năm 2024, công cụ này không còn đưa ra tỉ lệ phần trăm nào cho những bài rơi vào khoảng từ 1% tới 19% chữ AI, mà thay bằng một dấu sao, với lý do được nêu là dương tính giả xuất hiện nhiều hơn ở dải đó. Turnitin (2024) cũng cho biết độ dài tối thiểu để chấm điểm AI đã được nâng từ 150 từ lên 300. Trong một công bố riêng, Turnitin (2023) đưa ra tỉ lệ dương tính giả ở cấp câu vào khoảng 4%, nghĩa là cứ 100 câu bị bôi sáng thì chừng 4 câu là do người viết, và cho biết 54% số câu đó nằm ngay cạnh văn bản AI thật. Ai còn dẫn con số "1%" của thời mới ra mắt là đang dẫn một con số mà chính nhà cung cấp đã đính chính theo ba hướng khác nhau.
Ở Anh, mức dùng AI tăng lên thì nhóm dễ bị đọc nhầm chịu ảnh hưởng gì?
Trả lời trực tiếp: Khảo sát sinh viên năm 2026 của HEPI ghi nhận 94% sinh viên đại học ở Anh dùng AI cho bài được chấm điểm, và tỉ lệ bài nộp có chứa văn do AI sinh ra tăng từ 3% năm 2024 lên 8% năm 2025 rồi 12% năm 2026. Mức dùng tăng thì áp lực phát hiện cũng tăng, mà khoá học ở Anh lại đông người viết bị công cụ đọc nhầm.
Những phát hiện về thiên lệch ở trên hay bị đọc như chuyện riêng của nước Mỹ, nhưng các điều kiện khiến chúng trở nên hệ trọng cũng hiện diện trong hệ thống giáo dục Anh. Trong khảo sát AI tạo sinh trong sinh viên năm 2026 của HEPI, Stephenson và Armstrong (2026) cho biết 95% sinh viên đại học dùng AI theo ít nhất một cách nào đó và 94% dùng nó để hỗ trợ bài được chấm điểm, trong khi tỉ lệ đưa hẳn văn do AI sinh ra vào bài nộp đã đi từ 3% năm 2024, qua 8% năm 2025, tới 12% năm 2026. Cũng theo Stephenson và Armstrong (2026), gần hai phần ba, tức 65%, nói rằng bản thân cách đánh giá đã thay đổi đáng kể để ứng phó với AI. Mức dùng AI thật đang leo lên, và áp lực thể chế phải phát hiện nó leo theo.
Hai hệ quả nảy ra cho các trường ở Anh. Thứ nhất, Stephenson và Armstrong (2026) ghi nhận trong cùng khảo sát đó rằng sinh viên bày tỏ lo lắng về chuyện bị buộc tội gian lận học thuật oan. Nỗi lo ấy là cái giá con người của những tỉ lệ báo nhầm đã dẫn ở trên, và nó xuất hiện từ rất lâu trước khi có bất kỳ phiên điều trần nào. Hệ quả thứ hai liên quan tới việc ai đang ngồi trong phòng học, bởi các đại học Anh tuyển một lượng lớn sinh viên quốc tế, nên nhóm dễ bị một công cụ dựa trên perplexity đọc nhầm nhất lại chiếm một phần đáng kể của khoá chứ không phải một ca cá biệt. Một tỉ lệ lỗi nghe có vẻ chấp nhận được trên lý thuyết lại không hề phân bố đều lên những sinh viên phải gánh nó.
Có nghiên cứu nào thấy công cụ phát hiện AI không báo nhầm không?
Trả lời trực tiếp: Bằng chứng không nghiêng về một phía. Một nghiên cứu ghi nhận một công cụ phổ biến không tạo dương tính giả nào trên 160 bài tập thật của sinh viên. Nhà cung cấp cũng công bố phản biện bác bỏ cáo buộc thiên lệch. Một đánh giá rộng hơn thấy mức báo nhầm thiếu nhất quán chứ không cao đều, khi công cụ này gắn cờ mẫu văn người còn công cụ kia thì không.
Đọc cho ngay thẳng thì phải giữ cả những kết quả ngược chiều, và chính chúng khiến bài này không thành một lời than một chiều. Gosling và cộng sự (2024) ghi nhận một bộ phát hiện AI tạo sinh được dùng rộng rãi không cho ra dương tính giả nào trên 160 bài tập có thật của sinh viên, và mọi bài do người viết đều nhận điểm khả năng là văn máy bằng không. Các nhà cung cấp công cụ cũng đã công bố những bài phản biện lập luận rằng sản phẩm của họ không thiên lệch với người viết không bản ngữ. Đánh giá rộng hơn của Elkhatat và cộng sự (2023) trên nhiều công cụ thì cho thấy hành vi báo nhầm thiếu nhất quán chứ không cao đều, khi sản phẩm này gắn cờ vài mẫu văn người trong khi sản phẩm khác thì không.
Gộp lại, những kết quả này không xoá bỏ các phát hiện về thiên lệch, chúng chỉ giới hạn phạm vi của những phát hiện đó. Chúng cho thấy một công cụ được cấu hình tốt, trên một mẫu cụ thể, có thể chạy sạch, trong khi công cụ khác trên mẫu khác, nhất là mẫu văn của người không bản ngữ, lại chạy rất tệ. Kết luận có trách nhiệm không phải là các công cụ phát hiện luôn luôn sai. Kết luận đúng mực hơn là đầu ra của một công cụ chỉ là một tín hiệu xác suất với tỉ lệ lỗi có thật và phân bố không đều, chứ tự nó không chứng minh được điều gì.
Máy dò sai nặng nhất ở những việc nào mà du học sinh vẫn làm?
Trả lời trực tiếp: Phép thử độc lập lớn nhất với nhóm công cụ này trải trên 14 máy dò và 756 lượt chạy, không máy nào chạm mốc 80% chính xác (Weber-Wulff và cộng sự, 2023). Độ chính xác tụt 20 điểm phần trăm khi tác giả viết bằng tiếng mẹ đẻ rồi cho máy dịch, còn chữ AI đưa qua công cụ diễn đạt lại chỉ bị bắt 26% số lần.
Weber-Wulff và cộng sự (2023) đưa 12 máy dò công khai cùng hai hệ thống thương mại qua 54 văn bản chuẩn bị sẵn, tổng cộng 756 lượt kiểm riêng lẻ, rồi công bố kết quả trên International Journal for Educational Integrity. Mọi công cụ đều nằm dưới 80% chính xác và chỉ có năm công cụ vượt được mốc 70%. Riêng điều đó đã đủ để khép lại câu hỏi liệu có điểm số nào hiện nay đủ sức phán quyết hay không.
Hai phát hiện đáng kể nhất với du học sinh nói về hành vi cụ thể chứ không nói về con số trung bình. Với văn bản do người viết thẳng bằng tiếng Anh, các công cụ đạt 96% chính xác. Weber-Wulff và cộng sự (2023) thấy rằng với văn bản người viết bằng một thứ tiếng khác rồi đưa qua máy dịch, độ chính xác tụt 20 điểm phần trăm. Nhóm tác giả ghi rằng máy dịch "để lại một vài dấu vết của AI trong bản đầu ra, ngay cả khi bản gốc hoàn toàn do người viết". Viết nháp bằng tiếng Việt rồi dịch sang tiếng Anh là cách làm bình thường và hợp lệ, vậy mà chính nó đẩy một sinh viên trung thực về phía bị gắn cờ.
Nửa còn lại của bức tranh mới là phần khó chịu hơn. Theo Weber-Wulff và cộng sự (2023), chữ do AI sinh ra rồi được người sửa nhẹ chỉ bị nhận diện đúng 42% số lần, còn chữ AI đi qua một công cụ diễn đạt lại thì chỉ bị bắt 26%. Khoảng 20% chữ AI để nguyên bị gán nhầm thành của người, và tỉ lệ đó lên tới chừng 50% một khi có bất kỳ thao tác che giấu nào.
Ghép hai nửa lại thì quy luật hiện ra đi ngược hẳn công dụng mà những công cụ này được bán ra. Che giấu có chủ đích thì phần lớn thời gian qua mặt được chúng, trong khi viết bằng ngôn ngữ thứ hai một cách trung thực và dịch một cách trung thực lại đẩy điểm số đi sai hướng. Một máy dò hành xử như vậy không tách được gian lận khỏi không gian lận. Nó chỉ tách thứ văn bản trông giống người bản ngữ về mặt thống kê ra khỏi thứ văn bản không giống.
Thực tế có bao nhiêu sinh viên bị bắt, và điều đó nói gì về những lần gắn cờ?
Trả lời trực tiếp: Một cuộc điều tra theo luật tự do thông tin trên 155 trường đại học ở Anh ghi nhận gần 7.000 ca gian lận bằng AI trong năm học 2023/24, tức 5,1 ca trên 1.000 sinh viên, so với 1,6 của năm trước và đang hướng tới chừng 7,5 (Goodier, 2025). Đạo văn kiểu cũ thì đi xuống, từ 19 còn 15,2 ca trên 1.000.
Goodier (2025) xin dữ liệu vi phạm học thuật từ 155 trường đại học ở Anh theo Đạo luật Tự do Thông tin, và 131 trường trong số đó trả lời kèm ít nhất một phần số liệu. Số ca gian lận bằng công cụ AI đã được chứng minh chạm mức gần 7.000 trong năm học 2023/24, tương đương 5,1 trên 1.000 sinh viên, so với 1,6 trên 1.000 của năm 2022/23. Số liệu một phần tính tới tháng Năm của năm kế tiếp cho thấy mức khoảng 7,5 trên 1.000. Cũng trong khung thời gian đó, đạo văn theo kiểu cũ đã được xác nhận giảm từ 19 xuống 15,2 ca trên 1.000 sinh viên và đang trên đà giảm tiếp về chừng 8,5.
Một chi tiết về phương pháp trong cuộc điều tra đó đáng chú ý ngang với con số giật tít. Goodier (2025) cho biết hơn 27% số trường có trả lời đã không ghi nhận riêng các ca lạm dụng AI, mà gộp chung với các vi phạm khác trong năm 2023/24. Bức tranh toàn quốc vì thế được ghép lại từ những cơ sở đếm theo các cách khác nhau, nên đem hai trường ra đặt cạnh nhau là đang so hai lối ghi chép chứ không chỉ so hai tập thể sinh viên.
Có một phép tính đáng làm ở đây, và các giả định của nó xin đặt sẵn lên bàn. Turnitin (2023) công bố tỉ lệ dương tính giả ở cấp văn bản là dưới 1% với những bài mà công cụ phát hiện từ 20% chữ AI trở lên. Áp vào một khoá 1.000 sinh viên mà mỗi người nộp một bài, một tỉ lệ nằm đúng ở mức trần đó sẽ cho ra khoảng 10 bài bị gắn cờ oan. Cả ngành giáo dục đại học Anh trong cùng kỳ chỉ xác nhận được 5,1 ca AI trên 1.000 sinh viên. Với những con số ấy, số lần gắn cờ oan ở chính mức nhà cung cấp tự công bố sẽ nhiều hơn số ca đã xác nhận khoảng gấp đôi.
Phép so đó là một minh hoạ về bậc độ lớn chứ không phải một phép đo, và có ba điều cần giữ nó đúng chỗ. Một lần gắn cờ không phải một ca, bởi vì có người thật xem lại trước khi bất cứ thủ tục chính thức nào bắt đầu. Các ca đã xác nhận đến từ nhiều đường khác nhau chứ không riêng từ điểm số của máy dò. Và sinh viên nộp nhiều hơn một bài mỗi năm, điều này làm dịch chuyển con số ở cả hai cột. Thứ sống sót qua cả ba điều đó là hình dạng của sự việc, tức là phần sai số và phần xử lý có cùng một cỡ. Một tín hiệu nhiễu tới mức ấy thì tự nó không gánh nổi một kết luận, và chính số liệu của ngành nói ra điều đó.
Tổng lại thì bằng chứng nói gì?
Trả lời trực tiếp: Ba khẳng định trụ được sau khi soi kỹ. Thứ nhất là dương tính giả có thật, và ở một số công cụ và mẫu thì phổ biến chứ không bên lề. Thứ hai là lỗi phân bố không đều, khi người viết đa ngữ và người không bản ngữ hứng phần lớn hơn hẳn. Thứ ba là tỉ lệ dao động giữa các công cụ, nên đừng đọc một điểm số như một phán quyết.
Đặt các nghiên cứu cạnh nhau, ba khẳng định trụ được. Trước hết, báo nhầm là hiện tượng có thật, và dữ liệu của Liang và cộng sự (2023) lẫn Elkhatat và cộng sự (2023) cho thấy trên một số công cụ cùng một số mẫu thì nó phổ biến chứ không phải chuyện bên lề. Tiếp theo, lỗi không rải đều, bởi người viết đa ngữ và người không bản ngữ hứng nhiều hơn hẳn, vì một lý do mà Liang và cộng sự (2023) chỉ ra là nằm sẵn trong cách các công cụ đo văn bản. Cuối cùng, tỉ lệ này không ổn định giữa các công cụ và các thiết lập, như kết quả trái chiều của Elkhatat và cộng sự (2023) với Gosling và cộng sự (2024) cho thấy, nên không bao giờ nên đọc một điểm số đơn lẻ như một phán quyết. Vanderbilt University (2023) cũng đi tới đúng kết luận ấy, chỉ là từ hướng ngược lại, khi tắt bộ phát hiện của chính trường.
Hệ quả thực hành thì khiêm tốn và bảo vệ được. Một điểm số phát hiện AI là lý do để xem xét kỹ hơn, chứ không bao giờ là lý do để tự nó kết luận rằng sinh viên đã gian lận. Chính chỗ phân biệt đó làm nên toàn bộ khác biệt giữa một quy trình công bằng và một quy trình không công bằng.
Nên làm gì nếu chính bài của bạn bị gắn cờ?
Trả lời trực tiếp: Nếu bạn tự viết mà công cụ vẫn báo AI, bằng chứng trên đứng về phía bạn. Điểm phát hiện AI đang bị tranh cãi trong nghiên cứu, mang theo vấn đề dương tính giả đã ghi nhận, và có đại học bác bỏ hẳn. Lớp bảo vệ mạnh nhất là bằng chứng thường ngày về quá trình làm bài, gồm bản nháp, lịch sử phiên bản, ghi chú và khả năng nói lại lập luận.
Khi một công cụ kết luận rằng bài bạn tự viết là văn máy, toàn bộ bằng chứng ở trên trở thành bối cảnh cho trường hợp của bạn. Một điểm số phát hiện AI đơn lẻ đang bị tranh cãi trong tài liệu nghiên cứu, mang theo một vấn đề báo nhầm đã được ghi nhận, và bị các trường từng soi kỹ nó đối xử rất dè dặt hoặc bác bỏ thẳng. Bài đi kèm của MAAS về vì sao bài bạn tự viết vẫn bị gắn cờ là AI trình bày cách các công cụ đi tới phán đoán đó cùng các bước xử lý cụ thể, còn bài về ý nghĩa thật sự của điểm tương đồng nói về con số bên cạnh mà sinh viên hay nhầm với điểm AI.
Thứ bảo vệ bạn tốt nhất là những dấu vết rất bình thường của quá trình làm bài, như các bản nháp, lịch sử chỉnh sửa, ghi chú riêng, và việc bạn trình bày lại được mạch lập luận của mình. Nếu bạn đang chuẩn bị cho một buổi giải trình hoặc đang phải trả lời chất vấn về bài của mình, dịch vụ kiểm tra liêm chính học thuật rà bản thảo cùng dấu vết quá trình của bạn theo đúng chuẩn mà trường bạn áp dụng, còn hỗ trợ học thuật ghép bạn với một cố vấn làm việc trên chính bài viết của bạn, để chữ trên trang giấy chứng minh được là của bạn.
Tài liệu tham khảo
Elkhatat, A. M., Elsaid, K., & Almeer, S. (2023). Evaluating the efficacy of AI content detection tools in differentiating between human and AI-generated text. International Journal for Educational Integrity, 19, 17. https://doi.org/10.1007/s40979-023-00140-5
Giray, L. (2024). The problem with false positives: AI detection unfairly accuses scholars of AI plagiarism. The Serials Librarian, 85(5-6), 181–189. https://doi.org/10.1080/0361526X.2024.2433256
Goodier, M. (2025, June 15). Revealed: Thousands of UK university students caught cheating using AI. The Guardian. https://www.theguardian.com/education/2025/jun/15/thousands-of-uk-university-students-caught-cheating-using-ai-artificial-intelligence-survey
Gosling, S. D., Ybarra, K., & Angulo, S. K. (2024). A widely used generative-AI detector yields zero false positives. Aloma, 42(2), 31–43. https://doi.org/10.51698/aloma.2024.42.2.31-43
Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). GPT detectors are biased against non-native English writers. Patterns, 4(7), 100779. https://doi.org/10.1016/j.patter.2023.100779
Stephenson, R., & Armstrong, C. (2026). Student generative artificial intelligence survey 2026 (HEPI Report 199). Higher Education Policy Institute. https://www.hepi.ac.uk/reports/student-generative-ai-survey-2026/
Turnitin. (2023, June 14). Understanding AI writing detection: False positive rates. https://www.turnitin.com/blog/understanding-the-false-positive-rate-for-sentences-of-our-ai-writing-detection-capability
Turnitin. (2024, July 18). AI writing detection model. Turnitin Guides. https://guides.turnitin.com/hc/en-us/articles/28294949544717-AI-writing-detection-model
Vanderbilt University. (2023). Guidance on AI detection and why we're disabling Turnitin's AI detector. Brightspace. https://www.vanderbilt.edu/brightspace/2023/08/16/guidance-on-ai-detection-and-why-were-disabling-turnitins-ai-detector/
Weber-Wulff, D., Anohina-Naumeca, A., Bjelobaba, S., Foltynek, T., Guerrero-Dib, J., Popoola, O., Sigut, P., & Waddington, L. (2023). Testing of detection tools for AI-generated text. International Journal for Educational Integrity, 19, 26. https://doi.org/10.1007/s40979-023-00146-z