
◆ Liêm chính học thuật
Similarity score và AI score khác nhau thế nào?
Trả lời thẳng: Similarity score đo mức trùng lặp giữa bài bạn nộp và một cơ sở dữ liệu đối chiếu, nên nó là chỉ số so khớp chứ chưa phải kết luận đạo văn. AI score ước lượng mức độ dễ đoán về mặt thống kê của câu chữ, tức xác suất văn bản giống văn do máy tạo, và cũng chưa phải bằng chứng bạn đã dùng AI (Foltýnek et al. 2020; Liang et al. 2023).
Hai con số trả lời hai câu hỏi khác nhau, và riêng từng con số đều chưa đủ để kết luận vi phạm liêm chính học thuật. Bài này giúp bạn đọc đúng từng con số và biết cần chuẩn bị bằng chứng gì nếu bài bị gắn cờ ở một trong hai chỉ số.
◆ Câu hỏi 1 / 6 · Similarity đo gì
Similarity score thực sự đo điều gì?
Trả lời thẳng: Similarity score là tỷ lệ phần trăm văn bản bạn nộp mà công cụ so khớp tìm thấy trùng hoặc gần trùng với văn bản có sẵn trong cơ sở dữ liệu đối chiếu, gồm bài của sinh viên khác, tạp chí khoa học, website và sách. Đây là phép tính trùng lặp từ vựng, chưa đánh giá tính nguyên bản hay ý định của người viết, đúng như Foltýnek et al. (2020) mô tả.
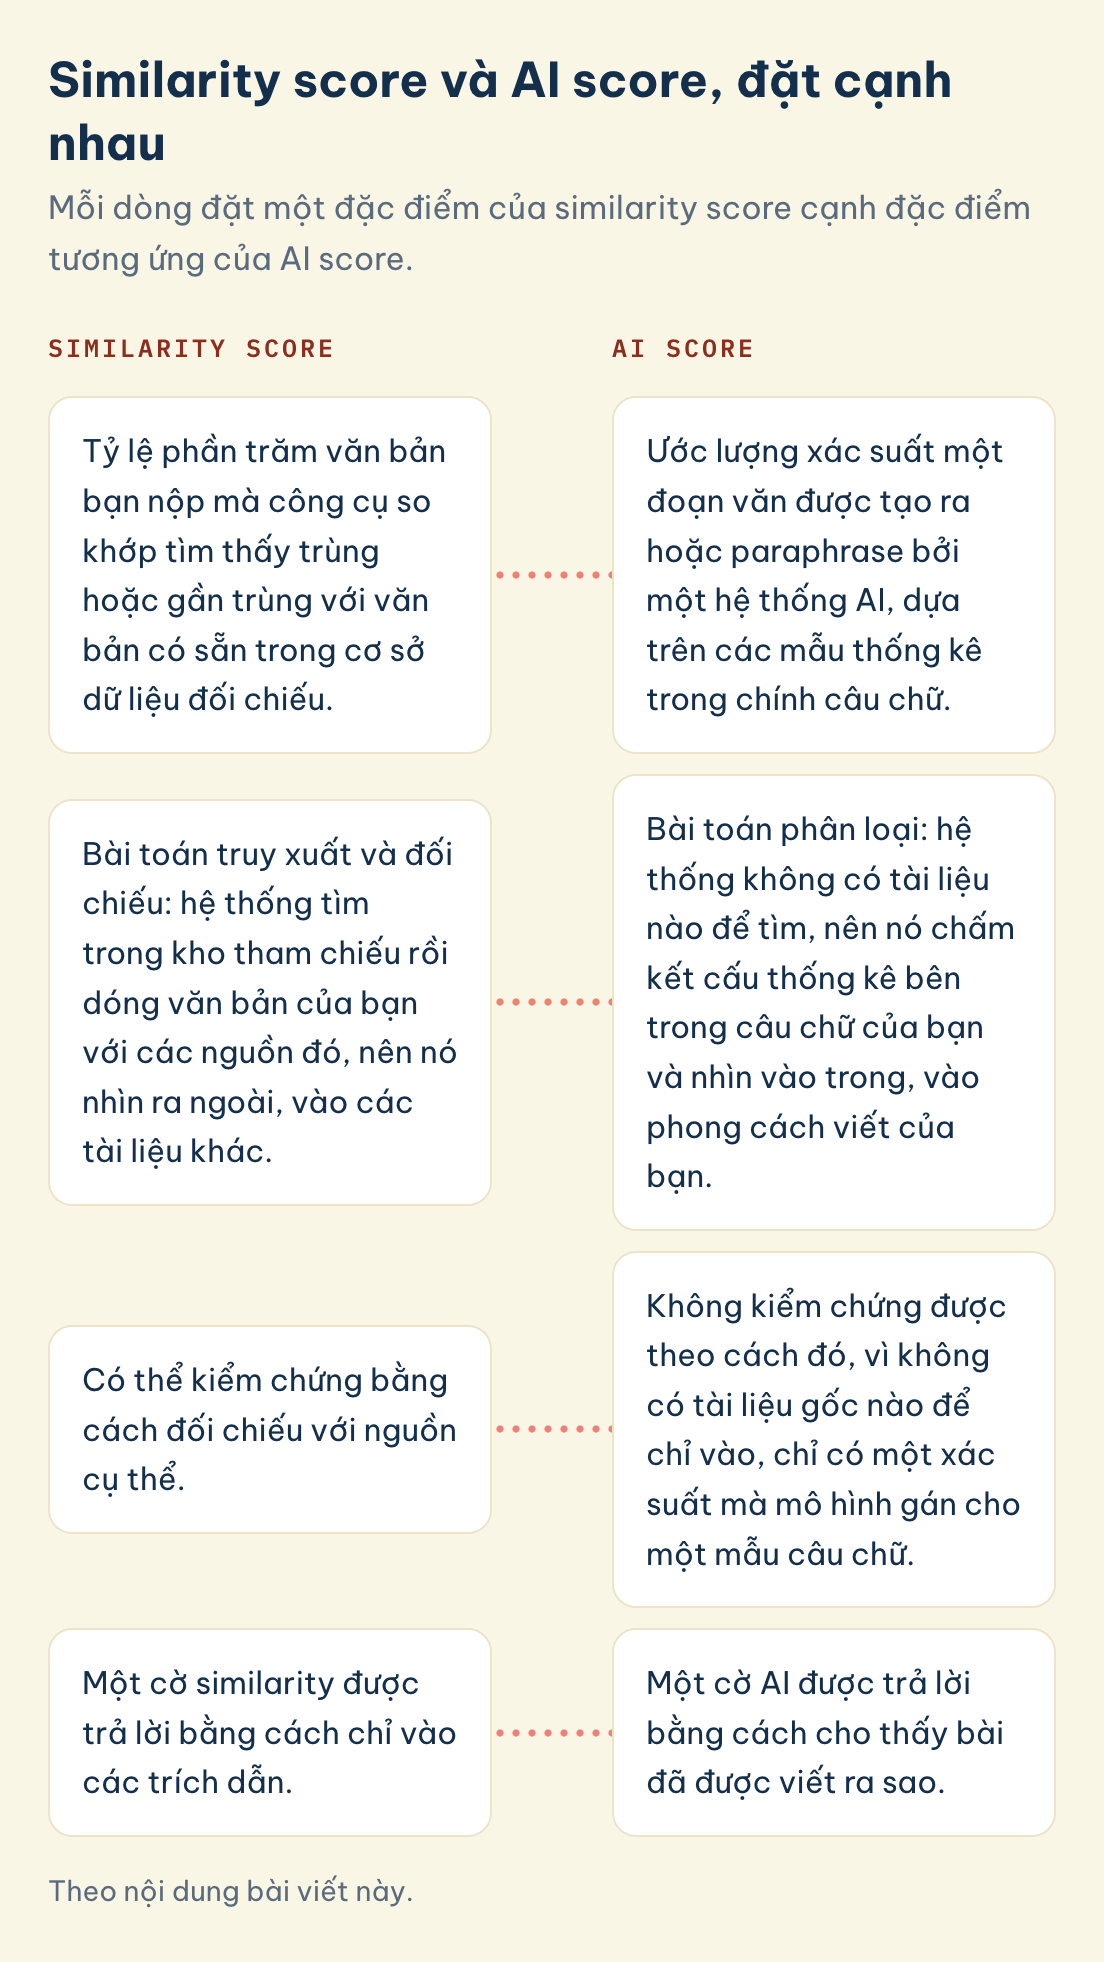
Similarity score và AI score, đặt cạnh nhau
Mỗi dòng đặt một đặc điểm của similarity score cạnh đặc điểm tương ứng của AI score.
Similarity score
AI score
Tỷ lệ phần trăm văn bản bạn nộp mà công cụ so khớp tìm thấy trùng hoặc gần trùng với văn bản có sẵn trong cơ sở dữ liệu đối chiếu.
Ước lượng xác suất một đoạn văn được tạo ra hoặc paraphrase bởi một hệ thống AI, dựa trên các mẫu thống kê trong chính câu chữ.
Bài toán truy xuất và đối chiếu: hệ thống tìm trong kho tham chiếu rồi dóng văn bản của bạn với các nguồn đó, nên nó nhìn ra ngoài, vào các tài liệu khác.
Bài toán phân loại: hệ thống không có tài liệu nào để tìm, nên nó chấm kết cấu thống kê bên trong câu chữ của bạn và nhìn vào trong, vào phong cách viết của bạn.
Có thể kiểm chứng bằng cách đối chiếu với nguồn cụ thể.
Không kiểm chứng được theo cách đó, vì không có tài liệu gốc nào để chỉ vào, chỉ có một xác suất mà mô hình gán cho một mẫu câu chữ.
Một cờ similarity được trả lời bằng cách chỉ vào các trích dẫn.
Một cờ AI được trả lời bằng cách cho thấy bài đã được viết ra sao.
Lưu hình này
Foltýnek et al. (2020) so sánh mười lăm hệ thống so khớp văn bản trực tuyến trong một nghiên cứu quy mô lớn, chi tiết về phương pháp, và kết luận rằng phần mềm loại này không thể xác định đạo văn có xảy ra hay không. Nó chỉ đánh dấu được những đoạn tương đồng có thể cấu thành đạo văn, và mọi match đều cần con người thẩm định thì mới diễn giải được. Hướng dẫn liêm chính học thuật của University of Melbourne cũng xem một kết quả similarity cao là tín hiệu để rà soát thêm chứ chưa phải bằng chứng tự thân, vì trích dẫn trực tiếp nhiều nhưng đúng quy cách vẫn có thể đẩy tỷ lệ phần trăm lên ngang với sao chép không ghi nguồn (University of Melbourne, n.d.-a).
Con số được tính hoàn toàn bằng máy, nên một tỷ lệ cao vẫn có thể vô hại. Danh mục tài liệu tham khảo dài, các câu trích nguyên văn hay cụm thuật ngữ chuẩn của ngành đều bị đếm là "match" ngay cả khi đã được trích dẫn đầy đủ và chính xác, đúng giới hạn mà Foltýnek et al. (2020) ghi nhận ở phần mềm so khớp văn bản. Bài đồng hành về ý nghĩa thực của similarity score hướng dẫn cách đọc báo cáo theo từng match một.
◆ Câu hỏi 2 / 6 · AI score đo gì
AI score thực sự đo điều gì?
Trả lời thẳng: Chỉ báo AI-writing ước lượng xác suất một đoạn văn được tạo ra hoặc paraphrase bởi một hệ thống AI như GPT hay Claude. Nó dựa trên các mẫu thống kê trong chính câu chữ, chủ yếu là mức độ dễ đoán của từng lựa chọn từ (perplexity) và mức độ biến thiên về độ dài và cấu trúc câu (burstiness), chứ không so bài của bạn với bất kỳ nguồn bên ngoài nào.
Cách tiếp cận này đánh giá "dấu vân tay" thống kê bên trong chính bài viết, đúng như Weber-Wulff et al. (2023) mô tả khi kiểm định các công cụ phát hiện AI. Hướng dẫn của University of Melbourne mô tả chỉ báo AI là tỷ lệ phần bài nộp mà công cụ tính ra "khả năng từ 98% trở lên" đã được AI tạo hoặc paraphrase, tức một ước lượng xác suất tính từ bên trong chứ chưa phải một dữ kiện đối chiếu được với nguồn (University of Melbourne, n.d.-b). Vì ước lượng này dựa trên một mô hình thống kê thay vì tra cứu cơ sở dữ liệu, độ chính xác của nó khác về bản chất so với một phép tính so khớp, và theo bằng chứng hiện có thì kém ổn định hơn (Weber-Wulff et al. 2023).
Một similarity score có thể kiểm chứng bằng cách đối chiếu với nguồn cụ thể. AI score thì không kiểm chứng được theo cách đó, vì không có tài liệu gốc nào để chỉ vào, chỉ có một xác suất mà mô hình gán cho một mẫu câu chữ, và Weber-Wulff et al. (2023) ghi nhận các công cụ phát hiện AI họ kiểm định đều chưa chính xác và chưa đáng tin cậy. Chính khác biệt này khiến bạn không thể đọc hai con số bằng cùng một thước đo.
◆ Câu hỏi 3 / 6 · Hai cách tính
Vì sao hai chỉ số được tính theo hai cách khác nhau?
Trả lời thẳng: Kiểm tra similarity là bài toán truy xuất và đối chiếu: hệ thống tìm trong kho tham chiếu các nguồn ứng viên rồi dóng văn bản của bạn với chúng để đo mức trùng lặp. Phát hiện AI là bài toán phân loại: hệ thống không có tài liệu nào để tìm, nên nó chấm kết cấu thống kê bên trong câu chữ của bạn theo các mẫu học từ văn bản người viết và máy viết.
Một phương pháp nhìn ra ngoài, vào các tài liệu khác, còn phương pháp kia nhìn vào trong, vào phong cách viết của bạn.
Các tổng quan hệ thống về nghiên cứu phát hiện đạo văn mô tả so khớp văn bản là quy trình hai bước, truy xuất nguồn ứng viên rồi dóng hàng chi tiết với một kho tham chiếu lớn (Foltýnek et al. 2020). Ngược lại, các AI detector dựa trên những tín hiệu rút từ Large Language Model (LLM) như perplexity và burstiness thay vì bất kỳ phép đối chiếu kho dữ liệu nào. Kiểm định độc lập cho thấy độ chính xác của chúng giảm mạnh chỉ sau vài chỉnh sửa nhẹ lên văn bản, một điểm yếu không có tương đương ở phía so khớp, vì so khớp không phụ thuộc vào việc mô hình hoá "AI viết như thế nào" (Weber-Wulff et al. 2023).
Hai cơ chế không giao nhau, nên một tài liệu có thể điểm cao ở chỉ số này và thấp ở chỉ số kia vì những lý do không liên quan gì tới nhau. Một bài literature review trích dẫn dày đặc, ghi nguồn tỉ mỉ có thể mang similarity score cao và AI score thấp. Ngược lại, một đoạn văn ngắn, mộc mạc, cấu trúc đều đặn do chính sinh viên viết từ đầu có thể có similarity score gần 0% mà vẫn kích hoạt cờ AI.
◆ Câu hỏi 4 / 6 · Điểm cao không chứng minh gì
Điểm cao ở một trong hai chỉ số không chứng minh điều gì?
Trả lời thẳng: Cả hai chỉ số đều chưa phải bằng chứng vi phạm. Một kết quả similarity cao thường phản ánh phần trích dẫn đúng quy cách thay vì hành vi sao chép. Một kết quả AI-writing cao thường phản ánh văn người thật viết nhưng tình cờ quá đều đặn, một đặc điểm phổ biến ở văn học thuật cẩn thận hoặc văn của người viết bằng ngôn ngữ thứ hai, chứ không dành riêng cho văn máy.
Hướng dẫn liêm chính học thuật nói rõ rằng một kết quả similarity cao "tự nó không nên bị xem là bằng chứng một vi phạm đánh giá đã xảy ra", vì trích dẫn nhiều nhưng đúng quy cách tạo ra cùng một con số tổng như sao chép không ghi nguồn (University of Melbourne, n.d.-a). Ở phía AI, cùng bộ hướng dẫn đó yêu cầu giảng viên cân nhắc liệu văn phong của sinh viên có thiên về "đều đặn, theo lối mòn hay công thức" hay không, vì đặc điểm ấy làm tăng khả năng false positive thay vì chỉ ra việc dùng AI (University of Melbourne, n.d.-b). Một nghiên cứu bình duyệt trên nhiều AI detector phổ biến phát hiện chúng phân loại nhầm các bài luận thật của người viết tiếng Anh không phải bản ngữ thành văn AI với tỷ lệ cao hơn hẳn so với bài của người bản ngữ (Liang et al. 2023). Lý do khả dĩ là lối viết mộc, đồng đều mà nhiều người viết ngôn ngữ thứ hai được dạy lại chính là thứ kéo thấp tín hiệu perplexity mà các detector này đọc như dấu hiệu của văn máy.
Với sinh viên English as a Second Language (ESL) và du học sinh Việt nói riêng, những thói quen giúp văn ngôn ngữ thứ hai rõ ràng và an toàn về ngữ pháp, gồm câu ngắn hơn, từ vựng giản dị hơn và cấu trúc nhất quán, cũng chính là những thói quen về mặt thống kê giống đầu ra của AI. Đó là hạn chế đã được ghi nhận của phương pháp phát hiện, chứ không phản ánh bài luận thực sự được viết ra như thế nào. Bài đồng hành về vì sao bài tự viết vẫn bị flag là AI giải thích cơ chế này sâu hơn.
◆ Câu hỏi 5 / 6 · Các trường xử lý ra sao
Các trường được khuyến nghị xử lý từng chỉ số như thế nào?
Trả lời thẳng: Như điểm khởi đầu cho phán đoán của con người, chứ không bao giờ là phán quyết tự động, đúng kết luận song song mà Foltýnek et al. (2020) và Weber-Wulff et al. (2023) đưa ra ở hai loại công cụ. Cả hai kết quả đều gợi mở một lượt xem xét kỹ hơn bởi con người, và quy trình liêm chính nhìn chung đòi bằng chứng bổ trợ trước khi kết luận vi phạm.
Hướng dẫn dành cho giảng viên của University of Melbourne viết thẳng: "A high AI detection score alone does not constitute grounds for making an allegation of academic misconduct" (University of Melbourne, n.d.-b). Hướng dẫn đó còn liệt kê các bằng chứng bổ sung cần tìm trước khi tiến hành, như sự bất nhất so với bài trước đây của sinh viên hay metadata bất thường của file. Nguyên tắc tương tự áp dụng cho kết quả similarity, mà theo hướng dẫn phải được "cân với các bằng chứng khác" thay vì bị coi là kết luận tự thân (University of Melbourne, n.d.-a). Kiểm định độc lập trên các công cụ phát hiện đi đến kết luận song song từ phía nghiên cứu: công cụ tự động có thể hỗ trợ một cuộc điều tra, nhưng tự chúng không thể xác định vi phạm có xảy ra hay không (Foltýnek et al. 2020; Weber-Wulff et al. 2023).
Nếu quy trình của trường bạn vận hành đúng thiết kế, một con số trên báo cáo sẽ mở ra một cuộc trao đổi chứ không dẫn thẳng tới hình phạt, đúng tinh thần hướng dẫn của University of Melbourne (n.d.-a, n.d.-b) về cả hai chỉ số. Biết trước điều đó giúp quá trình bớt giống một lời buộc tội và trở về đúng bản chất của nó, tức một bước kiểm tra.
◆ Câu hỏi 6 / 6 · Khi bị flag
Bạn nên làm gì nếu bị flag ở một trong hai chỉ số?
Trả lời thẳng: Hãy phản hồi bình tĩnh, hỏi chính xác điều gì đã được báo cáo, và chuẩn bị trình bày quá trình làm bài thay vì tranh cãi với con số. Với cờ similarity, bạn tự rà từng match và phân loại đâu là trích dẫn, tài liệu tham khảo hay cụm từ chuẩn của ngành, đâu là trùng lặp thật sự chưa ghi nguồn.
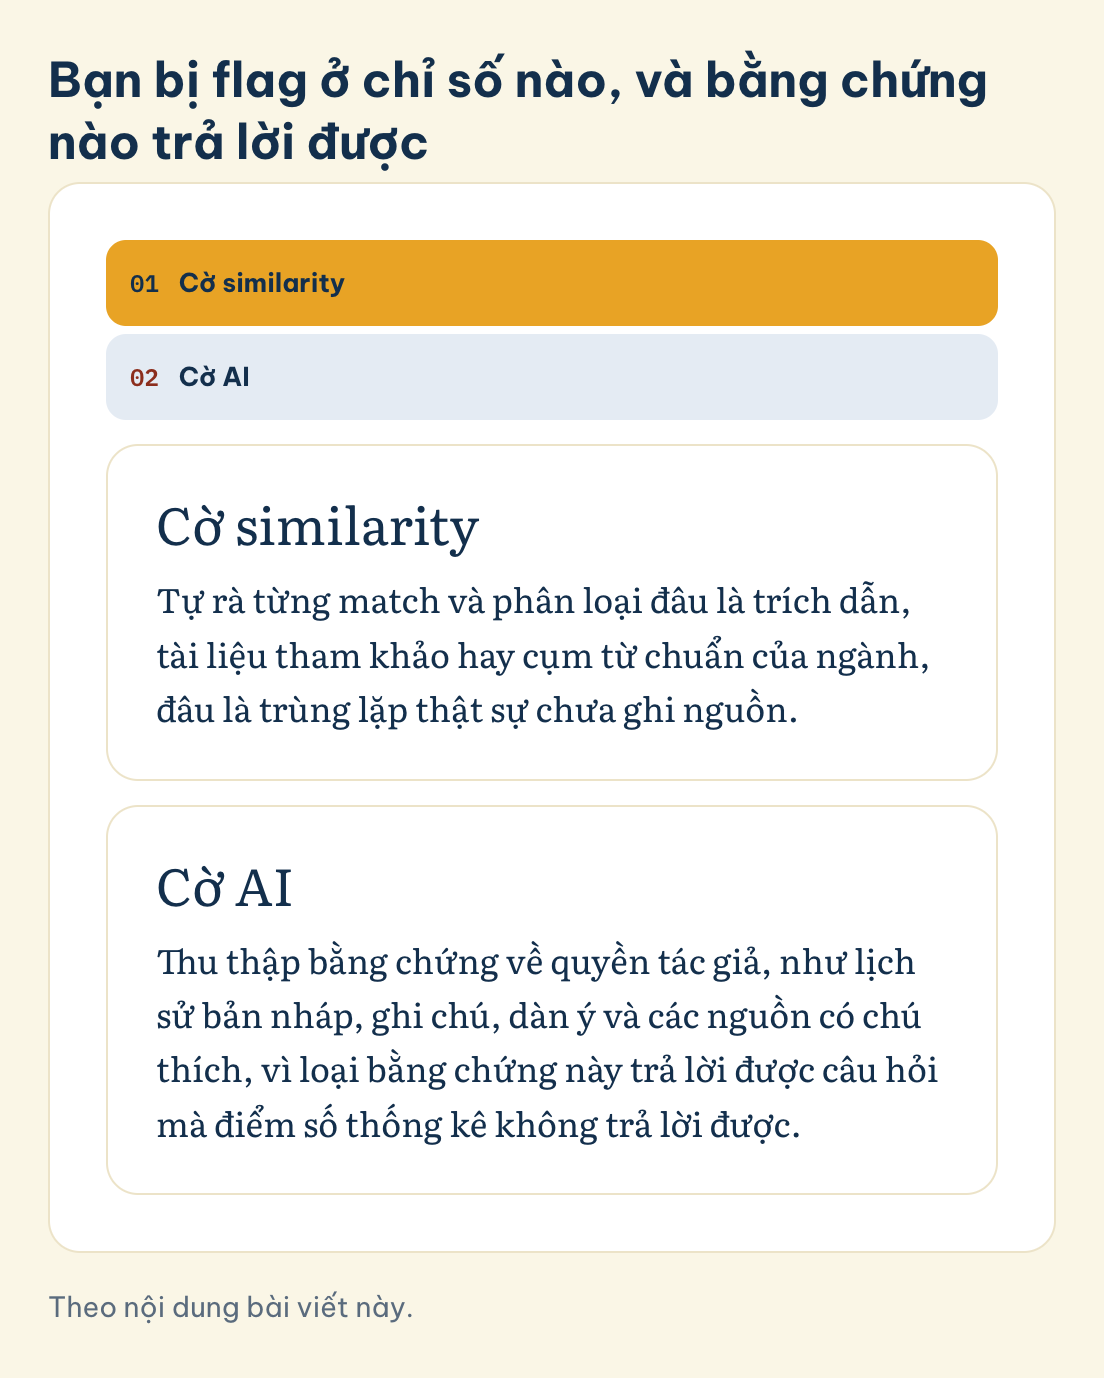
Bạn bị flag ở chỉ số nào, và bằng chứng nào trả lời được
Chạm vào một loại cờ để xem nên làm gì.
Cờ similarity
Tự rà từng match và phân loại đâu là trích dẫn, tài liệu tham khảo hay cụm từ chuẩn của ngành, đâu là trùng lặp thật sự chưa ghi nguồn.
Cờ AI
Thu thập bằng chứng về quyền tác giả, như lịch sử bản nháp, ghi chú, dàn ý và các nguồn có chú thích, vì loại bằng chứng này trả lời được câu hỏi mà điểm số thống kê không trả lời được.
Lưu hình này
Với cờ AI, bạn thu thập bằng chứng về quyền tác giả, như lịch sử bản nháp, ghi chú, dàn ý và các nguồn có chú thích, vì loại bằng chứng này trả lời được câu hỏi mà điểm số thống kê không trả lời được, nhất là khi độ chính xác của chỉ báo được Weber-Wulff et al. (2023) ghi nhận là còn dao động.
Hướng dẫn cho cả hai loại cờ đều coi chúng là lời mời xem xét thay vì kết luận, và cho phép sinh viên giải thích quá trình làm bài, cung cấp bản nháp hoặc trao đổi về cách bài được thực hiện trước khi có bất kỳ cáo buộc nào (University of Melbourne, n.d.-a, n.d.-b). Vì độ chính xác của AI detection được ghi nhận là thiếu nhất quán, đặc biệt với người viết tiếng Anh không phải bản ngữ, một vệt bản nháp được lưu lại đầy đủ là cách trả lời mạnh nhất và trực tiếp nhất cho một cờ mà điểm số thống kê tự nó không giải quyết được (Liang et al. 2023; Weber-Wulff et al. 2023).
Biết mình bị flag ở chỉ số nào sẽ quyết định loại bằng chứng thực sự liên quan. Cờ similarity được trả lời bằng cách chỉ vào các trích dẫn, còn cờ AI được trả lời bằng cách cho thấy bài đã được viết ra sao. Cách thứ hai càng cần thiết hơn với người viết không phải bản ngữ tiếng Anh, nhóm mà Liang et al. (2023) ghi nhận bị AI detector gắn nhãn sai nhiều hơn. Nhầm lẫn hai loại này làm mất thời gian lẽ ra dành cho việc trả lời đúng câu hỏi đang được đặt ra.
MAAS giúp được gì khi bạn nhận một báo cáo khó đọc?
Trả lời thẳng: MAAS giúp bạn đọc đúng một báo cáo similarity hay AI-writing, chứ không chỉ cho bạn đường tắt. Người đọc báo cáo của MAAS xem từng đoạn bị đánh dấu là trích dẫn đúng quy cách hay một chỗ thật sự thiếu nguồn, đặt báo cáo AI cạnh giọng viết của chính bạn, rồi chỉ ra chỗ cần chỉnh và chỗ vốn đã ổn. Bài vẫn do bạn tự sửa.
Nếu một báo cáo khiến bạn chưa chắc nó thực sự nói gì về bài của mình, dịch vụ kiểm tra liêm chính học thuật của MAAS là nơi bạn có thể nhờ đọc cùng. MAAS không viết thay bạn, không sửa thay bạn và không nộp bài thay bạn.
Câu hỏi thường gặp
Một bài có thể vừa có similarity score cao vừa có AI score thấp không?
Có, và điều này phổ biến trong các bài Literature Review. Một bài trích dẫn dày đặc, ghi nguồn cẩn thận có thể hiện tỷ lệ similarity cao từ các câu trích và tài liệu tham khảo được so khớp, trong khi điểm khả năng AI-writing vẫn thấp, vì hai chỉ số đo hai thứ không liên quan (Foltýnek et al. 2020).
Một bài có thể có similarity score thấp nhưng AI score cao không?
Có. Văn bản có thể hoàn toàn nguyên bản theo nghĩa không trùng với bất kỳ nguồn nào sẵn có, nhưng vẫn đủ đồng đều về mặt thống kê để kích hoạt chỉ báo AI-writing, vì chỉ báo này hoàn toàn không kiểm tra nguồn trùng khớp (University of Melbourne, n.d.-b).
Chỉ số nào đáng tin cậy hơn?
Chúng thiếu tin cậy theo những cách khác nhau. So khớp similarity có thể bỏ sót đạo văn đã paraphrase và cũng có thể đánh dấu tài liệu trích dẫn đúng quy cách là "match". AI detection có thể phân loại nhầm văn người thật viết, và độ chính xác được ghi nhận là còn giảm thêm khi văn bản chỉ được chỉnh sửa nhẹ (Weber-Wulff et al. 2023). Cả hai đều không được thiết kế để đọc như một phán quyết độc lập.
Vì sao người viết tiếng Anh không phải bản ngữ hay bị flag ở AI score hơn?
Vì những thói quen viết thường được dạy cho người viết ngôn ngữ thứ hai, như câu ngắn hơn, từ vựng giản dị hơn và cấu trúc nhất quán, về mặt thống kê giống với mẫu ít biến thiên mà các AI detector gắn với văn máy. Một nghiên cứu bình duyệt tìm thấy tỷ lệ false positive cao hơn đáng kể ở người viết tiếng Anh không phải bản ngữ so với người bản ngữ (Liang et al. 2023).
Trích dẫn có xử lý được cờ AI-writing như cách nó xử lý một similarity match không?
Không. Trích dẫn giải quyết được một similarity match vì similarity xoay quanh việc truy xuất và dóng hàng với một nguồn cụ thể trong kho tham chiếu (Foltýnek et al. 2020). Cờ AI-writing không liên quan đến trích dẫn thiếu, nó là ước lượng thống kê về cách văn bản được tạo ra, nên câu trả lời phù hợp là bằng chứng về quá trình soạn thảo của chính bạn, chứ không nằm ở danh mục tài liệu tham khảo.
Có nên đổi văn phong để tránh bị flag AI không?
Đừng bóp méo bài làm để "qua mặt" một detector. Hãy tập trung vào quyền tác giả thực sự và giữ lại bằng chứng tự nhiên về quá trình làm bài, như các bản nháp và ghi chú. Các trường xem cả hai chỉ số như lời gợi mở cho một cuộc trao đổi giữa người với người, chứ không xem đó là mục tiêu để tối ưu ngược, đúng cách University of Melbourne (n.d.-b) khuyến nghị giảng viên tiếp cận một điểm AI detection cao.
MAAS có thể diễn giải báo cáo similarity và AI-writing giúp tôi không?
Có. Người đọc báo cáo của MAAS có thể cùng bạn đi qua cả hai báo cáo, giải thích mỗi con số đang đo và không đo điều gì, và chỉ ra phần nào trong bài thực sự cần xử lý, còn việc sửa bài vẫn do bạn tự làm.
References
- Foltýnek, T., Dlabolová, D., Anohina-Naumeca, A., Razı, S., Kravjar, J., Kamzola, L., Guerrero-Dib, J., Çelik, Ö., & Weber-Wulff, D. (2020). Testing of support tools for plagiarism detection. International Journal of Educational Technology in Higher Education, 17, Article 46. https://doi.org/10.1186/s41239-020-00192-4
- Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). GPT detectors are biased against non-native English writers. Patterns, 4(7), Article 100779. https://doi.org/10.1016/j.patter.2023.100779
- University of Melbourne. (n.d.-a). Advice for students regarding Turnitin and AI writing detection. Academic Integrity. Retrieved July 4, 2026, from https://academicintegrity.unimelb.edu.au/plagiarism-and-collusion/advice-for-students-regarding-turnitin-and-ai-writing-detection
- University of Melbourne. (n.d.-b). Turnitin's AI writing detection tool. Academic Integrity. Retrieved July 4, 2026, from https://academicintegrity.unimelb.edu.au/staff-resources/turnitins-ai-writing-detection-tool
- Weber-Wulff, D., Anohina-Naumeca, A., Bjelobaba, S., Foltýnek, T., Guerrero-Dib, J., Popoola, O., Šigut, P., & Waddington, L. (2023). Testing of detection tools for AI-generated text. International Journal for Educational Integrity, 19, Article 26. https://doi.org/10.1007/s40979-023-00146-z
Bài viết này là hướng dẫn về liêm chính học thuật, không thay thế bài làm của chính bạn hay chính sách của trường bạn. MAAS đồng hành để sinh viên tạo ra sản phẩm thực sự của mình theo mô hình Outline → Draft → Final, MAAS không viết, không nộp và không che giấu bài làm thay cho sinh viên.
Một buổi tư vấn miễn phí 20 phút với mentor của MAAS, để cùng xem một báo cáo similarity hay AI-writing có ý nghĩa gì với bài của bạn.
Đặt buổi tư vấn miễn phí ▸