
Độ lệch chuẩn là con số cho biết các giá trị trong một bộ dữ liệu nằm sát hay nằm xa giá trị trung bình, nên hai lớp cùng điểm trung bình 7 vẫn có thể rất khác nhau: một lớp ai cũng quanh mức 7, lớp kia có người 3 điểm, có người 10 điểm. Bài viết này giúp bạn hiểu độ lệch chuẩn đo cái gì, tính nó theo công thức nào, đọc con số lớn hay nhỏ ra sao, và phân biệt nó với sai số chuẩn để diễn giải đúng trong chương kết quả của luận văn.
Tác giả: Ban Biên tập MAAS
Cập nhật lần cuối: 2026-09-18
Chuyên mục: research-methods
Độ lệch chuẩn là gì?
Trả lời thẳng: Độ lệch chuẩn (standard deviation) là số đo mức độ các giá trị trong một tập dữ liệu phân tán quanh giá trị trung bình, và luôn là một số không âm. Độ lệch chuẩn nhỏ nghĩa là các quan sát nằm sát trung bình, còn độ lệch chuẩn lớn nghĩa là các quan sát trải rộng, có cả giá trị rất cao lẫn giá trị rất thấp.
Illowsky và Dean (2025), trong giáo trình mở Introduction to Statistics của eCampusOntario, định nghĩa độ lệch chuẩn ở mục "Measures of Variability" là thước đo mức độ phân tán của dữ liệu quanh trung bình. Theo hai tác giả, độ lệch của mỗi giá trị được tính bằng cách lấy giá trị đó trừ đi trung bình, và độ lệch chuẩn gom tất cả các độ lệch ấy lại thành một con số đại diện.
Lấy lại ví dụ hai lớp ở đầu bài. Nếu lớp A có độ lệch chuẩn 0,5 còn lớp B có độ lệch chuẩn 2,0, dù cả hai cùng điểm trung bình 7, thì phần lớn học sinh lớp A đều đạt quanh mức 7, còn lớp B có cả người điểm rất thấp lẫn người điểm gần tuyệt đối. Điểm trung bình giống nhau che mất sự khác biệt này, và độ lệch chuẩn là con số làm nó lộ ra.
Công thức tính độ lệch chuẩn thế nào, và vì sao mẫu chia cho n−1 còn tổng thể chia cho N?
Trả lời thẳng: Độ lệch chuẩn là căn bậc hai của phương sai, còn phương sai là trung bình của bình phương các độ lệch so với trung bình. Với mẫu, s bằng căn bậc hai của tổng bình phương độ lệch chia cho (n−1). Với tổng thể, σ bằng căn bậc hai của tổng đó chia cho N, không trừ 1. Ký hiệu s dùng cho mẫu, σ dùng cho tổng thể.
El Omda và Sergent (2024), trong tài liệu do StatPearls Publishing đăng trên NCBI Bookshelf, minh hoạ năm bước tính độ lệch chuẩn mẫu trên một bộ dữ liệu cụ thể. Ở ví dụ đó, tổng bình phương độ lệch bằng 36,9 và cỡ mẫu bằng 10, nên phương sai mẫu là 36,9 chia cho 9, bằng 4,1, và độ lệch chuẩn mẫu là 2,02 sau khi làm tròn. Cũng bộ dữ liệu ấy, nếu tính theo công thức tổng thể, tức chia cho N thay vì N trừ 1, độ lệch chuẩn tổng thể là 1,92. El Omda và Sergent (2024) ghi rõ khác biệt duy nhất giữa hai công thức nằm ở bước chia cuối cùng.
Lý do mẫu chia cho n−1 dễ hiểu hơn khi đặt vào một tình huống khảo sát. Giả sử một sinh viên chỉ khảo sát một mẫu 10 sinh viên trong một khoa 500 người. Chia cho n−1 thay vì n giúp con số tính ra không bị lệch thấp một cách hệ thống khi dùng để ước lượng độ phân tán thật của cả 500 sinh viên. Ngược lại, nếu đề bài đưa ra dữ liệu của toàn bộ tổng thể chứ không phải một mẫu rút từ tổng thể lớn hơn, công thức chia cho N mới là công thức phù hợp.
Độ lệch chuẩn nhỏ hay lớn thì nói lên điều gì?
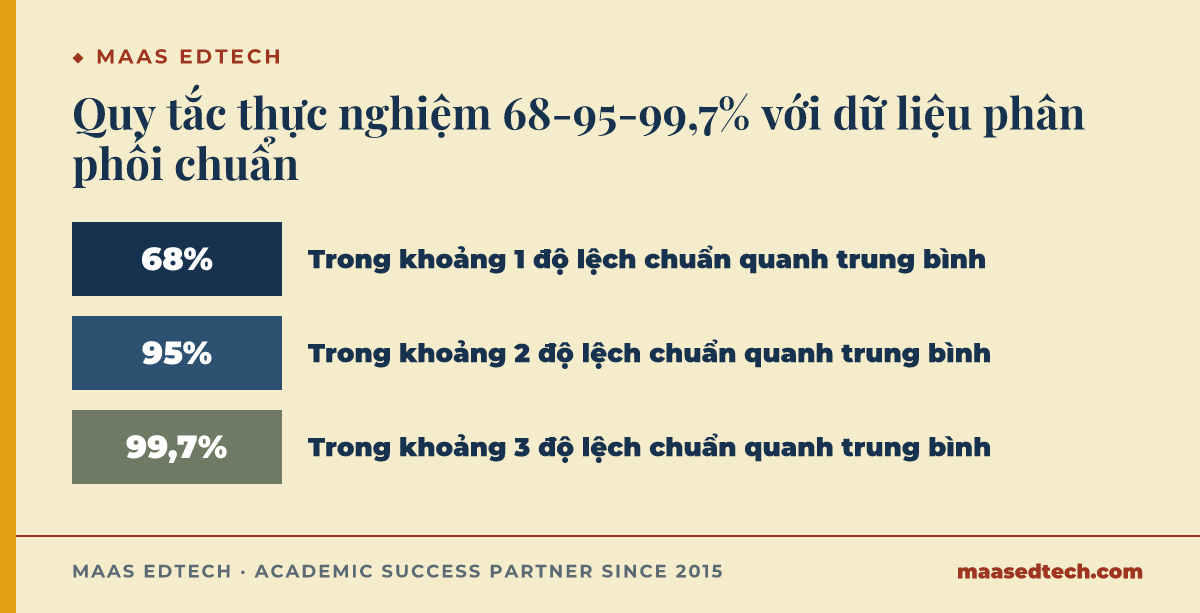
Trả lời thẳng: Với dữ liệu có phân phối chuẩn hình chuông, khoảng một độ lệch chuẩn quanh trung bình chứa khoảng 68% số quan sát, hai độ lệch chuẩn chứa khoảng 95%, và ba độ lệch chuẩn chứa khoảng 99,7%. Đây gọi là quy tắc thực nghiệm (empirical rule), và quy tắc này chỉ áp dụng đáng tin khi dữ liệu thật sự gần với phân phối chuẩn.
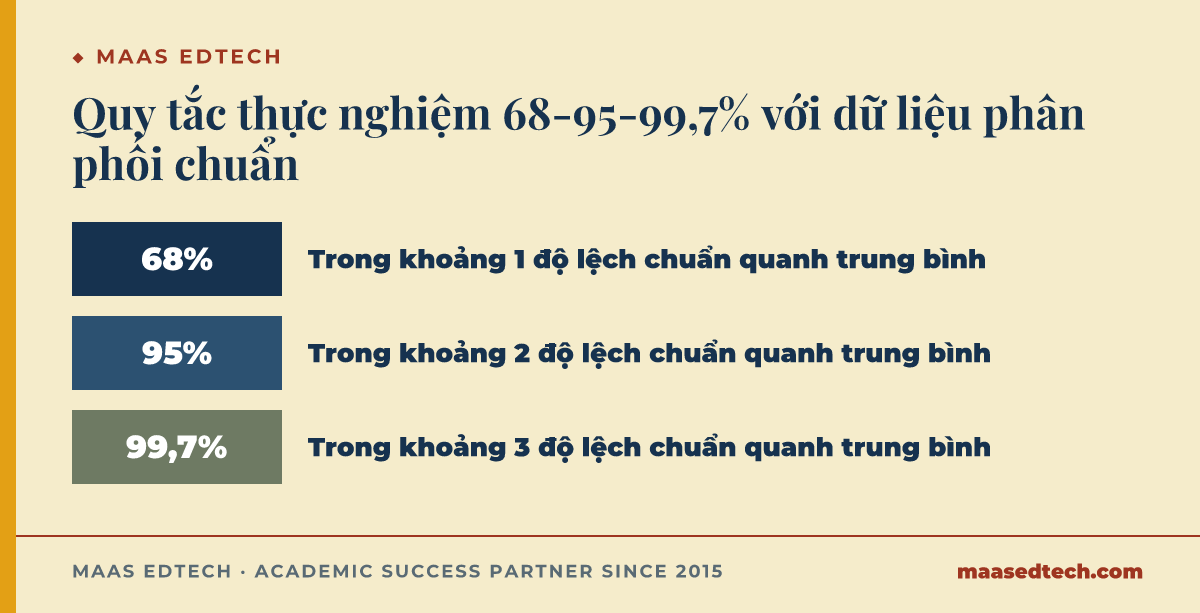
El Omda và Sergent (2024) nêu quy tắc ba mốc 68%, 95% và 99,7% khi bàn về cách dùng độ lệch chuẩn để có cái nhìn tổng quan nhanh về một tổng thể. Illowsky và Dean (2025) bổ sung một giới hạn quan trọng: trong phân phối lệch (skewed), độ lệch chuẩn có thể kém hữu ích hơn, vì hai phía của phân phối có độ phân tán khác nhau. Khi đó, hai tác giả gợi ý xem tứ phân vị, gồm phân vị thứ nhất, trung vị và phân vị thứ ba, cùng giá trị nhỏ nhất và giá trị lớn nhất.
Nếu điểm một môn học phân phối khá đối xứng quanh trung bình, một sinh viên đạt điểm cao hơn trung bình đúng hai độ lệch chuẩn thường thuộc nhóm khoảng 2,5% cao nhất lớp, tính theo phần đuôi trên của phân phối chuẩn. Nhưng nếu phân phối điểm lệch hẳn về một phía, chẳng hạn phần lớn sinh viên đạt điểm cao còn một số ít bị điểm rất thấp, quy tắc 68-95-99,7% không còn đúng chính xác. Trong trường hợp đó, trung vị và tứ phân vị mô tả dữ liệu sát thực tế hơn.
Độ lệch chuẩn khác gì sai số chuẩn của trung bình (SE hay SEM)?
Trả lời thẳng: Độ lệch chuẩn mô tả mức độ phân tán của chính các giá trị dữ liệu bạn đang có. Sai số chuẩn của trung bình đo mức độ chính xác khi dùng trung bình của mẫu để ước lượng trung bình của cả tổng thể. Hai chỉ số trả lời hai câu hỏi khác nhau, và nhầm lẫn giữa chúng là lỗi phổ biến, kể cả trong nhiều nghiên cứu đã xuất bản.
Andrade (2020, p. 409) viết nguyên văn "the SEM is always smaller than the SD" trong bài đăng trên Indian Journal of Psychological Medicine. Tác giả giải thích đây là một trong những lý do khiến một số người viết nhầm, hoặc cố ý báo cáo sai số chuẩn thay cho độ lệch chuẩn, vì con số nhỏ hơn trông như dữ liệu chính xác hơn thực tế, và Andrade gọi thẳng cách làm đó là gây hiểu lầm. Lee và cộng sự (2015) nêu công thức liên hệ giữa hai chỉ số: sai số chuẩn của trung bình bằng độ lệch chuẩn chia cho căn bậc hai của cỡ mẫu. Nhóm tác giả cũng phân vai rõ, độ lệch chuẩn phục vụ mục đích mô tả, còn sai số chuẩn phục vụ suy luận thống kê, chẳng hạn khi tính khoảng tin cậy.
| So sánh | Đo cái gì | Dùng để làm gì |
|---|---|---|
| Độ lệch chuẩn (SD) | Mức phân tán của các giá trị quan sát được quanh trung bình mẫu | Mô tả đặc điểm của mẫu hoặc tổng thể đang có |
| Sai số chuẩn của trung bình (SE/SEM) | Mức chính xác của trung bình mẫu khi dùng để ước lượng trung bình tổng thể | Suy luận thống kê, ví dụ tính khoảng tin cậy 95% |
Công thức của Lee và cộng sự (2015) cho thấy ngay hệ quả khi cỡ mẫu thay đổi. Nếu một nghiên cứu tăng cỡ mẫu từ 50 lên 200 người mà mức đa dạng thật của tổng thể không đổi, độ lệch chuẩn của dữ liệu gần như giữ nguyên, còn sai số chuẩn của trung bình giảm xuống, vì mẫu lớn hơn cho một ước lượng trung bình đáng tin hơn. Trong chương kết quả của luận văn, ghi "độ lệch chuẩn (SEM)" là gộp hai khái niệm vào một ký hiệu, và hội đồng có thể hỏi lại đúng chỗ đó. Trước khi diễn giải độ lệch chuẩn theo hướng này, bạn cũng nên xác định rõ vai trò từng biến trong bộ dữ liệu, bài biến độc lập và biến phụ thuộc trong SPSS là gì giúp bạn làm bước đó trước khi chọn kiểm định.
Có cần tự tính tay độ lệch chuẩn khi đã có phần mềm thống kê không?
Trả lời thẳng: Với bộ dữ liệu luận văn, bạn thường để phần mềm thống kê tính độ lệch chuẩn, nhưng vẫn nên tự tính tay ít nhất một lần trên vài giá trị để hiểu con số đến từ đâu. Hiểu công thức giúp bạn nhận ra khi phần mềm và cách tính tay cho hai kết quả khác nhau, và giải thích được con số đó nếu hội đồng hỏi.
Trong SPSS, IBM (2024a) mô tả trong tài liệu IBM SPSS Statistics 29 Brief Guide cách xem thống kê tóm tắt của từng biến qua thủ tục Frequencies, trong đó có độ lệch chuẩn. IBM (2024b) cho biết thủ tục Explore xuất một bộ chỉ số cố định rộng hơn, gồm cả sai số chuẩn, phương sai, độ lệch chuẩn, giá trị nhỏ nhất và lớn nhất, khoảng biến thiên, khoảng tứ phân vị, độ xiên và độ nhọn. Bài này dừng ở mức khái niệm. Các bước bấm menu, cách chọn giữa Descriptives, Frequencies và Explore, và cách đọc từng cột của bảng kết quả được trình bày riêng trong bài độ lệch chuẩn trong SPSS là gì và đọc thế nào cho đúng.
Một tình huống hay gặp là con số tính tay lệch nhẹ so với con số phần mềm đưa ra. Trong ví dụ của El Omda và Sergent (2024) ở mục công thức, hai cách chia cho ra 2,02 và 1,92 trên cùng một bộ dữ liệu, nên khi gặp khác biệt kiểu này, việc đầu tiên nên kiểm tra là bạn đã chia cho n hay cho n−1.
Khi nào so sánh trực tiếp hai độ lệch chuẩn là sai?
Trả lời thẳng: So sánh trực tiếp độ lệch chuẩn giữa hai bộ dữ liệu chỉ chắc chắn có ý nghĩa khi hai bộ dữ liệu dùng cùng đơn vị đo. Khi đơn vị khác nhau, so hai con số độ lệch chuẩn dễ dẫn tới kết luận sai, và khi trung bình của hai nhóm chênh lệch quá lớn, con số tuyệt đối cũng dễ gây hiểu lầm.
Illowsky và Dean (2025) cùng Lee và cộng sự (2015) đều nhấn mạnh rằng độ lệch chuẩn mang đơn vị giống hệt đơn vị của dữ liệu gốc, khác với phương sai mang đơn vị bình phương. Vì độ lệch chuẩn gắn chặt với đơn vị đo, so độ lệch chuẩn giữa hai biến khác đơn vị không cho một phép so sánh có nghĩa. Nhận định về trường hợp hai trung bình chênh lệch lớn là suy luận rút ra từ chính nguyên tắc đơn vị đó, không phải câu trích trực tiếp từ hai nguồn này.
So độ lệch chuẩn của biến chiều cao đo bằng centimet với biến thu nhập đo bằng triệu đồng không cho thông tin gì hữu ích, vì hai đơn vị hoàn toàn khác nhau. Ngay cả khi cùng đơn vị, nếu nhóm A có trung bình 7 và độ lệch chuẩn 1, còn nhóm B có trung bình 70 và độ lệch chuẩn 5, nhóm B có độ lệch chuẩn lớn hơn về số tuyệt đối nhưng chưa chắc phân tán hơn nhóm A khi xét tương đối. Khi luận văn cần so sánh trung bình giữa nhiều nhóm bằng một kiểm định như ANOVA, đọc đúng độ lệch chuẩn của từng nhóm giúp bạn đánh giá dữ liệu có đủ đồng nhất để chạy kiểm định đó hay không, xem thêm ở bài ANOVA là gì.
Câu hỏi thường gặp
Độ lệch chuẩn là gì, nói ngắn gọn?
Nói ngắn gọn, độ lệch chuẩn cho biết một quan sát điển hình trong tập dữ liệu cách trung bình chung bao xa. Con số càng nhỏ thì dữ liệu càng tập trung, con số càng lớn thì dữ liệu càng trải rộng.
Độ lệch chuẩn bằng 0 nghĩa là gì?
Độ lệch chuẩn bằng 0 nghĩa là mọi giá trị trong tập dữ liệu đều bằng nhau, không có khác biệt nào giữa các quan sát. Trường hợp này rất hiếm với dữ liệu khảo sát thật và thường là dấu hiệu cần kiểm tra lại khâu nhập liệu.
Độ lệch chuẩn âm có tồn tại không?
Không. Phương sai được tính từ tổng các số đã bình phương nên luôn không âm, và căn bậc hai của một số không âm cũng không âm, nên độ lệch chuẩn không bao giờ mang dấu trừ.
Độ lệch chuẩn và phương sai khác nhau thế nào?
Hai chỉ số liên hệ trực tiếp qua một phép tính, vì lấy căn bậc hai của phương sai thì ra độ lệch chuẩn. Độ lệch chuẩn được dùng phổ biến hơn khi báo cáo, vì đơn vị của nó trùng với đơn vị của dữ liệu gốc, trong khi đơn vị của phương sai là bình phương của đơn vị gốc nên khó hình dung.
Độ lệch chuẩn cao có phải lúc nào cũng xấu không?
Không. Độ lệch chuẩn cao chỉ cho biết dữ liệu phân tán rộng, và điều đó có thể phản ánh đúng sự đa dạng thật của mẫu nghiên cứu, chẳng hạn khi khảo sát trải trên nhiều nhóm tuổi hoặc nhiều khu vực, chứ không tự động là dấu hiệu của lỗi thu thập dữ liệu.
MAAS có hỗ trợ phần xử lý số liệu có dùng độ lệch chuẩn trong luận văn không?
Có. Nếu chưa chắc nên báo độ lệch chuẩn hay sai số chuẩn, hoặc nên trình bày chúng ra sao trong bảng thống kê mô tả, bạn hỏi giảng viên hướng dẫn trước. Muốn có người đi cùng suốt phần số liệu thì Hỗ trợ xử lý số liệu luận văn của MAAS có chuyên gia đúng chuyên ngành chạy phân tích trên dữ liệu của bạn và giải thích từng bước. Bạn tự viết phần trình bày kết quả, chuyên gia đọc và góp ý. Buổi tư vấn đầu tiên 15 phút không tính phí, đặt qua trang liên hệ.
Đọc tiếp
- Độ lệch chuẩn trong SPSS là gì và đọc thế nào cho đúng
- Biến độc lập và biến phụ thuộc trong SPSS là gì
- ANOVA là gì
References
- Andrade, C. (2020). Understanding the difference between standard deviation and standard error of the mean, and knowing when to use which. Indian Journal of Psychological Medicine, 42(4), 409-410. https://doi.org/10.1177/0253717620933419
- El Omda, S., & Sergent, S. R. (2024). Standard deviation. StatPearls Publishing / NCBI Bookshelf. https://www.ncbi.nlm.nih.gov/sites/books/NBK574574/
- IBM. (2024a). IBM SPSS Statistics 29 brief guide [PDF]. https://www.ibm.com/docs/en/SSLVMB_29.0.0/pdf/IBM_SPSS_Statistics_Brief_Guide.pdf
- IBM. (2024b). Explore statistics. IBM SPSS Statistics documentation. https://www.ibm.com/docs/en/spss-statistics/saas?topic=explore-statistics
- Illowsky, B., & Dean, S. (Eds.). (2025). Introduction to statistics (2nd ed.). eCampusOntario Pressbooks. https://ecampusontario.pressbooks.pub/introstats2ed/chapter/2-5-measures-of-variability/
- Lee, D. K., In, J., & Lee, S. (2015). Statistical notes for clinical researchers: Standard deviation and standard error of the mean. Korean Journal of Anesthesiology, 68(3), 220-223. https://pmc.ncbi.nlm.nih.gov/articles/PMC4452664/